
22.1. Геометрия и линейно-алгебраические операции
В разделе Section 2.3 мы ознакомились с основами линейной алгебры и увидели, как она позволяет выразить общие операции преобразования данных. Линейная алгебра — одна из ключевых математических основ, лежащих в основе значительной части работ, выполняемых нами в области глубокого обучения и машинного обучения в целом. Хотя раздел Section 2.3 содержал достаточный набор инструментов для объяснения механики современных моделей глубокого обучения, эта тема гораздо шире. В данном разделе мы углубимся в предмет, уделив внимание геометрической интерпретации операций линейной алгебры и введя несколько фундаментальных понятий, включая собственные значения и собственные векторы.
22.1.1. Геометрия векторов
Прежде всего, мы обсудим два распространённых геометрических толкования векторов: как точек или направлений в пространстве. По своей сути вектор — это список чисел, например, такой, как в приведённом ниже списке Python.
v = [1, 7, 0, 1]
Математики чаще всего записывают это в виде столбцового или строчного вектора, то есть либо в виде
или
Эти объекты часто имеют разные интерпретации: примеры данных представляются в виде столбцов, а веса, используемые для формирования взвешенных сумм, — в виде строк. Однако полезно сохранять гибкость. Как мы описали в Section 2.3, хотя по умолчанию вектор является столбцом, для любой матрицы, представляющей табличный набор данных, более принято рассматривать каждый пример данных как строку матрицы.
Первым и основным способом интерпретации вектора является представление его в виде точки в пространстве. В двумерном или трёхмерном пространстве мы можем визуализировать эти точки, используя компоненты векторов для определения их положения относительно фиксированной точки, называемой началом координат. Это показано на рисунке Fig. 22.1.1.
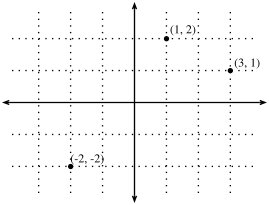
Fig. 22.1.1 Иллюстрация визуализации векторов в виде точек на плоскости. Первый компонент вектора определяет координату \(\mathit{x}\), второй компонент — координату \(\mathit{y}\). В более высоких размерностях ситуация аналогична, хотя визуализировать их значительно сложнее.
Этот геометрический подход позволяет рассматривать задачу на более абстрактном уровне. Отбросив кажущиеся непреодолимыми проблемы, такие как классификация изображений на кошек и собак, мы можем абстрактно рассматривать задачи как множества точек в пространстве и представлять их как поиск способа разделения двух различных кластеров точек.
Параллельно существует и вторая точка зрения на векторы, которую часто используют: как на направления в пространстве. Мы можем рассматривать вектор \(\mathbf{v} = [3,2]^\top\) не только как положение, находящееся на \(3\) единиц правее и на \(2\) единиц выше начала координат, но и как само направление, по которому нужно сделать \(3\) шага вправо и \(2\) шагов вверх. Таким образом, мы считаем все векторы на рисунке Fig. 22.1.2 одинаковыми.
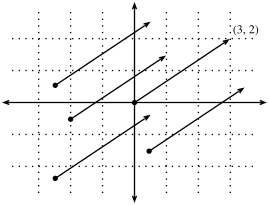
Fig. 22.1.2 Любой вектор можно представить в виде стрелки на плоскости. В этом случае каждая нарисованная стрелка является представлением вектора \((3,2)^\top\).
Одним из преимуществ такого подхода является возможность наглядно представить сложение векторов. В частности, мы следуем направлению, заданному одним вектором, а затем направлению, заданному другим, как показано на рисунке Fig. 22.1.3.
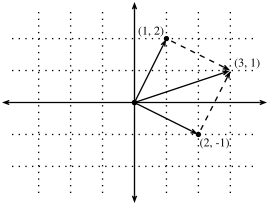
Fig. 22.1.3 Мы можем визуализировать сложение векторов, сначала пройдя вдоль одного вектора, а затем вдоль другого.
Вычитание векторов имеет аналогичную интерпретацию. Рассматривая тождество \(\mathbf{u} = \mathbf{v} + (\mathbf{u}-\mathbf{v})\), мы видим, что вектор \(\mathbf{u}-\mathbf{v}\) указывает направление, в котором мы переходим из точки \(\mathbf{v}\) в точку \(\mathbf{u}\).
22.1.2. Скалярные произведения и углы
Как мы видели в Section 2.3, если взять два столбцовых вектора \(\mathbf{u}\) и \(\mathbf{v}\), их скалярное произведение можно вычислить следующим образом:
Поскольку (22.1.3) симметричен, мы будем использовать нотацию классического умножения и запишем
чтобы подчеркнуть, что перестановка векторов местами даёт тот же результат.
Скалярное произведение (22.1.3) также допускает геометрическую интерпретацию: оно тесно связано с углом между двумя векторами. Рассмотрим угол, показанный на рисунке Fig. 22.1.4.
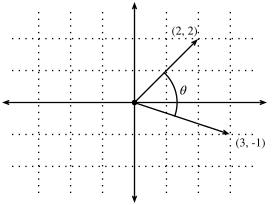
Fig. 22.1.4 Между любыми двумя векторами на плоскости существует определённый угол \(\theta\). Мы увидим, что этот угол тесно связан со скалярным произведением.
Для начала рассмотрим два конкретных вектора:
Вектор \(\mathbf{v}\) имеет длину \(r\) и направлен параллельно оси \(x\), а вектор \(\mathbf{w}\) имеет длину \(s\) и образует угол \(\theta\) с осью \(x\). Если вычислить скалярное произведение этих двух векторов, то мы увидим, что
С помощью несложных алгебраических преобразований мы можем перегруппировать члены, чтобы получить
Короче говоря, для этих двух конкретных векторов скалярное произведение в сочетании с нормами позволяет определить угол между ними. Это утверждение верно и в общем случае. Мы не будем выводить это выражение здесь, однако, если рассмотреть запись \(\|\mathbf{v} - \mathbf{w}\|^2\) двумя способами: один через скалярное произведение, а другой геометрически, используя теорему косинусов, мы сможем получить полную зависимость. Действительно, для любых двух векторов \(\mathbf{v}\) и \(\mathbf{w}\) угол между ними равен
Это хороший результат, поскольку в вычислениях не фигурирует упоминание двумерности. Действительно, мы можем использовать это в трёх измерениях или в пространстве с тремя миллионами измерений без каких-либо проблем.
В качестве простого примера рассмотрим, как вычислить угол между парой векторов:
%matplotlib inline
import torch
import torchvision
from IPython import display
from torchvision import transforms
from d2l import torch as d2l


def angle(v, w):
    return torch.acos(v.dot(w) / (torch.norm(v) * torch.norm(w)))

angle(torch.tensor([0, 1, 2], dtype=torch.float32), torch.tensor([2.0, 3, 4]))
Мы не будем использовать это прямо сейчас, но полезно знать, что векторы, угол между которыми равен \(\pi/2\) (или, что эквивалентно, \(90^{\circ}\)), называются ортогональными. Анализируя приведённое выше уравнение, мы видим, что это происходит, когда \(\theta = \pi/2\), что то же самое, что и \(\cos(\theta) = 0\). Единственный способ этого достичь — если само скалярное произведение равно нулю, и два вектора ортогональны тогда и только тогда, когда \(\mathbf{v}\cdot\mathbf{w} = 0\). Эта формула окажется полезной при геометрическом понимании объектов.
Возникает закономерный вопрос: зачем вычислять угол? Ответ кроется в том типе инвариантности, который мы ожидаем от данных. Рассмотрим изображение и его дубликат, где значения каждого пикселя одинаковы, за исключением \(10\%\) яркости. Значения отдельных пикселей в общем случае сильно отличаются от исходных. Следовательно, если вычислить расстояние между исходным изображением и более темным, это расстояние может оказаться большим. Однако для большинства задач машинного обучения содержимое остается неизменным — для классификатора «кошка/собака» это все ещё изображение кошки. Если же мы рассмотрим угол, то нетрудно заметить, что для любого вектора \(\mathbf{v}\) угол между \(\mathbf{v}\) и \(0.1\cdot\mathbf{v}\) равен нулю. Это соответствует факту, что масштабирование векторов сохраняет их направление, изменяя лишь длину. С точки зрения угла более темное изображение считается идентичным исходному.
Подобные примеры повсюду. В текстовых данных может потребоваться, чтобы тема обсуждения оставалась неизменной, если мы напишем документ в два раза длиннее, но с тем же содержанием. Для некоторых способов кодирования (например, подсчёта количества вхождений слов в некотором словаре) это соответствует удвоению вектора, кодирующего документ, поэтому и в этом случае мы можем использовать угол.
22.1.2.1. Косинусное сходство
В контексте машинного обучения, где угол используется для измерения близости двух векторов, специалисты применяют термин косинусное сходство для обозначения части
Косинусное сходство принимает максимальное значение \(1\), когда два вектора направлены в одну сторону, минимальное значение \(-1\), когда они направлены в противоположные стороны, и значение \(0\), когда два вектора ортогональны. Обратите внимание, что если компоненты высокоразмерных векторов выбираются случайным образом со средним значением \(0\), их косинус почти всегда будет близок к \(0\).
22.1.3. Гиперплоскости
Помимо работы с векторами, другим ключевым объектом, необходимым для глубокого понимания линейной алгебры, является гиперплоскость — обобщение на высшие размерности прямой (в двумерном пространстве) или плоскости (в трёхмерном пространстве). В \(d\)-мерном векторном пространстве гиперплоскость имеет \(d-1\) измерений и делит пространство на два полупространства.
Начнем с примера. Предположим, у нас есть вектор-столбец \(\mathbf{w}=[2,1]^\top\). Нам нужно понять, «какие точки \(\mathbf{v}\) имеют \(\mathbf{w}\cdot\mathbf{v} = 1\)?» Вспоминая связь между скалярным произведением и углами, описанную выше (22.1.8), мы видим, что это эквивалентно
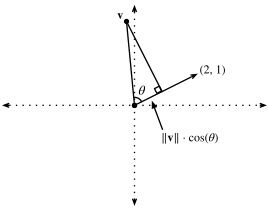
Fig. 22.1.5 Вспоминая тригонометрию, мы видим, что формула \(\|\mathbf{v}\|\cos(\theta)\) задаёт длину проекции вектора \(\mathbf{v}\) на направление \(\mathbf{w}\)
Рассматривая геометрический смысл этого выражения, мы видим, что это эквивалентно утверждению о том, что длина проекции \(\mathbf{v}\) на направление \(\mathbf{w}\) в точности равна \(1/\|\mathbf{w}\|\), как показано на рисунке Fig. 22.1.5. Множество всех точек, для которых это верно, представляет собой прямую, перпендикулярную вектору \(\mathbf{w}\). При желании мы можем найти уравнение этой прямой и убедиться, что оно имеет вид \(2x + y = 1\) или, что эквивалентно, \(y = 1 - 2x\).
Если теперь посмотреть, что происходит при рассмотрении множества точек, удовлетворяющих неравенствам \(\mathbf{w}\cdot\mathbf{v} > 1\) или \(\mathbf{w}\cdot\mathbf{v} < 1\), то видно, что в этих случаях проекции соответственно длиннее или короче, чем \(1/\|\mathbf{w}\|\). Следовательно, эти два неравенства определяют области по обе стороны от прямой. Таким образом, мы нашли способ разделить пространство на две половины, где все точки с одной стороны имеют скалярное произведение ниже порога, а с другой — выше, как показано на рисунке Fig. 22.1.6.
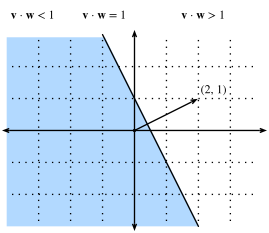
Fig. 22.1.6 Если теперь рассмотреть неравенство, соответствующее этому выражению, мы увидим, что наш гиперплоскость (в данном случае — просто прямая) разделяет пространство на две половины.
В многомерном случае всё обстоит аналогичным образом. Если теперь взять \(\mathbf{w} = [1,2,3]^\top\) и рассмотреть точки в трёхмерном пространстве, удовлетворяющие условию \(\mathbf{w}\cdot\mathbf{v} = 1\), мы получим плоскость, перпендикулярную заданному вектору \(\mathbf{w}\). Два неравенства, как показано на рисунке Fig. 22.1.7, вновь определяют две стороны этой плоскости.
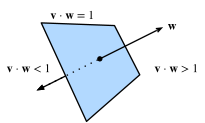
Fig. 22.1.7 Гиперплоскости в любой размерности разделяют пространство на две половины.
Хотя наши возможности визуализации на этом исчерпываются, ничто не мешает нам делать это в десятках, сотнях или миллиардах измерений. Это часто встречается при рассмотрении моделей машинного обучения. Например, мы можем интерпретировать линейные модели классификации, такие как те, что представлены в Section 4.1, как методы поиска гиперплоскостей, разделяющих различные целевые классы. В этом контексте такие гиперплоскости часто называют плоскостями принятия решений. Большинство моделей классификации, обученных с помощью глубокого обучения, завершаются линейным слоем, подаваемым на софтмакс, поэтому можно интерпретировать роль глубокой нейронной сети как поиск нелинейного эмбеддинга, при котором целевые классы могут быть чисто разделены гиперплоскостями.
Чтобы привести конкретный пример, заметим, что мы можем построить разумную модель для классификации крошечных изображений футболок и брюк из набора данных Fashion-MNIST (показанного в Section 4.2), просто взяв вектор между их средними значениями, чтобы определить разделяющую плоскость, и визуально оценив грубый порог. Сначала мы загрузим данные и вычислим средние значения.
# Load in the dataset
trans = []
trans.append(transforms.ToTensor())
trans = transforms.Compose(trans)
train = torchvision.datasets.FashionMNIST(root="../data", transform=trans,
                                          train=True, download=True)
test = torchvision.datasets.FashionMNIST(root="../data", transform=trans,
                                         train=False, download=True)

X_train_0 = torch.stack(
    [x[0] * 256 for x in train if x[1] == 0]).type(torch.float32)
X_train_1 = torch.stack(
    [x[0] * 256 for x in train if x[1] == 1]).type(torch.float32)
X_test = torch.stack(
    [x[0] * 256 for x in test if x[1] == 0 or x[1] == 1]).type(torch.float32)
y_test = torch.stack([torch.tensor(x[1]) for x in test
                      if x[1] == 0 or x[1] == 1]).type(torch.float32)

# Compute averages
ave_0 = torch.mean(X_train_0, axis=0)
ave_1 = torch.mean(X_train_1, axis=0)
Бывает полезно рассмотреть эти средние значения более детально, поэтому давайте построим их графики. В данном случае мы видим, что среднее значение действительно напоминает размытое изображение футболки.
# Plot average t-shirt
d2l.set_figsize()
d2l.plt.imshow(ave_0.reshape(28, 28).tolist(), cmap='Greys')
d2l.plt.show()
Во втором случае мы снова видим, что среднее изображение напоминает размытый образ брюк.
# Plot average trousers
d2l.plt.imshow(ave_1.reshape(28, 28).tolist(), cmap='Greys')
d2l.plt.show()
В полностью автоматизированном решении, основанном на машинном обучении, мы бы обучили порог на основе набора данных. В данном случае я просто вручную подобрал порог, который хорошо работал на обучающих данных.
# Print test set accuracy with eyeballed threshold
w = (ave_1 - ave_0).T
# '@' is Matrix Multiplication operator in pytorch.
predictions = X_test.reshape(2000, -1) @ (w.flatten()) > -1500000

# Accuracy
torch.mean((predictions.type(y_test.dtype) == y_test).float(), dtype=torch.float64)
22.1.4. Геометрия линейных преобразований
Изучив материал Section 2.3 и рассмотрев вышесказанное, мы получили чёткое представление о геометрии векторов, длин и углов. Однако мы упустили из виду один важный объект, а именно геометрическую интерпретацию линейных преобразований, задаваемых матрицами. Полное осознание того, как матрицы могут преобразовывать данные между двумя потенциально различными пространствами высокой размерности, требует значительной практики и выходит за рамки данного приложения. Тем не менее, мы можем начать формировать интуицию на примере двумерного пространства.
Предположим, у нас есть некоторая матрица:
Если мы хотим применить это к произвольному вектору \(\mathbf{v} = [x, y]^\top\), мы умножаем и видим, что
Это может показаться странным вычислением, в котором нечто ясное стало несколько непонятным. Однако оно показывает, что мы можем описать, как матрица преобразует любой вектор, через то, как она преобразует два конкретных вектора: \([1,0]^\top\) и \([0,1]^\top\). Это стоит рассмотреть немного подробнее. По сути, мы свели бесконечную задачу (что происходит с любой парой действительных чисел) к конечной (что происходит с этими конкретными векторами). Эти векторы являются примером базиса, в котором любой вектор в нашем пространстве можно представить как взвешенную сумму этих базисных векторов.
Давайте изобразим, что происходит, когда мы используем конкретную матрицу
Рассмотрим конкретный вектор \(\mathbf{v} = [2, -1]^\top\): мы видим, что это \(2\cdot[1,0]^\top + -1\cdot[0,1]^\top\), и, следовательно, знаем, что матрица \(A\) отобразит его в \(2(\mathbf{A}[1,0]^\top) + -1(\mathbf{A}[0,1])^\top = 2[1, -1]^\top - [2,3]^\top = [0, -5]^\top\). Если внимательно проследить эту логику, например, рассмотрев сетку всех целочисленных пар точек, то станет ясно, что матричное умножение может искажать, вращать и масштабировать сетку, но её структура должна оставаться такой, как показано на рисунке Fig. 22.1.8.
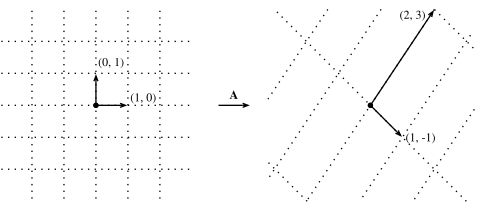
Fig. 22.1.8 Матрица \(\mathbf{A}\) действует на заданные базисные векторы. Обратите внимание, как вся сетка перемещается вместе с ними.
Это самый важный интуитивный момент, который необходимо усвоить о линейных преобразованиях, задаваемых матрицами. Матрицы не способны искажать различные области пространства по-разному. Они могут лишь преобразовывать исходные координаты нашего пространства, изменяя их посредством сдвига, поворота и масштабирования.
Некоторые искажения могут быть значительными. Например, матрица
сжимает всю двумерную плоскость до одной линии. Выявление и работа с такими преобразованиями будут рассмотрены в более позднем разделе, но геометрически мы видим, что это принципиально отличается от типов преобразований, которые мы рассматривали выше. Например, результат, полученный с помощью матрицы \(\mathbf{A}\), можно «вернуть» к исходной сетке. Результаты, полученные с помощью матрицы \(\mathbf{B}\), вернуть нельзя, поскольку мы никогда не узнаем, откуда взялся вектор \([1,2]^\top\): был ли это \([1,1]^\top\) или \([0, -1]^\top\)?
Хотя эта иллюстрация приведена для \(2\times2\) матрицы, ничто не мешает нам перенести полученные знания в более высокие размерности. Если мы возьмем аналогичные базисные векторы, такие как \([1,0, \ldots,0]\), и посмотрим, куда их переводит наша матрица, мы сможем начать понимать, как матричное умножение искажает всё пространство в любой размерности, с которой мы имеем дело.
22.1.5. Линейная зависимость
Рассмотрим снова матрицу
Это сжимает всю плоскость до одной прямой \(y = 2x\). Возникает вопрос: можем ли мы обнаружить это, просто глядя на саму матрицу? Ответ — да, можем. Пусть \(\mathbf{b}_1 = [2,4]^\top\) и \(\mathbf{b}_2 = [-1, -2]^\top\) будут двумя столбцами матрицы \(\mathbf{B}\). Напомним, что любое преобразование, выполняемое матрицей \(\mathbf{B}\), можно записать как взвешенную сумму столбцов матрицы, например, как \(a_1\mathbf{b}_1 + a_2\mathbf{b}_2\). Мы называем это линейной комбинацией. Тот факт, что \(\mathbf{b}_1 = -2\cdot\mathbf{b}_2\), означает, что любую линейную комбинацию этих двух столбцов можно выразить исключительно через, скажем, \(\mathbf{b}_2\), поскольку
Это означает, что один из столбцов в некотором смысле избыточен, поскольку он не задаёт уникального направления в пространстве. Это не должно нас удивлять, поскольку мы уже видели, что данная матрица сводит всю плоскость к одной прямой. Более того, линейная зависимость \(\mathbf{b}_1 = -2\cdot\mathbf{b}_2\) отражает это. Чтобы сделать запись более симметричной относительно двух векторов, запишем это следующим образом:
В общем случае мы будем говорить, что набор векторов \(\mathbf{v}_1, \ldots, \mathbf{v}_k\) является линейно зависимым, если существуют коэффициенты \(a_1, \ldots, a_k\), не равные одновременно нулю, такие что
В этом случае мы можем выразить один из векторов через линейную комбинацию остальных, что по сути делает его избыточным. Таким образом, линейная зависимость столбцов матрицы свидетельствует о том, что матрица сжимает пространство до меньшей размерности. Если линейной зависимости нет, мы говорим, что векторы линейно независимы. Если столбцы матрицы линейно независимы, сжатие не происходит, и операцию можно обратить.
22.1.6. Ранг
Если у нас есть произвольная \(n\times m\) матрица, естественно задать вопрос, в пространство какой размерности она отображает. Ответом на этот вопрос будет понятие, известное как ранг. В предыдущем разделе мы отметили, что линейная зависимость свидетельствует о сжатии пространства в пространство меньшей размерности, и поэтому мы сможем использовать это для определения понятия ранга. В частности, ранг матрицы \(\mathbf{A}\) — это наибольшее число линейно независимых столбцов среди всех подмножеств столбцов. Например, матрица
имеет \(\textrm{rank}(B)=1\), поскольку два столбца линейно зависимы, но каждый из них по отдельности не является линейно зависимым. Для более сложного примера мы можем рассмотреть
и покажем, что \(\mathbf{C}\) имеет ранг два, поскольку, например, первые два столбца линейно независимы, однако любые три из четырёх столбцов линейно зависимы.
Описанный выше подход крайне неэффективен. Он требует рассмотрения всех подмножеств столбцов заданной матрицы, что потенциально приводит к экспоненциальной сложности по числу столбцов. Позже мы рассмотрим более эффективный с вычислительной точки зрения способ вычисления ранга матрицы, но пока этого достаточно, чтобы убедиться, что понятие определено корректно, и понять его смысл.
22.1.7. Обратимость
Мы видели выше, что умножение на матрицу с линейно зависимыми столбцами необратимо, то есть не существует обратной операции, которая всегда могла бы восстановить исходные данные. Однако умножение на матрицу полного ранга (то есть на \(\mathbf{A}\), являющуюся \(n \times n\) матрицей ранга \(n\)) всегда должно быть обратимым. Рассмотрим матрицу
которая представляет собой матрицу с единицами на диагонали и нулями в остальных элементах. Мы называем её единичной матрицей. Это матрица, которая оставляет наши данные неизменными при применении. Чтобы найти матрицу, которая отменяет действие нашей матрицы \(\mathbf{A}\), нам нужно найти матрицу \(\mathbf{A}^{-1}\) такую, что
Если рассматривать это как систему, то у нас есть \(n \times n\) неизвестных (элементы матрицы \(\mathbf{A}^{-1}\)) и \(n \times n\) уравнений (условие равенства между каждым элементом произведения \(\mathbf{A}^{-1}\mathbf{A}\) и каждым элементом матрицы \(\mathbf{I}\)), поэтому в общем случае следует ожидать существования решения. Действительно, в следующем разделе мы рассмотрим величину, называемую определителем, которая обладает тем свойством, что если определитель не равен нулю, то решение можно найти. Мы называем такую матрицу \(\mathbf{A}^{-1}\) обратной матрицей. В качестве примера, если \(\mathbf{A}\) является общей \(2 \times 2\) матрицей
тогда мы видим, что обратная матрица имеет вид
Мы можем проверить это, убедившись, что умножение на обратную матрицу, заданную приведённой выше формулой, работает на практике.
M = torch.tensor([[1, 2], [1, 4]], dtype=torch.float32)
M_inv = torch.tensor([[2, -1], [-0.5, 0.5]])
M_inv @ M
22.1.7.1. Численные вопросы
Хотя обратная матрица полезна в теории, на практике мы обычно не используем её напрямую для решения задач. Как правило, существуют гораздо более численно устойчивые алгоритмы решения линейных уравнений, таких как
чем вычисление обратной матрицы и умножение для получения
Так же, как деление на малое число может привести к численной неустойчивости, так и обращение матрицы, близкой к вырожденной (имеющей низкий ранг), может вызвать ту же проблему.
Более того, матрица \(\mathbf{A}\) часто бывает разреженной, то есть содержит лишь небольшое количество ненулевых значений. Если бы мы рассмотрели примеры, то увидели бы, что это не означает, что обратная матрица также разрежена. Даже если \(\mathbf{A}\) представляла собой матрицу размера \(1\) на \(1\) миллиона с лишь \(5\) миллионами ненулевых элементов (и, следовательно, нам нужно хранить только эти \(5\) миллионов), обратная матрица, как правило, будет иметь почти все элементы ненулевыми, что потребует хранения всех \(1\textrm{M}^2\) элементов, то есть \(1\) триллионов элементов!
Хотя у нас нет времени подробно разбирать сложные численные проблемы, с которыми часто сталкиваются при работе с линейной алгеброй, мы хотим дать вам некоторое представление о том, когда следует проявлять осторожность. В целом, хорошим практическим правилом является избегание обращения матриц.
22.1.8. Определитель
Геометрический взгляд на линейную алгебру позволяет интуитивно интерпретировать фундаментальную величину, известную как определитель. Рассмотрим сетчатое изображение из предыдущего примера, но теперь с выделенной областью (Fig. 22.1.9).
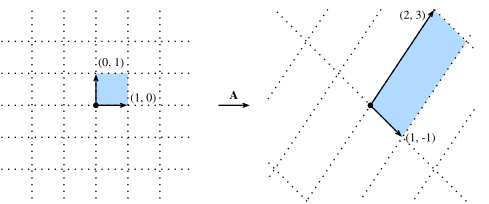
Fig. 22.1.9 Матрица \(\mathbf{A}\) снова искажает сетку. На этот раз я хочу обратить особое внимание на то, что происходит с выделенным квадратом.
Рассмотрим выделенный квадрат. Это квадрат, стороны которого задаются векторами \((0, 1)\) и \((1, 0)\), поэтому его площадь равна единице. После преобразования \(\mathbf{A}\) этот квадрат превращается в параллелограмм. Нет причин полагать, что площадь этого параллелограмма должна совпадать с исходной, и, действительно, в конкретном случае, показанном здесь,
Вычисление площади этого параллелограмма — это упражнение по аналитической геометрии, в результате которого мы получаем, что площадь равна \(5\).
В общем случае, если у нас есть матрица
мы можем видеть, что в результате вычислений площадь получившегося параллелограмма равна \(ad-bc\). Эта площадь называется определителем.
Давайте быстро проверим это с помощью примера кода.
torch.det(torch.tensor([[1, -1], [2, 3]], dtype=torch.float32))
Зоркие читатели заметят, что это выражение может быть равно нулю или даже отрицательным. Что касается отрицательного значения, то это вопрос соглашения, принятого в математике: если матрица отражает фигуру, мы говорим, что площадь становится отрицательной. Теперь посмотрим, что происходит, когда определитель равен нулю.
Рассмотрим
Если вычислить определитель этой матрицы, получим \(2\cdot(-2 ) - 4\cdot(-1) = 0\). Учитывая наше предыдущее понимание, это вполне логично. \(\mathbf{B}\) сжимает квадрат из исходного изображения до отрезка прямой, площадь которого равна нулю. И действительно, сжатие в пространство меньшей размерности — единственный способ получить нулевую площадь после преобразования. Таким образом, мы видим, что верно следующее утверждение: матрица \(A\) обратима тогда и только тогда, когда её определитель не равен нулю.
В качестве заключительного замечания представим, что на плоскости нарисована произвольная фигура. Мысля как компьютерные ученые, мы можем разбить эту фигуру на набор маленьких квадратов так, чтобы площадь фигуры по сути равнялась количеству квадратов в этом разбиении. Если теперь преобразовать эту фигуру с помощью матрицы, то каждый из этих квадратов перейдет в параллелограмм, площадь которого определяется определителем. Таким образом, для любой фигуры определитель показывает, во сколько раз (с учётом знака) матрица изменяет площадь фигуры.
Вычисление определителей для больших матриц может быть трудоёмким, но интуиция остаётся той же. Определитель по-прежнему является множителем, на который матрицы масштабируют объёмы в \(n\times n\)-мерном пространстве \(n\).
22.1.9. Тензоры и основные операции линейной алгебры
В Section 2.3 было введено понятие тензоров. В этом разделе мы подробнее рассмотрим тензорные свёртки (тензорный аналог матричного умножения) и увидим, как они позволяют получить единый взгляд на множество операций с матрицами и векторами.
Работая с матрицами и векторами, мы уже умели умножать их для преобразования данных. Чтобы тензоры были полезны, нам нужно дать им аналогичное определение. Вспомним матричное умножение:
или, что эквивалентно
Этот подход можно повторить для тензоров. Для тензоров не существует единого универсального правила выбора того, по чему суммировать, поэтому нам необходимо точно указать, по каким индексам мы хотим выполнить суммирование. Например, мы можем рассмотреть
Такая операция называется свёрткой тензора. Она представляет собой гораздо более гибкий класс преобразований, чем матричное умножение.
В качестве часто используемого упрощения обозначений отметим, что суммирование производится именно по тем индексам, которые встречаются в выражении более одного раза. Поэтому часто используют суммирование по Эйнштейну, при котором суммирование по всем повторяющимся индексам подразумевается неявно. Это позволяет записать выражение в компактном виде:
22.1.9.1. Общие примеры из линейной алгебры
Рассмотрим, сколько из ранее встречавшихся определений линейной алгебры можно выразить в этой компактной тензорной нотации:
\(\mathbf{v} \cdot \mathbf{w} = \sum_i v_iw_i\)
\(\|\mathbf{v}\|_2^{2} = \sum_i v_iv_i\)
\((\mathbf{A}\mathbf{v})_i = \sum_j a_{ij}v_j\)
\((\mathbf{A}\mathbf{B})_{ik} = \sum_j a_{ij}b_{jk}\)
\(\textrm{tr}(\mathbf{A}) = \sum_i a_{ii}\)
Таким образом, мы можем заменить множество специализированных обозначений короткими тензорными выражениями.
22.1.9.2. Выражение в коде
Тензоры также можно гибко обрабатывать в коде. Как показано в Section 2.3, мы можем создавать тензоры следующим образом.
# Define tensors
B = torch.tensor([[[1, 2, 3], [4, 5, 6]], [[7, 8, 9], [10, 11, 12]]])
A = torch.tensor([[1, 2], [3, 4]])
v = torch.tensor([1, 2])

# Print out the shapes
A.shape, B.shape, v.shape
Суммирование по Эйнштейну реализовано напрямую. Индексы, участвующие в суммировании по Эйнштейну, передаются в виде строки, за которой следуют тензоры, над которыми выполняется операция. Например, чтобы реализовать матричное умножение, можно взять рассмотренное выше суммирование по Эйнштейну (\(\mathbf{A}\mathbf{v} = a_{ij}v_j\)) и убрать сами индексы, получив следующую реализацию:
# Reimplement matrix multiplication
torch.einsum("ij, j -> i", A, v), A@v
Это очень гибкая нотация. Например, если мы хотим вычислить то, что традиционно записывается как
Это можно реализовать с помощью суммирования Эйнштейна следующим образом:
torch.einsum("ijk, il, j -> kl", B, A, v)
Эта нотация удобна для чтения человеком, но громоздка, если по
какой-либо причине нам нужно программно сгенерировать тензорное
сокращение. По этой причине einsum предлагает альтернативную
нотацию, используя целочисленные индексы для каждого тензора. Например,
то же самое тензорное сокращение можно записать так:
# PyTorch does not support this type of notation.
Любая из этих нотаций позволяет компактно и эффективно представлять свёртки тензоров в коде.
22.1.10. Итоги
Векторы можно геометрически интерпретировать как точки или направления в пространстве.
Скалярные произведения определяют понятие угла в пространствах произвольно высокой размерности.
Гиперплоскости — это обобщение линий и плоскостей на пространства произвольной размерности. Их можно использовать для определения разделяющих гиперплоскостей, которые часто применяются на последнем этапе задачи классификации.
Матричное умножение можно геометрически интерпретировать как равномерные искажения базовых координат. Оно представляет собой очень ограниченный, но математически чистый способ преобразования векторов.
Линейная зависимость позволяет определить, когда набор векторов находится в пространстве меньшей размерности, чем можно было бы ожидать (например, у вас есть \(3\) векторов, живущих в \(2\)-мерном пространстве). Ранг матрицы — это размерность наибольшего подмножества её столбцов, которые линейно независимы.
Когда обратная матрица определена, обращение матрицы позволяет найти другую матрицу, которая отменяет действие первой. Обращение матриц полезно в теории, но на практике требует осторожности из-за численной неустойчивости.
Определители позволяют измерить, насколько матрица растягивает или сжимает пространство. nonzero определитель означает, что матрица обратима (невырождена), а нулевой определитель указывает на то, что матрица необратима (вырождена).
Свёртки тензоров и суммирование по Эйнштейну обеспечивают лаконичное и удобное обозначение для выражения многих вычислений, встречающихся в машинном обучении.
22.1.11. Упражнения
Каков угол между
(22.1.35)¶\[\begin{split}\vec v_1 = \begin{bmatrix} 1 \\ 0 \\ -1 \\ 2 \end{bmatrix}, \qquad \vec v_2 = \begin{bmatrix} 3 \\ 1 \\ 0 \\ 1 \end{bmatrix}?\end{split}\]Верно или неверно: \(\begin{bmatrix}1 & 2\\0&1\end{bmatrix}\) и \(\begin{bmatrix}1 & -2\\0&1\end{bmatrix}\) являются обратными друг другу?
Предположим, что мы нарисовали на плоскости фигуру площадью \(100\textrm{m}^2\). Какова будет площадь после преобразования этой фигуры с помощью матрицы
(22.1.36)¶\[\begin{split}\begin{bmatrix} 2 & 3\\ 1 & 2 \end{bmatrix}.\end{split}\]Какие из следующих наборов векторов линейно независимы?
\(\left\{\begin{pmatrix}1\\0\\-1\end{pmatrix}, \begin{pmatrix}2\\1\\-1\end{pmatrix}, \begin{pmatrix}3\\1\\1\end{pmatrix}\right\}\)
\(\left\{\begin{pmatrix}3\\1\\1\end{pmatrix}, \begin{pmatrix}1\\1\\1\end{pmatrix}, \begin{pmatrix}0\\0\\0\end{pmatrix}\right\}\)
\(\left\{\begin{pmatrix}1\\1\\0\end{pmatrix}, \begin{pmatrix}0\\1\\-1\end{pmatrix}, \begin{pmatrix}1\\0\\1\end{pmatrix}\right\}\)
Предположим, что у вас есть матрица, записанная в виде \(A = \begin{bmatrix}c\\d\end{bmatrix}\cdot\begin{bmatrix}a & b\end{bmatrix}\) для некоторого набора значений \(a, b, c\) и \(d\). Верно или неверно, что определитель такой матрицы всегда равен \(0\)?
Векторы \(e_1 = \begin{bmatrix}1\\0\end{bmatrix}\) и \(e_2 = \begin{bmatrix}0\\1\end{bmatrix}\) ортогональны. Какое условие должно выполняться для матрицы \(A\), чтобы векторы \(Ae_1\) и \(Ae_2\) были ортогональны?
Как записать \(\textrm{tr}(\mathbf{A}^4)\) в обозначениях Эйнштейна для произвольной матрицы \(A\)?