
22.6. Случайные величины
В разделе Section 2.6 мы рассмотрели основы работы с дискретными случайными величинами, которые в нашем контексте принимают либо конечное множество возможных значений, либо целые числа. В этом разделе мы развиваем теорию непрерывных случайных величин, которые могут принимать любые действительные значения.
22.6.1. Непрерывные случайные величины
Непрерывные случайные величины — тема значительно более тонкая, чем дискретные. Уместно провести следующую аналогию: технический скачок здесь сопоставим со скачком между сложением списков чисел и интегрированием функций. Поэтому нам потребуется уделить время разработке теории.
22.6.1.1. От дискретных к непрерывным
Чтобы понять дополнительные технические трудности, возникающие при работе с непрерывными случайными величинами, проведем мысленный эксперимент. Предположим, что мы бросаем дротик в мишень и хотим узнать вероятность того, что он попадет точно в точку \(2 \textrm{cm}\) от центра мишени.
Для начала представим, что мы измеряем точность до одной единицы, то есть используем интервалы \(0 \textrm{cm}\), \(1 \textrm{cm}\), \(2 \textrm{cm}\) и так далее. Мы бросаем, скажем, \(100\) дротиков в мишень, и если \(20\) из них попадают в интервал \(2\textrm{cm}\), то делаем вывод, что \(20\%\) дротиков попадают в мишень на расстоянии \(2 \textrm{cm}\) от центра.
Однако, если посмотреть внимательнее, это не соответствует нашему вопросу! Мы хотели точного равенства, тогда как эти интервалы содержат все значения, попавшие, например, между \(1.5\textrm{cm}\) и \(2.5\textrm{cm}\).
Не останавливаясь на этом, мы продолжаем. Мы измеряем ещё точнее, например \(1.9\textrm{cm}\), \(2.0\textrm{cm}\), \(2.1\textrm{cm}\), и теперь видим, что, возможно, \(3\) из \(100\) дротиков попали в доску в \(2.0\textrm{cm}\) интервал. Таким образом, мы заключаем, что вероятность равна \(3\%\).
Однако это ничего не решает! Мы лишь отодвинули проблему на один разряд дальше. Давайте немного абстрагируемся. Предположим, мы знаем вероятность того, что первые \(k\) цифр совпадают с \(2.00000\ldots\), и хотим узнать вероятность совпадения первых \(k+1\) цифр. Вполне разумно предположить, что \({k+1}^{\textrm{th}}\) цифра по сути является случайным выбором из множества \(\{0, 1, 2, \ldots, 9\}\). По крайней мере, мы не можем представить физически осмысленный процесс, который заставлял бы количество микрометров от центра предпочитать окончание на \(7\), а не на \(3\).
Это означает, что по сути каждая дополнительная цифра точности, которую мы требуем, должна уменьшать вероятность совпадения в \(10\) раз. Или, иными словами, мы ожидаем, что
Значение \(p\) по сути кодирует поведение первых нескольких цифр, а \(10^{-k}\) — остальных.
Заметим, что если мы знаем положение с точностью до \(k=4\) знаков после запятой, это означает, что мы знаем, что значение попадает в интервал, скажем, \([1.99995,2.00005]\), который имеет длину \(2.00005-1.99995 = 10^{-4}\). Таким образом, если обозначить длину этого интервала как \(\epsilon\), мы можем сказать
Сделаем ещё один шаг. Все это время мы думали о точке \(2\), но не рассматривали другие точки. Фундаментально здесь ничего не меняется, однако значение \(p\), скорее всего, будет иным. Мы бы по крайней мере надеялись, что метатель дротиков с большей вероятностью попадет в точку, близкую к центру, например, в \(2\textrm{cm}\), а не в \(20\textrm{cm}\). Таким образом, значение \(p\) не является фиксированным, а должно зависеть от точки \(x\). Это говорит нам о том, что мы должны ожидать
Действительно, (22.6.3) точно определяет функцию плотности вероятности. Это функция \(p(x)\), которая кодирует относительную вероятность попадания в окрестность одной точки по сравнению с другой. Давайте визуализируем, как может выглядеть такая функция.
%matplotlib inline
import torch
from IPython import display
from d2l import torch as d2l

torch.pi = torch.acos(torch.zeros(1)).item() * 2  # Define pi in torch

# Plot the probability density function for some random variable
x = torch.arange(-5, 5, 0.01)
p = 0.2*torch.exp(-(x - 3)**2 / 2)/torch.sqrt(2 * torch.tensor(torch.pi)) + \
    0.8*torch.exp(-(x + 1)**2 / 2)/torch.sqrt(2 * torch.tensor(torch.pi))

d2l.plot(x, p, 'x', 'Density')
Места, где значение функции велико, указывают на области, где мы с большей вероятностью можем найти случайное значение. Низкие участки — это области, где вероятность найти случайное значение мала.
22.6.1.2. Функции плотности вероятности
Теперь рассмотрим этот вопрос более подробно. Мы уже интуитивно понимали, что такое функция плотности вероятности для случайной величины \(X\), а именно: функция плотности — это функция \(p(x)\), такая что
Но что это означает для свойств \(p(x)\)?
Во-первых, вероятности никогда не бывают отрицательными, поэтому мы ожидаем, что \(p(x) \ge 0\).
Во-вторых, представим, что мы разбиваем \(\mathbb{R}\) на бесконечное число срезов ширины \(\epsilon\), например, срезы \((\epsilon\cdot i, \epsilon \cdot (i+1)]\). Для каждого из них, как следует из (22.6.4), вероятность приблизительно равна
тогда, просуммировав по всем им, мы получим
Это не что иное, как аппроксимация интеграла, рассмотренная в Section 22.5, поэтому мы можем сказать, что
Мы знаем, что \(P(X\in\mathbb{R}) = 1\), поскольку случайная величина должна принимать какое-то значение, мы можем заключить, что для любой плотности
Действительно, более тщательный анализ показывает, что для любого \(a\) и \(b\) выполняется следующее:
Мы можем аппроксимировать это в коде, используя те же методы дискретного приближения, что и раньше. В данном случае мы можем оценить вероятность попадания в синюю область.
# Approximate probability using numerical integration
epsilon = 0.01
x = torch.arange(-5, 5, 0.01)
p = 0.2*torch.exp(-(x - 3)**2 / 2) / torch.sqrt(2 * torch.tensor(torch.pi)) +\
    0.8*torch.exp(-(x + 1)**2 / 2) / torch.sqrt(2 * torch.tensor(torch.pi))

d2l.set_figsize()
d2l.plt.plot(x, p, color='black')
d2l.plt.fill_between(x.tolist()[300:800], p.tolist()[300:800])
d2l.plt.show()

f'approximate Probability: {torch.sum(epsilon*p[300:800])}'
Оказывается, эти два свойства в точности описывают пространство возможных функций плотности вероятности (или p.d.f. — общепринятое сокращение). Это неотрицательные функции \(p(x) \ge 0\), такие что
Мы интерпретируем эту функцию, используя интегрирование для вычисления вероятности того, что наша случайная величина попадает в заданный интервал:
В Section 22.8 мы рассмотрим ряд распространённых распределений, но пока продолжим работать в абстрактной постановке.
22.6.1.3. Функции распределения
В предыдущем разделе мы рассмотрели понятие функции плотности вероятности (p.d.f.). На практике это распространённый способ описания непрерывных случайных величин, однако у него есть один существенный недостаток: значения функции плотности вероятности сами по себе не являются вероятностями, а представляют собой функцию, интеграл от которой даёт вероятность. Ничего страшного нет в том, что плотность превышает \(10\), при условии, что она не превышает \(10\) на интервале длиной больше \(1/10\). Это может показаться контринтуитивным, поэтому люди часто используют также функцию распределения, или к.р.ф. (c.d.f.), которая является вероятностью.
В частности, используя (22.6.11), мы определяем функцию распределения случайной величины \(X\) с плотностью \(p(x)\) как
Рассмотрим несколько свойств.
\(F(x) \rightarrow 0\) как \(x\rightarrow -\infty\).
\(F(x) \rightarrow 1\) как \(x\rightarrow \infty\).
\(F(x)\) является неубывающей функцией (\(y > x \implies F(y) \ge F(x)\)).
\(F(x)\) является непрерывной (не имеет разрывов), если \(X\) — непрерывная случайная величина.
Обратите внимание на четвёртый пункт: это утверждение не было бы верным, если бы \(X\) было дискретным, например, принимало значения \(0\) и \(1\) с вероятностью \(1/2\). В этом случае
В этом примере мы видим одно из преимуществ работы с к.р.ф.: возможность оперировать непрерывными и дискретными случайными величинами в едином фреймворке, а также их смесью (подбросьте монету: если выпадет орёл, бросьте кубик; если решка — измерьте расстояние от попадания дротика до центра мишени).
22.6.1.4. Математические ожидания
Предположим, что мы имеем дело со случайной величиной \(X\). Сама функция распределения может быть сложной для интерпретации. Часто полезно уметь кратко описывать поведение случайной величины. Числа, которые помогают нам охарактеризовать поведение случайной величины, называются описательными статистиками. Наиболее часто встречающимися из них являются математическое ожидание, дисперсия и стандартное отклонение.
Среднее кодирует среднее значение случайной величины. Если у нас есть дискретная случайная величина \(X\), которая принимает значения \(x_i\) с вероятностями \(p_i\), то среднее вычисляется как взвешенное среднее: сумма произведений значений на вероятность того, что случайная величина принимает это значение:
Среднее значение (хотя и с осторожностью) следует интерпретировать так: оно указывает, где в основном располагается случайная величина.
В качестве простого примера, который мы будем рассматривать в течение этого раздела, пусть \(X\) будет случайной величиной, принимающей значение \(a-2\) с вероятностью \(p\), значение \(a+2\) с вероятностью \(p\) и значение \(a\) с вероятностью \(1-2p\). Используя (22.6.14), мы можем вычислить, что для любого возможного выбора \(a\) и \(p\) среднее значение равно
Таким образом, мы видим, что математическое ожидание равно \(a\). Это соответствует интуиции, поскольку \(a\) — это точка, вокруг которой мы центрировали нашу случайную величину.
Поскольку они полезны, давайте кратко перечислим несколько их свойств.
Для любой случайной величины \(X\) и чисел \(a\) и \(b\) выполняется равенство \(\mu_{aX+b} = a\mu_X + b\).
Если у нас есть две случайные величины \(X\) и \(Y\), то имеем \(\mu_{X+Y} = \mu_X+\mu_Y\).
Средние значения полезны для понимания среднего поведения случайной величины, однако одного среднего недостаточно даже для формирования полного интуитивного представления. Получение прибыли в \(\$10 \pm \$1\) с каждой продажи сильно отличается от получения прибыли в \(\$10 \pm \$15\) с каждой продажи, несмотря на то, что их средние значения одинаковы. Во втором случае степень колебаний значительно выше, а значит, и риски существенно больше. Таким образом, чтобы понять поведение случайной величины, нам потребуется как минимум одна дополнительная мера: некоторая характеристика, показывающая, насколько широко колеблется случайная величина.
22.6.1.5. Дисперсии
Это подводит нас к рассмотрению дисперсии случайной величины. Дисперсия — это количественная мера того, насколько сильно случайная величина отклоняется от своего среднего значения. Рассмотрим выражение \(X - \mu_X\). Оно представляет собой отклонение случайной величины от её среднего. Поскольку это значение может быть как положительным, так и отрицательным, нам необходимо преобразовать его, чтобы оно стало положительным, и тем самым измерять величину отклонения.
Разумным шагом будет рассмотреть \(\left|X-\mu_X\right|\), и действительно, это приводит к полезной величине, называемой средним абсолютным отклонением, однако из-за связей с другими областями математики и статистики чаще используют другой подход.
В частности, они рассматривают \((X-\mu_X)^2.\) Если мы посмотрим на типичный размер этой величины, взяв её среднее значение, то мы придем к дисперсии
Последнее равенство в (22.6.16) следует из раскрытия определения в середине и применения свойств математического ожидания.
Рассмотрим пример, в котором \(X\) — случайная величина, принимающая значение \(a-2\) с вероятностью \(p\), значение \(a+2\) с вероятностью \(p\) и значение \(a\) с вероятностью \(1-2p\). В этом случае \(\mu_X = a\), поэтому нам нужно вычислить только \(E\left[X^2\right]\). Это можно легко сделать:
Таким образом, мы видим, что согласно (22.6.16) наша дисперсия равна
Этот результат снова выглядит логичным. Максимальное значение дисперсии \(p\) равно \(1/2\), что соответствует выбору \(a-2\) или \(a+2\) при подбрасывании монеты. Дисперсия, равная \(4\), отражает тот факт, что как \(a-2\), так и \(a+2\) находятся на расстоянии \(2\) единиц от среднего значения, а \(2^2 = 4\). С другой стороны, если \(p=0\), эта случайная величина всегда принимает значение \(0\), поэтому её дисперсия равна нулю.
Ниже приведём несколько свойств дисперсии:
Для любой случайной величины \(X\), \(\textrm{Var}(X) \ge 0\), дисперсия равна нулю \(\textrm{Var}(X) = 0\) тогда и только тогда, когда \(X\) является константой.
Для любой случайной величины \(X\) и чисел \(a\) и \(b\) выполняется равенство \(\textrm{Var}(aX+b) = a^2\textrm{Var}(X)\).
Если у нас есть две независимые случайные величины \(X\) и \(Y\), то выполняется \(\textrm{Var}(X+Y) = \textrm{Var}(X) + \textrm{Var}(Y)\).
При интерпретации этих значений возникает небольшая трудность. В частности, давайте представим, что происходит, если отслеживать единицы измерения в ходе вычислений. Предположим, что мы работаем со звездным рейтингом товара на веб-странице. Тогда \(a\), \(a-2\) и \(a+2\) измеряются в звездах. Аналогично, среднее значение \(\mu_X\) также измеряется в звездах (поскольку это взвешенное среднее). Однако, когда мы доходим до дисперсии, сразу возникает проблема: мы хотим посмотреть на \((X-\mu_X)^2\), которая измеряется в квадратных звездах. Это означает, что сама дисперсия не сравнима с исходными измерениями. Чтобы сделать её интерпретируемой, нам нужно вернуться к исходным единицам измерения.
22.6.1.6. Стандартные отклонения
Эти сводные статистики всегда можно получить из дисперсии, извлекая квадратный корень! Таким образом, мы определяем стандартное отклонение как
В нашем примере это означает, что стандартное отклонение равно \(\sigma_X = 2\sqrt{2p}\). Если в нашем примере с отзывами мы имеем дело с единицами измерения в виде звёзд, то \(\sigma_X\) также выражается в звёздах.
Свойства дисперсии, которые мы рассматривали ранее, можно переформулировать для стандартного отклонения.
Для любой случайной величины \(X\), \(\sigma_{X} \ge 0\).
Для любой случайной величины \(X\) и чисел \(a\) и \(b\) выполняется, что \(\sigma_{aX+b} = |a|\sigma_{X}\)
Если у нас есть две независимые случайные величины \(X\) и \(Y\), то выполняется \(\sigma_{X+Y} = \sqrt{\sigma_{X}^2 + \sigma_{Y}^2}\).
В этот момент естественно задать вопрос: «Если стандартное отклонение выражено в единицах исходной случайной величины, можно ли сделать вывод относительно этой случайной величины?» Ответ — безусловно да! Действительно, так же как среднее значение указывает на типичное положение случайной величины, стандартное отклонение определяет типичный диапазон её изменчивости. Мы можем сделать это утверждение строгим, используя так называемое неравенство Чебышёва:
Или, выражаясь словами, в случае \(\alpha=10\), \(99\%\) выборки из любой случайной величины попадают в \(10\) стандартных отклонений от среднего. Это дает нам непосредственную интерпретацию наших стандартных сводных статистик.
Чтобы понять, насколько это утверждение является тонким, давайте ещё раз рассмотрим наш пример, где \(X\) — это случайная величина, принимающая значение \(a-2\) с вероятностью \(p\), \(a+2\) с вероятностью \(p\) и \(a\) с вероятностью \(1-2p\). Мы видели, что среднее значение равно \(a\), а стандартное отклонение равно \(2\sqrt{2p}\). Это означает, что если мы применим неравенство Чебышёва (22.6.20) с \(\alpha = 2\), то увидим, что выражение
Это означает, что \(75\%\) времени эта случайная величина будет находиться в пределах данного интервала при любом значении \(p\). Теперь обратите внимание, что по мере того как \(p \rightarrow 0\), этот интервал также стягивается к единственной точке \(a\). Но мы знаем, что наша случайная величина принимает только значения \(a-2, a\) и \(a+2\), поэтому в конечном итоге мы можем быть уверены, что \(a-2\) и \(a+2\) окажутся за пределами интервала! Вопрос в том, при каком \(p\) это происходит. Таким образом, нам нужно решить: при каком \(p\) выполняется \(a+4\sqrt{2p} = a+2\), что решается при \(p=1/8\), что в точности является первым \(p\), когда это может произойти, не нарушая нашего утверждения о том, что не более \(1/4\) выборок из распределения окажутся за пределами интервала (\(1/8\) слева и \(1/8\) справа).
Давайте визуализируем это. Мы отобразим вероятность получения трёх значений в виде трёх вертикальных столбцов, высота которых пропорциональна вероятности. Интервал будет изображён горизонтальной линией по центру. На первом графике показано, что происходит при \(p > 1/8\), когда интервал безопасно содержит все точки.
# Define a helper to plot these figures
def plot_chebyshev(a, p):
    d2l.set_figsize()
    d2l.plt.stem([a-2, a, a+2], [p, 1-2*p, p], use_line_collection=True)
    d2l.plt.xlim([-4, 4])
    d2l.plt.xlabel('x')
    d2l.plt.ylabel('p.m.f.')

    d2l.plt.hlines(0.5, a - 4 * torch.sqrt(2 * p),
                   a + 4 * torch.sqrt(2 * p), 'black', lw=4)
    d2l.plt.vlines(a - 4 * torch.sqrt(2 * p), 0.53, 0.47, 'black', lw=1)
    d2l.plt.vlines(a + 4 * torch.sqrt(2 * p), 0.53, 0.47, 'black', lw=1)
    d2l.plt.title(f'p = {p:.3f}')

    d2l.plt.show()

# Plot interval when p > 1/8
plot_chebyshev(0.0, torch.tensor(0.2))
На втором графике показано, что при \(p = 1/8\) интервал точно касается двух точек. Это демонстрирует, что неравенство остро, поскольку никакое меньшее интервал не может быть выбрано при сохранении истинности неравенства.
# Plot interval when p = 1/8
plot_chebyshev(0.0, torch.tensor(0.125))
Третий случай показывает, что при \(p < 1/8\) интервал содержит только центр. Это не опровергает неравенство, поскольку нам требовалось лишь обеспечить, чтобы вероятность попадания за пределы интервала не превышала \(1/4\). Это означает, что при \(p < 1/8\) две точки, расположенные в \(a-2\) и \(a+2\), можно отбросить.
# Plot interval when p < 1/8
plot_chebyshev(0.0, torch.tensor(0.05))
22.6.1.7. Средние значения и дисперсии в непрерывном случае
Всё это было рассмотрено для дискретных случайных величин, но случай непрерывных случайных величин аналогичен. Чтобы интуитивно понять, как это работает, представим, что мы разбиваем числовую прямую на интервалы длины \(\epsilon\), задаваемые выражением \((\epsilon i, \epsilon (i+1)]\). После этого наша непрерывная случайная величина становится дискретной, и мы можем использовать (22.6.14), чтобы сказать, что
где \(p_X\) — плотность распределения \(X\). Это приближение интеграла от \(xp_X(x)\), поэтому можно заключить, что
Аналогично, используя (22.6.16), дисперсию можно записать как
Всё сказанное выше о среднем, дисперсии и стандартном отклонении по-прежнему справедливо в этом случае. Например, если мы рассмотрим случайную величину с плотностью
мы можем вычислить
и
В качестве предостережения рассмотрим ещё один пример, известный как распределение Коши. Это распределение с функцией плотности вероятности, заданной формулой
# Plot the Cauchy distribution p.d.f.
x = torch.arange(-5, 5, 0.01)
p = 1 / (1 + x**2)

d2l.plot(x, p, 'x', 'p.d.f.')
Эта функция выглядит безобидно, и, действительно, обращение к таблице интегралов показывает, что площадь под ней равна единице, а значит, она определяет непрерывную случайную величину.
Чтобы понять, где возникает ошибка, попробуем вычислить дисперсию этого. Для этого потребуется использовать (22.6.16) вычисление
Функция внутри выглядит так:
# Plot the integrand needed to compute the variance
x = torch.arange(-20, 20, 0.01)
p = x**2 / (1 + x**2)

d2l.plot(x, p, 'x', 'integrand')
Эта функция имеет бесконечную площадь под графиком, поскольку по существу она равна константе с небольшим провалом вблизи нуля, и, действительно, мы можем показать, что
Это означает, что она не имеет определённой конечной дисперсии.
Однако более глубокий анализ приводит к ещё более тревожному результату. Попробуем вычислить среднее значение, используя (22.6.14). Применяя формулу замены переменных, получаем
Интеграл внутри представляет собой определение логарифма, поэтому по сути это \(\log(\infty) = \infty\), а значит, и среднее значение также не определено!
Ученые в области машинного обучения строят свои модели так, что в большинстве случаев нам не приходится сталкиваться с этими проблемами, и мы работаем со случайными величинами, имеющими чётко определённые средние значения и дисперсии. Однако время от времени случайные величины с тяжелыми хвостами (то есть такие случайные величины, у которых вероятность получения больших значений достаточно велика, чтобы среднее значение или дисперсия не были определены) оказываются полезными при моделировании физических систем, поэтому стоит знать, что они существуют.
22.6.1.8. Совместные функции плотности
Все предыдущие рассуждения предполагали, что мы имеем дело с одной вещественной случайной величиной. Но что, если мы работаем с двумя или более случайными величинами, которые могут быть сильно коррелированы? Такая ситуация является нормой в машинном обучении: представьте случайные величины, такие как \(R_{i, j}\), которые кодируют значение красного канала пикселя с координатами \((i, j)\) на изображении, или \(P_t\), являющуюся случайной величиной, определяемой ценой акции в момент времени \(t\). Соседние пиксели, как правило, имеют схожие цвета, а соседние моменты времени — схожие цены. Мы не можем рассматривать их как отдельные случайные величины и при этом ожидать создания успешной модели (мы увидим в Section 22.9 модель, которая работает хуже из-за такого допущения). Нам необходимо разработать математический язык для работы с такими коррелированными непрерывными случайными величинами.
К счастью, с помощью кратных интегралов, рассмотренных в Section 22.5, мы можем разработать такой язык. Предположим для простоты, что у нас есть две случайные величины \(X, Y\), которые могут быть коррелированы. Тогда, аналогично случаю одной случайной величины, мы можем задать вопрос:
Аналогичные рассуждения, как и в случае одной случайной величины, показывают, что это должно быть примерно
для некоторой функции \(p(x, y)\). Это называется совместной плотностью \(X\) и \(Y\). Для неё справедливы аналогичные свойства, которые мы рассматривали в случае одной переменной. А именно:
\(p(x, y) \ge 0\);
\(\int _ {\mathbb{R}^2} p(x, y) \;dx \;dy = 1\);
\(P((X, Y) \in \mathcal{D}) = \int _ {\mathcal{D}} p(x, y) \;dx \;dy\).
Таким образом, мы можем работать с несколькими случайными величинами, которые могут быть коррелированы. Если нам нужно работать с более чем двумя случайными величинами, мы можем обобщить многомерную плотность на любое количество координат, рассматривая \(p(\mathbf{x}) = p(x_1, \ldots, x_n)\). При этом сохраняются те же свойства: неотрицательность и равенство полного интеграла единице.
22.6.1.9. Маргинальные распределения
При работе с несколькими переменными нам часто хочется игнорировать взаимосвязи и спросить: «Как распределена эта одна переменная?» Такое распределение называется маргинальным распределением.
Для определённости предположим, что у нас есть две случайные величины \(X, Y\) с совместной плотностью, заданной выражением \(p _ {X, Y}(x, y)\). Мы будем использовать нижний индекс для указания того, для каких случайных величин задана плотность. Задача нахождения маргинального распределения заключается в том, чтобы, используя эту функцию, найти \(p _ X(x)\).
Как и в большинстве случаев, лучше всего вернуться к интуитивному представлению, чтобы понять, что должно быть верно. Напомним, что плотность — это функция \(p _ X\), так что
В определении не упоминается \(Y\), но если нам дано только \(p _{X, Y}\), нам как-то нужно учесть \(Y\). Мы можем сначала заметить, что это эквивалентно
Наша плотность не дает прямого представления о том, что происходит в этом случае; нам также необходимо разбить на малые интервалы в \(y\), поэтому мы можем записать это как
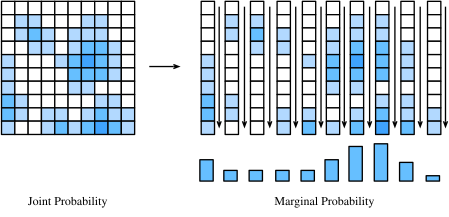
Fig. 22.6.1 Суммируя по столбцам нашего массива вероятностей, мы можем получить маргинальное распределение для случайной величины, представленной вдоль оси \(\mathit{x}\).
This tells us to add up the value of the density along a series of squares in a line as is shown in Fig. 22.6.1. Indeed, after canceling one factor of epsilon from both sides, and recognizing the sum on the right is the integral over \(y\), we can conclude that
Таким образом, мы видим
Это означает, что для получения маргинального распределения необходимо проинтегрировать по переменным, которые нас не интересуют. Этот процесс часто называют интегрированием по или маргинализацией ненужных переменных.
22.6.1.10. Ковариация
При работе с несколькими случайными величинами полезно знать ещё одну сводную характеристику — ковариацию. Она измеряет степень, в которой две случайные величины изменяются совместно.
Предположим, что у нас есть две случайные величины \(X\) и \(Y\). Для начала предположим, что они дискретны и принимают значения \((x_i, y_j)\) с вероятностью \(p_{ij}\). В этом случае ковариация определяется как
Чтобы понять это интуитивно, рассмотрим следующую пару случайных величин. Пусть \(X\) принимает значения \(1\) и \(3\), а \(Y\) — значения \(-1\) и \(3\). Предположим, что у нас есть следующие вероятности
где \(p\) — это параметр в \([0,1]\), который мы выбираем. Заметим, что если \(p=1\), то они всегда одновременно принимают свои минимальные или максимальные значения, а если \(p=0\), то они гарантированно принимают противоположные значения одновременно (одно велико, когда другое мало, и наоборот). Если \(p=1/2\), то все четыре исхода равновероятны, и между ними не должно быть связи. Вычислим ковариацию. Сначала заметим, что \(\mu_X = 2\) и \(\mu_Y = 1\), поэтому мы можем вычислить её, используя (22.6.39):
Когда \(p=1\) (случай, когда они одновременно принимают максимальные положительные или отрицательные значения), ковариация равна \(2\). Когда \(p=0\) (случай, когда они принимают противоположные значения), ковариация равна \(-2\). Наконец, когда \(p=1/2\) (случай, когда они не связаны), ковариация равна \(0\). Таким образом, мы видим, что ковариация измеряет, как связаны между собой эти две случайные величины.
Краткое замечание о ковариации заключается в том, что она измеряет только линейные зависимости. Более сложные зависимости, такие как \(X = Y^2\), где \(Y\) случайным образом выбирается из \(\{-2, -1, 0, 1, 2\}\) с равной вероятностью, могут быть упущены. Действительно, несложные вычисления показывают, что ковариация этих случайных величин равна нулю, несмотря на то, что одна из них является детерминированной функцией другой.
Для непрерывных случайных величин ситуация аналогична. На этом этапе мы уже достаточно уверенно переходим от дискретных случаев к непрерывным, поэтому приведём непрерывный аналог (22.6.39) без вывода.
Для наглядности рассмотрим набор случайных величин с настраиваемой ковариацией.
# Plot a few random variables adjustable covariance
covs = [-0.9, 0.0, 1.2]
d2l.plt.figure(figsize=(12, 3))
for i in range(3):
    X = torch.randn(500)
    Y = covs[i]*X + torch.randn(500)

    d2l.plt.subplot(1, 4, i+1)
    d2l.plt.scatter(X.numpy(), Y.numpy())
    d2l.plt.xlabel('X')
    d2l.plt.ylabel('Y')
    d2l.plt.title(f'cov = {covs[i]}')
d2l.plt.show()
Рассмотрим некоторые свойства ковариаций:
Для любой случайной величины \(X\), \(\textrm{Cov}(X, X) = \textrm{Var}(X)\).
Для любых случайных величин \(X, Y\) и чисел \(a\), \(b\) и \(\textrm{Cov}(aX+b, Y) = \textrm{Cov}(X, aY+b) = a\textrm{Cov}(X, Y)\).
Если \(X\) и \(Y\) независимы, то \(\textrm{Cov}(X, Y) = 0\).
Кроме того, мы можем использовать ковариацию, чтобы расширить соотношение, которое мы рассматривали ранее. Напомним, что если \(X\) и \(Y\) — две независимые случайные величины, то
Зная ковариации, мы можем расширить это соотношение. Действительно, некоторые алгебраические преобразования показывают, что в общем случае,
Это позволяет нам обобщить правило суммирования дисперсий для коррелированных случайных величин.
22.6.1.11. Корреляция
Как и в случае со средними и дисперсиями, рассмотрим размерности. Если \(X\) измеряется в одной единице (например, в дюймах), а \(Y\) — в другой (например, в долларах), то ковариация измеряется в произведении этих двух единиц \(\textrm{inches} \times \textrm{dollars}\). Такие единицы измерения бывает трудно интерпретировать. В таких случаях нам часто требуется безразмерная мера взаимосвязи. Действительно, зачастую нас не интересует точная количественная корреляция, а скорее то, совпадает ли направление корреляции и насколько сильна связь.
Чтобы понять, как это работает, проведем мысленный эксперимент. Предположим, что мы переводим наши случайные величины из дюймов и долларов в дюймы и центы. В этом случае случайная величина \(Y\) умножается на \(100\). Если подставить это в определение, то окажется, что \(\textrm{Cov}(X, Y)\) будет умножено на \(100\). Таким образом, мы видим, что в этом случае изменение единиц измерения изменяет ковариацию в \(100\) раз. Следовательно, чтобы найти инвариантную к единицам измерения меру корреляции, нам нужно разделить на величину, которая также масштабируется на \(100\). Таким кандидатом является стандартное отклонение! Если мы определим коэффициент корреляции как
мы видим, что это безразмерное значение. Несложные математические выкладки показывают, что это число находится в диапазоне от \(-1\) до \(1\), где \(1\) означает максимальную положительную корреляцию, а \(-1\) — максимальную отрицательную корреляцию.
Возвращаясь к нашему явному дискретному примеру выше, мы видим, что \(\sigma_X = 1\) и \(\sigma_Y = 2\), поэтому мы можем вычислить корреляцию между двумя случайными величинами, используя (22.6.45), чтобы убедиться, что
Теперь это значение находится в диапазоне от \(-1\) до \(1\), при этом \(1\) соответствует максимальной корреляции, а \(-1\) — минимальной.
В качестве ещё одного примера рассмотрим \(X\) как любую случайную величину, а \(Y=aX+b\) — как любую линейную детерминированную функцию от \(X\). Тогда можно вычислить, что
и, следовательно, из (22.6.45) следует, что
Таким образом, мы видим, что корреляция равна \(+1\) для любых \(a > 0\) и \(-1\) для любых \(a < 0\), что иллюстрирует: корреляция измеряет степень и направление связи между двумя случайными величинами, а не масштаб их изменчивости.
Давайте снова построим график набора случайных величин с настраиваемой корреляцией.
# Plot a few random variables adjustable correlations
cors = [-0.9, 0.0, 1.0]
d2l.plt.figure(figsize=(12, 3))
for i in range(3):
    X = torch.randn(500)
    Y = cors[i] * X + torch.sqrt(torch.tensor(1) -
                                 cors[i]**2) * torch.randn(500)

    d2l.plt.subplot(1, 4, i + 1)
    d2l.plt.scatter(X.numpy(), Y.numpy())
    d2l.plt.xlabel('X')
    d2l.plt.ylabel('Y')
    d2l.plt.title(f'cor = {cors[i]}')
d2l.plt.show()
Ниже приведён ряд свойств корреляции.
Для любой случайной величины \(X\), \(\rho(X, X) = 1\).
Для любых случайных величин \(X, Y\) и чисел \(a\), \(b\) и \(\rho(aX+b, Y) = \rho(X, aY+b) = \rho(X, Y)\).
Если \(X\) и \(Y\) независимы и имеют ненулевую дисперсию, то \(\rho(X, Y) = 0\).
В качестве последнего замечания отметим, что некоторые из этих формул могут показаться вам знакомыми. Действительно, если раскрыть всё, предполагая, что \(\mu_X = \mu_Y = 0\), мы видим, что это
Это напоминает сумму произведений, деленную на квадратный корень из суммы квадратов. Это в точности формула для косинуса угла между двумя векторами \(\mathbf{v}, \mathbf{w}\), где различные координаты взвешены с помощью \(p_{ij}\):
Действительно, если рассматривать нормы как связанные со стандартными отклонениями, а корреляции — как косинусы углов, то большую часть геометрической интуиции можно применить к анализу случайных величин.
22.6.2. Итоги
Непрерывные случайные величины — это случайные величины, которые могут принимать любое значение из некоторого континуума. Они обладают некоторыми техническими трудностями, которые делают их более сложными для работы по сравнению с дискретными случайными величинами.
Функция плотности вероятности позволяет работать с непрерывными случайными величинами, задавая такую функцию, что площадь под её кривой на некотором интервале равна вероятности попадания в этот интервал точки примера.
Функция распределения — это вероятность того, что случайная величина примет значение, меньшее заданного порога. Она может предоставить полезную альтернативную точку зрения, которая объединяет дискретные и непрерывные случайные величины.
Математическое ожидание — это среднее значение случайной величины.
Дисперсия — это математическое ожидание квадрата разности между случайной величиной и её средним значением.
Стандартное отклонение — это квадратный корень из дисперсии. Его можно рассматривать как меру диапазона значений, которые может принимать случайная величина.
Неравенство Чебышёва позволяет обосновать эту интуицию, задавая явный интервал, в котором случайная величина находится с высокой вероятностью.
Совместные плотности позволяют работать со скоррелированными случайными величинами. Мы можем получить распределение нужной случайной величины, маргинализуя совместные плотности путем интегрирования по нежелательным случайным величинам.
Ковариация и коэффициент корреляции позволяют измерять любую линейную связь между двумя коррелированными случайными величинами.
22.6.3. Упражнения
Предположим, что у нас есть случайная величина с плотностью, заданной как \(p(x) = \frac{1}{x^2}\) для \(x \ge 1\) и \(p(x) = 0\) в остальных случаях. Чему равно \(P(X > 2)\)?
Распределение Лапласа — это случайная величина, плотность вероятности которой задаётся формулой \(p(x = \frac{1}{2}e^{-|x|}\). Чему равны математическое ожидание и стандартное отклонение этой величины? В качестве подсказки используйте \(\int_0^\infty xe^{-x} \; dx = 1\) и \(\int_0^\infty x^2e^{-x} \; dx = 2\).
Я подхожу к вам на улице и говорю: «У меня есть случайная величина со средним \(1\), стандартным отклонением \(2\), и я наблюдаю, что \(25\%\) из моих выборок принимают значение, большее \(9\)». Верите ли вы мне? Почему да, а почему нет?
Предположим, что у нас есть две случайные величины \(X, Y\), совместная плотность распределения которых задаётся выражением \(p_{XY}(x, y) = 4xy\) для \(x, y \in [0,1]\) и \(p_{XY}(x, y) = 0\) в остальных случаях. Какова ковариация \(X\) и \(Y\)?