
Предисловие
Ещё несколько лет назад не было легионов специалистов по глубокому обучению, разрабатывающих интеллектуальные продукты и услуги в крупных компаниях и стартапах. Когда мы только пришли в эту область, машинное обучение не попадало на первые полосы ежедневных газет. Наши родители и понятия не имели, что такое машинное обучение, не говоря уже о том, почему мы могли бы предпочесть его карьере в медицине или юриспруденции. Машинное обучение было академической дисциплиной «для будущего», а его промышленная значимость ограничивалась узким набором реальных приложений, таких как распознавание речи и компьютерное зрение. Более того, многие из этих приложений требовали столь глубоких предметных знаний, что их часто рассматривали как совершенно отдельные области, в которых машинное обучение было лишь одним из небольших компонентов. В то время нейронные сети — предшественники методов глубокого обучения, на которых мы сосредоточимся в этой книге, — в целом считались устаревшими.
Однако всего за несколько лет глубокое обучение удивило весь мир, обеспечив стремительный прогресс в столь различных областях, как компьютерное зрение, обработка естественного языка, автоматическое распознавание речи, обучение с подкреплением и биоинформатика. Более того, успех глубокого обучения во множестве практически значимых задач даже стимулировал развитие теоретического машинного обучения и статистики. Благодаря этим достижениям мы теперь можем создавать автомобили, способные к беспилотному вождению с беспрецедентным уровнем автономности (хотя и не таким высоким, как некоторые компании хотели бы, чтобы вы думали), диалоговые системы, которые отлаживают код, задавая уточняющие вопросы, и программных агентов, побеждающих лучших в мире игроков в настольные игры, такие как Го, — достижение, которое ранее считалось делом отдаленного будущего. Уже сегодня эти инструменты оказывают все более широкое влияние на промышленность и общество, меняя способы создания фильмов и диагностики заболеваний, а также играя все более заметную роль в фундаментальных науках — от астрофизики и моделирования климата до прогнозирования погоды и биомедицины.
Об этой книге
Эта книга — наша попытка сделать глубокое обучение доступным, обучая вас концепциям, контексту и коду.
Одна среда, объединяющая код, математику и HTML
Чтобы любая вычислительная технология могла в полной мере реализовать свой потенциал, она должна быть хорошо понята, подробно задокументирована и поддерживаться зрелыми, тщательно поддерживаемыми инструментами. Ключевые идеи должны быть чётко сформулированы, что минимизирует время, необходимое для того, чтобы новые специалисты были в курсе последних достижений. Зрелые библиотеки должны автоматизировать типовые задачи, а примерный код должен позволять специалистам легко изменять, применять и расширять типовые приложения в соответствии со своими потребностями.
В качестве примера рассмотрим динамические веб-приложения. Несмотря на то что многие компании, такие как Amazon, успешно разрабатывали веб-приложения на базе баз данных ещё в 1990-х годах, потенциал этой технологии для поддержки творческих предпринимателей был в полной мере осознан лишь за последние десять лет, отчасти благодаря созданию мощных и хорошо документированных фреймворков.
Исследование потенциала глубокого обучения сопряжено с уникальными трудностями, поскольку любое конкретное приложение объединяет различные дисциплины. Применение глубокого обучения требует одновременного понимания: (i) мотивов, определяющих способ постановки задачи; (ii) математической формы заданной модели; (iii) алгоритмов оптимизации для подгонки моделей к данным; (iv) статистических принципов, указывающих, когда следует ожидать, что наши модели будут обобщать данные, отсутствующие в обучающей выборке, и практических методов подтверждения того, что они действительно обобщили их; и (v) инженерных методов, необходимых для эффективного обучения моделей, обхода подводных камней численных вычислений и максимальной отдачи от доступного оборудования. Обучение навыкам критического мышления, необходимым для постановки задач, математическим методам их решения и программным инструментам для реализации этих решений в одном месте представляет собой сложную задачу. Наша цель в этой книге — представить единый ресурс, который позволит будущим специалистам быстро освоиться.
Когда мы начинали работу над этой книгой, не существовало ресурсов, которые одновременно (i) оставались актуальными; (ii) охватывали широкий спектр современных практик машинного обучения с достаточной технической глубиной; и (iii) сочетали изложение на уровне, ожидаемом от учебника, с чистым исполняемым кодом, характерным для практических руководств. Мы нашли множество примеров кода, иллюстрирующих использование того или иного фреймворка глубокого обучения (например, как выполнять базовые численные вычисления с матрицами в TensorFlow) или реализацию конкретных методов (например, фрагменты кода для LeNet, AlexNet, ResNet и т. д.), разбросанные по различным блогам и репозиториям GitHub. Однако эти примеры обычно фокусировались на том, как реализовать определённый подход, но оставляли без обсуждения, почему принимаются те или иные алгоритмические решения. Хотя время от времени появлялись интерактивные ресурсы, посвященные отдельным темам, например, увлекательные статьи на сайте Distill или личные блоги, они охватывали лишь избранные темы глубокого обучения и часто не содержали сопутствующего кода. С другой стороны, хотя и появились учебники по глубокому обучению — например, Goodfellow et al. (2016), предлагающий всесторонний обзор основ глубокого обучения, — эти ресурсы не связывают описание концепций с их реализацией в коде, иногда оставляя читателей в неведении относительно того, как их реализовать. Более того, слишком много ресурсов скрыто за платными стенами коммерческих образовательных платформ.
Мы поставили перед собой цель создать ресурс, который (i) был бы доступен всем бесплатно; (ii) обеспечивал достаточную техническую глубину, чтобы служить отправной точкой на пути к становлению специалистом по прикладному машинному обучению; (iii) включал исполняемый код, демонстрирующий читателям, как решать задачи на практике; (iv) позволял оперативно обновляться как нам, так и широкому сообществу; и (v) дополнялся форумом для интерактивного обсуждения технических деталей и ответов на вопросы.
Эти цели часто противоречили друг другу. Уравнения, теоремы и ссылки лучше всего структурировать и верстать в LaTeX. Код удобнее всего описывать на Python. А веб-страницы изначально создаются с использованием HTML и JavaScript. Кроме того, мы хотим, чтобы материал был доступен в виде исполняемого кода, в форме печатной книги, в виде скачиваемого PDF-файла и в интернете как веб-сайт. Ни один из существующих рабочих процессов не казался подходящим для этих требований, поэтому мы решили создать свой собственный (Section 23.6). Мы выбрали GitHub для публикации исходного кода и облегчения вклада сообщества; Jupyter-блокноты для сочетания кода, уравнений и текста; Sphinx в качестве движка рендеринга; и Discourse как платформу для обсуждений. Хотя наша система не идеальна, эти решения представляют собой компромисс между противоречивыми требованиями. Мы полагаем, что Dive into Deep Learning может стать первой книгой, опубликованной с использованием такого интегрированного рабочего процесса.
Обучение на практике
Многие учебники излагают концепции последовательно, раскрывая каждую в исчерпывающих деталях. Например, в превосходном учебнике Bishop (2006) каждая тема разбирается настолько подробно, что для перехода к главе о линейной регрессии требуется значительное усилие. Хотя эксперты ценят эту книгу именно за её тщательность, для настоящих новичков это свойство ограничивает её полезность в качестве вводного текста.
В этой книге мы преподаем большинство концепций по мере необходимости. Иными словами, вы будете изучать их в тот самый момент, когда они требуются для решения конкретной практической задачи. Хотя в начале мы уделяем некоторое время изучению фундаментальных основ, таких как линейная алгебра и вероятность, мы хотим, чтобы вы испытали удовлетворение от обучения своей первой модели, прежде чем переходить к более эзотерическим темам.
Помимо нескольких вводных тетрадей, дающих краткий курс базового математического аппарата, каждая последующая глава вводит разумное количество новых понятий и содержит несколько самостоятельных рабочих примеров на реальных наборах данных. Это создало определённые организационные трудности. Некоторые модели логично было бы объединить в одной тетради, а некоторые идеи лучше всего объяснять, последовательно запуская несколько моделей. Однако соблюдение принципа один рабочий пример — одна тетрадь имеет существенное преимущество: оно максимально упрощает вам начало собственных исследовательских проектов благодаря нашему коду. Просто скопируйте тетрадь и начните её изменять.
В течение всей книги мы чередуем исполняемый код с теоретическим материалом по мере необходимости. Как правило, мы предпочитаем предоставлять инструменты до их полного объяснения (часто дополняя теоретическую базу позже). Например, мы можем использовать стохастический градиентный спуск, прежде чем объяснять, почему он полезен, или приводить интуитивное обоснование его работы. Это помогает практикам быстро решать задачи, хотя и требует от читателя доверия к нашим решениям по отбору материала.
Эта книга обучает концепциям глубокого обучения с нуля. Иногда мы погружаемся в тонкие детали моделей, которые обычно скрыты от пользователей современными фреймворками глубокого обучения. Это особенно заметно в базовых руководствах, где мы хотим, чтобы вы понимали, что происходит в каждом слое или оптимизаторе. В таких случаях мы часто приводим два варианта примера: один, где все реализовано с нуля, с использованием только функционала, подобного NumPy, и механизма автоматического дифференцирования, и более практичный вариант, где мы пишем лаконичный код с помощью высокоуровневых API фреймворков глубокого обучения. После объяснения принципов работы того или иного компонента в последующих руководствах мы опираемся на высокоуровневые API.
Содержание и структура
Книгу можно условно разделить на три части, посвящённые предварительным сведениям, методам глубокого обучения и продвинутым темам, связанным с реальными системами и приложениями (Fig. 1).
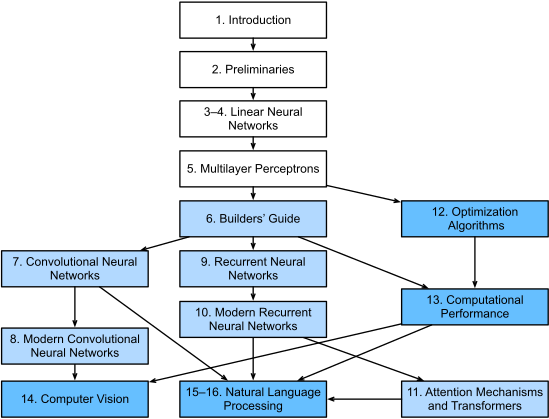
Fig. 1 Структура книги.
Часть 1: Основы и предварительные сведения. Section 1 — это введение в глубокое обучение. Затем в Section 2 мы кратко изложим необходимые предварительные знания для практического глубокого обучения, такие как хранение и обработка данных, а также применение различных численных операций на основе базовых понятий линейной алгебры, математического анализа и теории вероятностей. Section 3 и Section 5 охватывают наиболее фундаментальные концепции и методы глубокого обучения, включая регрессию и классификацию; линейные модели; многослойные перцептроны; а также переобучение и регуляризацию.
Часть 2: Современные методы глубокого обучения. Section 6 описывает ключевые вычислительные компоненты систем глубокого обучения и закладывает основу для наших последующих реализаций более сложных моделей. Далее, в Section 7 и Section 8 представлены свёрточные нейронные сети (CNN), мощный инструмент, составляющий основу большинства современных систем компьютерного зрения. Аналогично, в Section 9 и Section 10 вводятся рекуррентные нейронные сети (RNN), модели, использующие последовательную (например, временную) структуру данных и широко применяемые для обработки естественного языка и прогнозирования временных рядов. В Section 11 мы описываем относительно новый класс моделей, основанных на так называемых механизмах внимания, которые вытеснили RNN в качестве доминирующей архитектуры для большинства задач обработки естественного языка. Эти разделы помогут вам освоить самые мощные и универсальные инструменты, широко используемые специалистами в области глубокого обучения.
Часть 3: Масштабируемость, эффективность и области применения (доступна онлайн). В главе 12 мы обсуждаем несколько распространенных алгоритмов оптимизации, используемых для обучения моделей глубокого обучения. Далее, в главе 13, мы рассматриваем несколько ключевых факторов, влияющих на вычислительную производительность кода глубокого обучения. Затем, в главе 14, мы иллюстрируем основные области применения глубокого обучения в компьютерном зрении. Наконец, в главах 15 и 16 мы демонстрируем, как предобучать модели языковых представлений и применять их к задачам обработки естественного языка.
Код
В большинстве разделов этой книги представлен исполняемый код. Мы считаем, что некоторые интуитивные представления лучше всего формируются методом проб и ошибок: путем внесения небольших изменений в код и наблюдения за результатами. В идеале элегантная математическая теория должна была бы точно указывать, как изменить код, чтобы достичь желаемого результата. Однако специалисты по глубокому обучению сегодня часто вынуждены действовать там, где нет чёткой теоретической базы. Несмотря на все наши усилия, формальные объяснения эффективности различных методов все ещё отсутствуют по ряду причин: математическое описание этих моделей может быть чрезвычайно сложным; объяснение, вероятно, зависит от свойств данных, которые пока не имеют чётких определений; и серьезные исследования в этих областях только недавно вышли на новый уровень. Мы надеемся, что по мере развития теории глубокого обучения каждое следующее издание этой книги будет содержать более глубокие идеи, чем те, что доступны сегодня.
Чтобы избежать излишнего повторения, мы сгруппировали наиболее часто
импортируемые и используемые функции и классы в пакете d2l. Везде,
где встречаются блоки кода (например, функции, классы или наборы
инструкций импорта), мы помечаем их маркером #@save, чтобы указать,
что они будут доступны позже через пакет d2l. Подробный обзор этих
классов и функций приведен в Section 23.8. Пакет d2l является
легковесным и требует только следующих зависимостей:
#@save
import collections
import hashlib
import inspect
import math
import os
import random
import re
import shutil
import sys
import tarfile
import time
import zipfile
from collections import defaultdict
import pandas as pd
import requests
from IPython import display
from matplotlib import pyplot as plt
from matplotlib_inline import backend_inline

d2l = sys.modules[__name__]
Большая часть кода в этой книге написана на PyTorch — популярном фреймворке с открытым исходным кодом, который с энтузиазмом приняли исследователи в области глубокого обучения. Весь код в этой книге протестирован на последней стабильной версии PyTorch. Однако из-за быстрого развития глубокого обучения некоторый код в печатном издании может некорректно работать в будущих версиях PyTorch. Мы планируем поддерживать онлайн-версию в актуальном состоянии. Если вы столкнетесь с какими-либо проблемами, обратитесь к Установка, чтобы обновить свой код и среду выполнения. Ниже приведен список зависимостей для нашей реализации на PyTorch.
#@save
import numpy as np
import torch
import torchvision
from PIL import Image
from scipy.spatial import distance_matrix
from torch import nn
from torch.nn import functional as F
from torchvision import transforms
Целевая аудитория
Эта книга предназначена для студентов (бакалавриата или магистратуры), инженеров и исследователей, стремящихся к прочному пониманию практических методов глубокого обучения. Поскольку мы объясняем каждую концепцию с нуля, предварительные знания в области глубокого обучения или машинного обучения не требуются. Полное объяснение методов глубокого обучения требует некоторой математики и программирования, но мы предполагаем лишь базовую подготовку, включающую основы линейной алгебры, математического анализа, вероятности и программирования на Python. На случай, если вы что-то забыли, в онлайн-приложении приведено краткое повторение большей части математики, с которой вы встретитесь в этой книге. Обычно мы отдаем предпочтение интуиции и идеям, а не математической строгости. Если вы хотите расширить эти основы за рамки необходимых предварительных знаний, чтобы лучше понять материал книги, мы с удовольствием порекомендуем несколько других отличных ресурсов: книга Bollobás (1999) «Linear Analysis» подробно рассматривает линейную алгебру и функциональный анализ. Книга (Wasserman, 2013) «All of Statistics» предоставляет замечательное введение в статистику. Книги https://www.amazon.com/Introduction-Probability-Chapman-Statistical-Science/dp/1138369918 и курсы https://projects.iq.harvard.edu/stat110/home Джо Блицштейна по вероятности и выводу являются педагогическими жемчужинами. А если вы ранее не работали с Python, вам может быть полезно ознакомиться с этим учебником по Python.
Заметки, веб-сайт, GitHub и форум
All our notebooks can be downloaded from the D2L.ai website and from GitHub. Associated with this book we have launched a discussion forum at discuss.d2l.ai. Whenever you have questions on any section of the book, you can find a link to the associated discussion page at the end of each notebook.
Благодарности
Мы благодарим сотни участников, внесших вклад в создание английских и китайских черновиков. Они помогли улучшить содержание и предоставили ценные отзывы. Изначально эта книга была реализована с использованием MXNet в качестве основного фреймворка. Мы благодарим Анирудха Дгара и Юаня Танга за адаптацию большей части исходного кода MXNet к реализациям на PyTorch и TensorFlow соответственно. С июля 2021 года мы переработали и заново реализовали эту книгу на PyTorch, MXNet и TensorFlow, выбрав PyTorch в качестве основного фреймворка. Мы благодарим Анирудха Дгара за адаптацию большей части более нового кода на PyTorch к реализациям на JAX. Мы благодарим Гаошэна У, Люцзюня Ху, Гэ Чжана и Цзеханга Се из Baidu за адаптацию большей части более нового кода на PyTorch к реализациям на PaddlePaddle в китайском черновике. Мы благодарим Шуая Чжана за интеграцию стиля LaTeX издательства в процесс сборки PDF.
On GitHub, we thank every contributor of this English draft for making it better for everyone. Their GitHub IDs or names are (in no particular order): alxnorden, avinashingit, bowen0701, brettkoonce, Chaitanya Prakash Bapat, cryptonaut, Davide Fiocco, edgarroman, gkutiel, John Mitro, Liang Pu, Rahul Agarwal, Mohamed Ali Jamaoui, Michael (Stu) Stewart, Mike Müller, NRauschmayr, Prakhar Srivastav, sad-, sfermigier, Sheng Zha, sundeepteki, topecongiro, tpdi, vermicelli, Vishaal Kapoor, Vishwesh Ravi Shrimali, YaYaB, Yuhong Chen, Evgeniy Smirnov, lgov, Simon Corston-Oliver, Igor Dzreyev, Ha Nguyen, pmuens, Andrei Lukovenko, senorcinco, vfdev-5, dsweet, Mohammad Mahdi Rahimi, Abhishek Gupta, uwsd, DomKM, Lisa Oakley, Bowen Li, Aarush Ahuja, Prasanth Buddareddygari, brianhendee, mani2106, mtn, lkevinzc, caojilin, Lakshya, Fiete Lüer, Surbhi Vijayvargeeya, Muhyun Kim, dennismalmgren, adursun, Anirudh Dagar, liqingnz, Pedro Larroy, lgov, ati-ozgur, Jun Wu, Matthias Blume, Lin Yuan, geogunow, Josh Gardner, Maximilian Böther, Rakib Islam, Leonard Lausen, Abhinav Upadhyay, rongruosong, Steve Sedlmeyer, Ruslan Baratov, Rafael Schlatter, liusy182, Giannis Pappas, ati-ozgur, qbaza, dchoi77, Adam Gerson, Phuc Le, Mark Atwood, christabella, vn09, Haibin Lin, jjangga0214, RichyChen, noelo, hansent, Giel Dops, dvincent1337, WhiteD3vil, Peter Kulits, codypenta, joseppinilla, ahmaurya, karolszk, heytitle, Peter Goetz, rigtorp, Tiep Vu, sfilip, mlxd, Kale-ab Tessera, Sanjar Adilov, MatteoFerrara, hsneto, Katarzyna Biesialska, Gregory Bruss, Duy–Thanh Doan, paulaurel, graytowne, Duc Pham, sl7423, Jaedong Hwang, Yida Wang, cys4, clhm, Jean Kaddour, austinmw, trebeljahr, tbaums, Cuong V. Nguyen, pavelkomarov, vzlamal, NotAnotherSystem, J-Arun-Mani, jancio, eldarkurtic, the-great-shazbot, doctorcolossus, gducharme, cclauss, Daniel-Mietchen, hoonose, biagiom, abhinavsp0730, jonathanhrandall, ysraell, Nodar Okroshiashvili, UgurKap, Jiyang Kang, StevenJokes, Tomer Kaftan, liweiwp, netyster, ypandya, NishantTharani, heiligerl, SportsTHU, Hoa Nguyen, manuel-arno-korfmann-webentwicklung, aterzis-personal, nxby, Xiaoting He, Josiah Yoder, mathresearch, mzz2017, jroberayalas, iluu, ghejc, BSharmi, vkramdev, simonwardjones, LakshKD, TalNeoran, djliden, Nikhil95, Oren Barkan, guoweis, haozhu233, pratikhack, Yue Ying, tayfununal, steinsag, charleybeller, Andrew Lumsdaine, Jiekui Zhang, Deepak Pathak, Florian Donhauser, Tim Gates, Adriaan Tijsseling, Ron Medina, Gaurav Saha, Murat Semerci, Lei Mao, Levi McClenny, Joshua Broyde, jake221, jonbally, zyhazwraith, Brian Pulfer, Nick Tomasino, Lefan Zhang, Hongshen Yang, Vinney Cavallo, yuntai, Yuanxiang Zhu, amarazov, pasricha, Ben Greenawald, Shivam Upadhyay, Quanshangze Du, Biswajit Sahoo, Parthe Pandit, Ishan Kumar, HomunculusK, Lane Schwartz, varadgunjal, Jason Wiener, Armin Gholampoor, Shreshtha13, eigen-arnav, Hyeonggyu Kim, EmilyOng, Bálint Mucsányi, Chase DuBois, Juntian Tao, Wenxiang Xu, Lifu Huang, filevich, quake2005, nils-werner, Yiming Li, Marsel Khisamutdinov, Francesco “Fuma” Fumagalli, Peilin Sun, Vincent Gurgul, qingfengtommy, Janmey Shukla, Mo Shan, Kaan Sancak, regob, AlexSauer, Gopalakrishna Ramachandra, Tobias Uelwer, Chao Wang, Tian Cao, Nicolas Corthorn, akash5474, kxxt, zxydi1992, Jacob Britton, Shuangchi He, zhmou, krahets, Jie-Han Chen, Atishay Garg, Marcel Flygare, adtygan, Nik Vaessen, bolded, Louis Schlessinger, Balaji Varatharajan, atgctg, Kaixin Li, Victor Barbaros, Riccardo Musto, Elizabeth Ho, azimjonn, Guilherme Miotto, Alessandro Finamore, Joji Joseph, Anthony Biel, Zeming Zhao, shjustinbaek, gab-chen, nantekoto, Yutaro Nishiyama, Oren Amsalem, Tian-MaoMao, Amin Allahyar, Gijs van Tulder, Mikhail Berkov, iamorphen, Matthew Caseres, Andrew Walsh, pggPL, RohanKarthikeyan, Ryan Choi, and Likun Lei.
Мы благодарим Amazon Web Services, а именно Вэнь-Мина Йе, Джорджа Кариписа, Свами Сивасубраманьяна, Питера ДеСантиса, Адама Селипски и Эндрю Джасси, за их щедрую поддержку в написании этой книги. Без выделенного времени, ресурсов, обсуждений с коллегами и постоянной поддержки эта книга не была бы написана. Во время подготовки книги к публикации издательство Cambridge University Press оказало нам отличную поддержку. Мы благодарим нашего ответственного редактора Дэвида Трана за его помощь и профессионализм.
Итоги
Глубокое обучение совершило революцию в распознавании образов, внедрив технологии, которые сегодня лежат в основе широкого спектра решений в таких различных областях, как компьютерное зрение, обработка естественного языка и автоматическое распознавание речи. Чтобы успешно применять глубокое обучение, необходимо понимать, как формулировать задачи, основы математики моделирования, алгоритмы подгонки моделей к данным и инженерные методы реализации всего этого. В этой книге представлен исчерпывающий ресурс, включающий текст, иллюстрации, математические выкладки и код, собранные в одном месте.
Упражнения
Зарегистрируйтесь на форуме обсуждений этой книги discuss.d2l.ai.
Установите Python на свой компьютер.
Перейдите по ссылкам в конце раздела на форум, где вы сможете получить помощь, обсудить книгу и найти ответы на свои вопросы, взаимодействуя с авторами и более широким сообществом.