
22.11. Теория информации
Вселенная изобилует информацией. Информация служит общим языком, преодолевающим границы между дисциплинами: от сонетов Шекспира до статей исследователей на arXiv, от гравюры «Звёздная ночь» Ван Гога до пятой симфонии Бетховена, от первого языка программирования Планкалькуля до современных алгоритмов машинного обучения. Всё, что существует, подчиняется законам теории информации, независимо от формата. С помощью теории информации мы можем измерять и сравнивать объём информации, содержащейся в различных сигналах. В этом разделе мы рассмотрим фундаментальные понятия теории информации и её применение в машинном обучении.
Прежде чем начать, давайте опишем взаимосвязь между машинным обучением и теорией информации. Машинное обучение стремится извлекать из данных значимые сигналы и делать важные прогнозы. В свою очередь, теория информации изучает кодирование, декодирование, передачу и обработку информации. Таким образом, теория информации предоставляет фундаментальный язык для описания обработки информации в системах машинного обучения. Например, во многих приложениях машинного обучения используется функция потерь перекрёстной энтропии, как описано в Section 4.1. Эта функция потерь может быть непосредственно выведена из соображений теории информации.
22.11.1. Информация
Начнем с «души» теории информации: с самой информации. Информация может быть закодирована в любом объекте, имеющем определённую последовательность из одного или нескольких форматов кодирования. Предположим, что мы ставим перед собой задачу определить понятие информации. С чего нам следует начать?
Рассмотрим следующий мысленный эксперимент. У нас есть друг с колодой карт. Он перетасует колоду, откроет несколько карт и сделает утверждения об этих картах. Мы постараемся оценить информационное содержание каждого утверждения.
Во-первых, они переворачивают карту и говорят нам: «Я вижу карту». Это не даёт нам никакой информации. Мы и так были уверены в этом, поэтому ожидаем, что информационное содержание равно нулю.
Далее они переворачивают карту и говорят: «Я вижу черви». Это даёт нам некоторую информацию, но на самом деле существует лишь \(4\) возможных мастей, каждая из которых равновероятна, поэтому этот результат нас не удивляет. Мы ожидаем, что информационное содержание этого события будет низким.
Затем они переворачивают карту и говорят: «Это \(3\) пик». Это уже больше информации. Действительно, было \(52\) равновероятных исходов, и наш друг сообщил нам, какой именно это был. Это должно быть среднее количество информации.
Давайте доведем это до логического предела. Предположим, что в конце они переворачивают все карты из колоды и зачитывают всю последовательность перемешанной колоды. Существует \(52!\) различных порядков колоды, все они равновероятны, поэтому нам нужно много информации, чтобы узнать, какой именно порядок имеет место.
Любое понятие информации, которое мы введем, должно соответствовать этой интуиции. Действительно, в следующих разделах мы узнаем, как вычислить, что эти события содержат \(0\textrm{ bits}\), \(2\textrm{ bits}\), \(~5.7\textrm{ bits}\) и \(~225.6\textrm{ bits}\) единиц информации соответственно.
Прочитав эти мысленные эксперименты, мы видим естественную идею. В качестве отправной точки, вместо того чтобы ориентироваться на знание, мы можем исходить из того, что информация отражает степень удивления или абстрактную возможность события. Например, если мы хотим описать необычное событие, нам нужно много информации. Для обычного события, возможно, не потребуется много информации.
В 1948 году Клод Э. Шеннон опубликовал работу A Mathematical Theory of Communication (Shannon, 1948), заложив основы теории информации. В этой статье он впервые ввёл понятие информационной энтропии. С этого мы и начнём наше путешествие.
22.11.1.1. Собственная информация
Поскольку информация воплощает абстрактную возможность наступления события, как мы можем соотнести эту возможность с количеством битов? Шеннон ввел термин бит в качестве единицы информации, который изначально предложил Джон Тьюки. Так что же такое «бит» и почему мы используем его для измерения информации? Исторически ранние передатчики могли передавать или принимать только два типа кода: \(0\) и \(1\). Действительно, двоичное кодирование до сих пор широко используется во всех современных цифровых компьютерах. Таким образом, любая информация кодируется последовательностью \(0\) и \(1\). Следовательно, последовательность двоичных цифр длины \(n\) содержит \(n\) бит информации.
Предположим теперь, что для любой последовательности кодов каждый \(0\) или \(1\) встречается с вероятностью \(\frac{1}{2}\). Следовательно, событие \(X\), представленное последовательностью кодов длины \(n\), происходит с вероятностью \(\frac{1}{2^n}\). В то же время, как мы упоминали ранее, эта последовательность содержит \(n\) бит информации. Таким образом, можем ли мы обобщить это до математической функции, которая преобразует вероятность \(p\) в количество бит? Шеннон дал ответ, определив собственную информацию
как количество битов информации, полученное для этого события \(X\). Обратите внимание, что в этом разделе мы всегда будем использовать логарифмы по основанию 2. Для простоты изложения в остальной части этого раздела индекс 2 в обозначении логарифма будет опущен, то есть \(\log(.)\) всегда означает \(\log_2(.)\). Например, код «0010» имеет собственную информацию
Мы можем вычислить собственную информацию, как показано ниже. Для начала импортируем все необходимые пакеты, используемые в этом разделе.
import torch
from torch.nn import NLLLoss


def nansum(x):
    # Define nansum, as pytorch does not offer it inbuilt.
    return x[~torch.isnan(x)].sum()

def self_information(p):
    return -torch.log2(torch.tensor(p)).item()

self_information(1 / 64)
22.11.2. Энтропия
Поскольку самоинформация измеряет информацию только одного дискретного события, нам нужна более общая мера для любой случайной величины, имеющей дискретное или непрерывное распределение.
22.11.2.1. Обоснование введения энтропии
Давайте попробуем конкретизировать наши требования. Это будет неформальное изложение того, что известно как аксиомы энтропии Шеннона. Окажется, что следующий набор утверждений, основанных на здравом смысле, приводит нас к единственному определению информации. Формальная версия этих аксиом, а также нескольких других, может быть найдена в Csiszár (2008).
Информация, которую мы получаем, наблюдая случайную величину, не зависит от того, как мы называем её элементы, или от наличия дополнительных элементов с нулевой вероятностью.
Информация, которую мы получаем, наблюдая две случайные величины, не превышает суммы информации, которую мы получаем, наблюдая их по отдельности. Если они независимы, то она равна этой сумме.
Информация, полученная при наблюдении (почти) достоверных событий, (почти) равна нулю.
Хотя доказательство этого факта выходит за рамки нашего текста, важно знать, что это однозначно определяет вид, который должна принимать энтропия. Единственная неоднозначность, допускаемая этими условиями, связана с выбором фундаментальных единиц измерения, который чаще всего нормируется путем выбора, который мы уже рассматривали: информация, предоставляемая одним броском честной монеты, равна одному биту.
22.11.2.2. Определение
Для любой случайной величины \(X\), подчиняющейся распределению вероятностей \(P\) с функцией плотности вероятности (f.d.f.) или функцией вероятности (f.m.f.) \(p(x)\), ожидаемый объём информации измеряется с помощью энтропии (или энтропии Шеннона)
Если \(X\) является дискретным,
В противном случае, если \(X\) непрерывна, мы также называем энтропию дифференциальной энтропией.
Мы можем определить энтропию следующим образом.
def entropy(p):
    entropy = - p * torch.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(entropy)
    return out

entropy(torch.tensor([0.1, 0.5, 0.1, 0.3]))
22.11.2.3. Интерпретации
Вас может заинтересовать: в определении энтропии (22.11.3), почему мы используем математическое ожидание отрицательного логарифма? Вот несколько интуитивных соображений.
Во-первых, почему мы используем функцию логарифма \(\log\)? Предположим, что \(p(x) = f_1(x) f_2(x) \ldots, f_n(x)\), где каждая компонентная функция \(f_i(x)\) независима от других. Это означает, что каждая \(f_i(x)\) вносит независимый вклад в общую информацию, полученную из \(p(x)\). Как обсуждалось выше, мы хотим, чтобы формула энтропии была аддитивной для независимых случайных величин. К счастью, \(\log\) может естественным образом преобразовать произведение распределений вероятностей в сумму отдельных слагаемых.
Далее, почему мы используем отрицательное \(\log\)? Интуитивно понятно, что более частые события должны содержать меньше информации, чем менее вероятные, поскольку мы обычно получаем больше информации из необычного случая, чем из обычного. Однако \(\log\) монотонно возрастает с ростом вероятностей и, действительно, принимает отрицательные значения для всех значений из \([0, 1]\). Нам необходимо построить монотонно убывающую зависимость между вероятностью событий и их энтропией, которая в идеале всегда была бы положительной (поскольку ничто из наблюдаемого не должно заставлять нас забывать то, что мы уже знаем). Следовательно, мы добавляем знак минус перед функцией \(\log\).
Наконец, откуда берется функция математического ожидания? Рассмотрим случайную величину \(X\). Мы можем интерпретировать самоинформацию (\(-\log(p)\)) как степень удивления, которую мы испытываем при наблюдении конкретного исхода. Действительно, по мере того как вероятность стремится к нулю, удивление становится бесконечным. Аналогичным образом мы можем интерпретировать энтропию как среднюю степень удивления при наблюдении \(X\). Например, представим, что система игрового автомата генерирует статистически независимые символы \({s_1, \ldots, s_k}\) с вероятностями \({p_1, \ldots, p_k}\) соответственно. Тогда энтропия этой системы равна среднему значению самоинформации от наблюдения каждого выхода, то есть
22.11.2.4. Свойства энтропии
На основе приведённых выше примеров и интерпретаций мы можем вывести следующие свойства энтропии (22.11.3). Здесь мы обозначаем \(X\) как событие, а \(P\) — как распределение вероятностей \(X\).
\(H(X) \geq 0\) для всех дискретных \(X\) (энтропия может быть отрицательной для непрерывных \(X\)).
Если \(X \sim P\) с функцией плотности вероятности (p.d.f.) или функцией вероятности (p.m.f.) \(p(x)\), и мы пытаемся оценить \(P\) с помощью нового распределения вероятностей \(Q\) с функцией плотности вероятности (p.d.f.) или функцией вероятности (p.m.f.) \(q(x)\), то
(22.11.7)¶\[H(X) = - E_{x \sim P} [\log p(x)] \leq - E_{x \sim P} [\log q(x)], \textrm{ with equality if and only if } P = Q.\]. Альтернативно, \(H(X)\) дает нижнюю границу среднего количества бит, необходимых для кодирования символов, выбранных из \(P\).
Если \(X \sim P\), то \(x\) передаёт максимальное количество информации, если она равномерно распределена между всеми возможными исходами. В частности, если распределение вероятностей \(P\) дискретно и имеет \(k\) классов \(\{p_1, \ldots, p_k \}\), то
(22.11.8)¶\[H(X) \leq \log(k), \textrm{ with equality if and only if } p_i = \frac{1}{k}, \forall i.\]Если \(P\) — непрерывная случайная величина, то ситуация становится гораздо сложнее. Однако, если дополнительно потребовать, чтобы \(P\) была определена на конечном интервале (со всеми значениями между \(0\) и \(1\)), то \(P\) обладает максимальной энтропией, если это равномерное распределение на данном интервале.
22.11.3. Взаимная информация
Ранее мы определили энтропию одной случайной величины \(X\). А какова энтропия пары случайных величин \((X, Y)\)? Эти методы можно рассматривать как попытку ответить на вопрос следующего типа: «Какая информация содержится в \(X\) и \(Y\) вместе по сравнению с каждой из них отдельно? Есть ли избыточная информация или она полностью уникальна?»
Для дальнейшего обсуждения мы всегда рассматриваем \((X, Y)\) как пару случайных величин, имеющих совместное распределение вероятностей \(P\) с функцией плотности вероятности (p.d.f.) или функцией вероятности (p.m.f.) \(p_{X, Y}(x, y)\), тогда как \(X\) и \(Y\) имеют распределения вероятностей \(p_X(x)\) и \(p_Y(y)\) соответственно.
22.11.3.1. Совместная энтропия
Аналогично энтропии одной случайной величины (22.11.3), мы определяем совместную энтропию \(H(X, Y)\) пары случайных величин \((X, Y)\) как
Точнее, с одной стороны, если \((X, Y)\) — пара дискретных случайных величин, то
С другой стороны, если \((X, Y)\) — пара непрерывных случайных величин, то дифференциальную совместную энтропию определяют как
Мы можем рассматривать (22.11.9) как меру общей случайности в паре случайных величин. В качестве крайнего случая, если \(X = Y\) — это две одинаковые случайные величины, то информация в паре в точности равна информации в одной из них, и мы получаем \(H(X, Y) = H(X) = H(Y)\). С другой стороны, если \(X\) и \(Y\) независимы, то \(H(X, Y) = H(X) + H(Y)\). Действительно, всегда выполняется, что информация, содержащаяся в паре случайных величин, не меньше энтропии любой из этих величин и не превышает сумму их энтропий.
Давайте реализуем совместную энтропию с нуля.
def joint_entropy(p_xy):
    joint_ent = -p_xy * torch.log2(p_xy)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(joint_ent)
    return out

joint_entropy(torch.tensor([[0.1, 0.5], [0.1, 0.3]]))
Заметим, что это тот же код, что и раньше, но теперь мы интерпретируем его иначе, как работающий с совместным распределением двух случайных величин.
22.11.3.2. Условная энтропия
Совместная энтропия, определённая выше, характеризует количество информации, содержащееся в паре случайных величин. Это полезно, но зачастую нас интересует не это. Рассмотрим задачу машинного обучения. Пусть \(X\) — это случайная величина (или вектор случайных величин), описывающая значения пикселей изображения, а \(Y\) — случайная величина, являющаяся меткой класса. \(X\) должно содержать существенное количество информации — натуральное изображение является сложным объектом. Однако количество информации, содержащееся в \(Y\) после того, как изображение было показано, должно быть небольшим. Действительно, изображение цифры уже должно содержать информацию о том, какая это цифра, если только цифра не неразборчива. Таким образом, чтобы расширить наш словарный запас в теории информации, нам необходимо уметь рассуждать о содержании информации в случайной величине при условии другой случайной величины.
В теории вероятностей мы видели определение условной вероятности для измерения взаимосвязи между переменными. Теперь мы хотим аналогичным образом определить условную энтропию \(H(Y \mid X)\). Мы можем записать это как
где \(p(y \mid x) = \frac{p_{X, Y}(x, y)}{p_X(x)}\) — условная вероятность. В частности, если \((X, Y)\) — пара дискретных случайных величин, то
Если \((X, Y)\) — пара непрерывных случайных величин, то дифференциальная условная энтропия определяется аналогичным образом как
Теперь естественно спросить, как условная энтропия \(H(Y \mid X)\) соотносится с энтропией \(H(X)\) и совместной энтропией \(H(X, Y)\)? Используя приведённые выше определения, мы можем выразить это следующим образом:
Это имеет интуитивное объяснение: информация в \(Y\) при условии \(X\) (\(H(Y \mid X)\)) равна информации, содержащейся одновременно в \(X\) и \(Y\) (\(H(X, Y)\)), за вычетом информации, уже содержащейся в \(X\). Таким образом, мы получаем информацию о \(Y\), которая не представлена в \(X\).
Теперь давайте реализуем условную энтропию (22.11.13) с нуля.
def conditional_entropy(p_xy, p_x):
    p_y_given_x = p_xy/p_x
    cond_ent = -p_xy * torch.log2(p_y_given_x)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(cond_ent)
    return out

conditional_entropy(torch.tensor([[0.1, 0.5], [0.2, 0.3]]),
                    torch.tensor([0.2, 0.8]))
22.11.3.3. Взаимная информация
Рассматривая предыдущее определение случайных величин \((X, Y)\), вы можете задаться вопросом: «Зная, сколько информации содержится в \(Y\), но не в \(X\), можем ли мы аналогично спросить, сколько информации совместно содержится в \(X\) и \(Y\)?» Ответом будет взаимная информация \((X, Y)\), которую мы будем обозначать как \(I(X, Y)\).
Вместо того чтобы сразу переходить к формальному определению, давайте потренируем интуицию, выведя выражение для взаимной информации, используя только ранее введенные понятия. Мы хотим найти информацию, общую для двух случайных величин. Один из способов сделать это — взять всю информацию, содержащуюся в \(X\) и \(Y\) вместе, а затем вычесть те части, которые не являются общими. Совокупная информация, содержащаяся в \(X\) и \(Y\), обозначается как \(H(X, Y)\). Мы хотим вычесть из нее информацию, содержащуюся в \(X\), но не в \(Y\), а также информацию, содержащуюся в \(Y\), но не в \(X\). Как мы видели в предыдущем разделе, это выражается через \(H(X \mid Y)\) и \(H(Y \mid X)\) соответственно. Таким образом, взаимная информация равна
Действительно, это корректное определение взаимной информации. Если раскрыть определения этих величин и объединить их, то несложные алгебраические преобразования показывают, что это эквивалентно
Все эти соотношения можно обобщить на рисунке Fig. 22.11.1. Отличным упражнением для проверки интуиции является понимание того, почему следующие утверждения также эквивалентны \(I(X, Y)\).
\(H(X) - H(X \mid Y)\)
\(H(Y) - H(Y \mid X)\)
\(H(X) + H(Y) - H(X, Y)\)
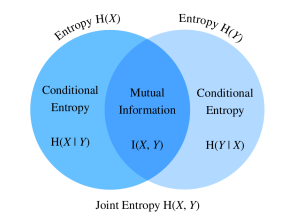
Fig. 22.11.1 Взаимосвязь взаимной информации с совместной энтропией и условной энтропией.
Во многих отношениях взаимную информацию (22.11.18) можно рассматривать как строгое обобщение коэффициента корреляции, рассмотренного в Section 22.6. Это позволяет нам оценивать не только линейные зависимости между переменными, но и максимальное количество информации, которой обмениваются две случайные величины любого типа.
Теперь давайте реализуем взаимную информацию с нуля.
def mutual_information(p_xy, p_x, p_y):
    p = p_xy / (p_x * p_y)
    mutual = p_xy * torch.log2(p)
    # Operator `nansum` will sum up the non-nan number
    out = nansum(mutual)
    return out

mutual_information(torch.tensor([[0.1, 0.5], [0.1, 0.3]]),
                   torch.tensor([0.2, 0.8]), torch.tensor([[0.75, 0.25]]))
22.11.3.4. Свойства взаимной информации
Вместо того чтобы заучивать определение взаимной информации (22.11.18), достаточно помнить её ключевые свойства:
Взаимная информация симметрична, т. е. \(I(X, Y) = I(Y, X)\).
Взаимная информация неотрицательна, то есть \(I(X, Y) \geq 0\).
\(I(X, Y) = 0\) тогда и только тогда, когда \(X\) и \(Y\) независимы. Например, если \(X\) и \(Y\) независимы, то знание \(Y\) не даёт никакой информации о \(X\) и наоборот, поэтому их взаимная информация равна нулю.
Или, если \(X\) является обратимой функцией от \(Y\), то \(Y\) и \(X\) содержат всю общую информацию, а
(22.11.19)¶\[I(X, Y) = H(Y) = H(X).\]
22.11.3.5. Точечная взаимная информация
Когда мы рассматривали энтропию в начале этой главы, мы смогли интерпретировать \(-\log(p_X(x))\) как степень нашего удивления конкретным исходом. Мы можем дать аналогичную интерпретацию логарифмическому члену во взаимной информации, который часто называют точечной взаимной информацией:
Мы можем рассматривать (22.11.20) как меру того, насколько более или менее вероятна конкретная комбинация исходов \(x\) и \(y\) по сравнению с тем, что мы ожидали бы для независимых случайных величин. Если значение велико и положительно, то эти два конкретных исхода происходят гораздо чаще, чем это было бы при случайном совпадении (примечание: знаменатель равен \(p_X(x) p_Y(y)\), что соответствует вероятности того, что два исхода были бы независимыми), тогда как если значение велико и отрицательно, это означает, что два исхода происходят значительно реже, чем мы ожидали бы при случайном совпадении.
Это позволяет интерпретировать взаимную информацию (22.11.18) как среднюю величину удивления от совместного появления двух исходов по сравнению с тем, что мы ожидали бы, если бы они были независимы.
22.11.3.6. Применение взаимной информации
Мутуальная информация может показаться немного абстрактной в своём чистом определении, так как же она связана с машинным обучением? В обработке естественного языка одной из самых сложных проблем является разрешение неоднозначности, или проблема неясности значения слова из контекста. Например, недавно в заголовке новостей сообщалось, что «Amazon горит». Вы можете задаться вопросом: горит ли здание компании Amazon или же горит амазонский лес.
В данном случае взаимная информация помогает разрешить эту неоднозначность. Сначала мы находим группу слов, каждое из которых имеет относительно высокую взаимную информацию со словом Amazon, обозначающим компанию, например: электронная коммерция, технологии и онлайн. Затем мы находим другую группу слов, каждое из которых имеет относительно высокую взаимную информацию со словом Amazon, обозначающим лес, например: дождь, лес и тропический. Когда необходимо устранить неоднозначность слова «Amazon», мы можем сравнить, какая из групп чаще встречается в контексте этого слова. В данном случае статья будет описывать лес, что прояснит контекст.
22.11.4. Расстояние Кульбака–Лейблера
Как мы обсуждали в Section 2.3, мы можем использовать нормы для измерения расстояния между двумя точками в пространстве любой размерности. Мы хотели бы иметь возможность выполнять аналогичную задачу с распределениями вероятностей. Существует множество способов сделать это, но теория информации предлагает один из самых элегантных. Теперь мы рассмотрим дивергенцию Кульбака–Лейблера (KL-дивергенцию), которая позволяет измерить, насколько близки друг к другу два распределения.
22.11.4.1. Определение
Пусть задана случайная величина \(X\), подчиняющаяся распределению вероятностей \(P\) с плотностью вероятности или функцией вероятности \(p(x)\), а распределение вероятностей \(P\) аппроксимируется другим распределением вероятностей \(Q\) с плотностью вероятности или функцией вероятности \(q(x)\). Тогда дивергенция Кульбака–Лейблера (или относительная энтропия) между \(P\) и \(Q\) равна
Как и в случае с взаимной информацией для отдельных событий (22.11.20), мы можем дать интерпретацию логарифмическому члену: \(-\log \frac{q(x)}{p(x)} = -\log(q(x)) - (-\log(p(x)))\) будет большим и положительным, если мы наблюдаем \(x\) гораздо чаще при распределении \(P\), чем ожидалось бы при распределении \(Q\), и большим и отрицательным, если результат наблюдается значительно реже ожидаемого. Таким образом, его можно интерпретировать как нашу относительную удивлённость при наблюдении результата по сравнению с тем, насколько удивительным мы сочли бы этот результат, исходя из нашего справочного распределения.
Давайте реализуем расхождение Кульбака–Лейблера с нуля.
def kl_divergence(p, q):
    kl = p * torch.log2(p / q)
    out = nansum(kl)
    return out.abs().item()
22.11.4.2. Свойства расхождения Кульбака–Лейблера
Рассмотрим некоторые свойства расхождения Кульбака–Лейблера (22.11.21).
Расстояние Кульбака–Лейблера несимметрично, то есть существуют \(P,Q\) такие, что
(22.11.22)¶\[D_{\textrm{KL}}(P\|Q) \neq D_{\textrm{KL}}(Q\|P).\]Расстояние Кульбака–Лейблера неотрицательно, то есть
(22.11.23)¶\[D_{\textrm{KL}}(P\|Q) \geq 0.\]. Обратите внимание, что равенство достигается только тогда, когда \(P = Q\).
Если существует \(x\), такое что \(p(x) > 0\) и \(q(x) = 0\), то \(D_{\textrm{KL}}(P\|Q) = \infty\).
Существует тесная связь между дивергенцией Кульбака–Лейблера и взаимной информацией. Помимо соотношения, показанного в Fig. 22.11.1, величина, заданная в \(I(X, Y)\), также численно эквивалентна следующим выражениям:
\(D_{\textrm{KL}}(P(X, Y) \ \| \ P(X)P(Y))\);
\(E_Y \{ D_{\textrm{KL}}(P(X \mid Y) \ \| \ P(X)) \}\);
\(E_X \{ D_{\textrm{KL}}(P(Y \mid X) \ \| \ P(Y)) \}\).
Для первого слагаемого мы интерпретируем взаимную информацию как расхождение Кульбака — Лейблера между \(P(X, Y)\) и произведением \(P(X)\) и \(P(Y)\), и, следовательно, она является мерой того, насколько совместное распределение отличается от распределения, которое было бы в случае независимости. Для второго слагаемого взаимная информация показывает среднее уменьшение неопределённости относительно \(Y\), возникающее при получении информации о значении распределения \(X\). Аналогично для третьего слагаемого.
22.11.4.3. Пример
Рассмотрим пример, чтобы явно продемонстрировать несимметричность.
Сначала сгенерируем и отсортируем три тензора длины \(10,000\): целевой тензор \(p\), имеющий нормальное распределение \(N(0, 1)\), и два тензора-кандидата \(q_1\) и \(q_2\), имеющие нормальные распределения \(N(-1, 1)\) и \(N(1, 1)\) соответственно.
torch.manual_seed(1)

tensor_len = 10000
p = torch.normal(0, 1, (tensor_len, ))
q1 = torch.normal(-1, 1, (tensor_len, ))
q2 = torch.normal(1, 1, (tensor_len, ))

p = torch.sort(p)[0]
q1 = torch.sort(q1)[0]
q2 = torch.sort(q2)[0]
Поскольку \(q_1\) и \(q_2\) симметричны относительно оси y (то есть \(x=0\)), мы ожидаем схожего значения расхождения Кульбака–Лейблера между \(D_{\textrm{KL}}(p\|q_1)\) и \(D_{\textrm{KL}}(p\|q_2)\). Как видно ниже, разница между \(D_{\textrm{KL}}(p\|q_1)\) и \(D_{\textrm{KL}}(p\|q_2)\) составляет менее 3%.
kl_pq1 = kl_divergence(p, q1)
kl_pq2 = kl_divergence(p, q2)
similar_percentage = abs(kl_pq1 - kl_pq2) / ((kl_pq1 + kl_pq2) / 2) * 100

kl_pq1, kl_pq2, similar_percentage
В отличие от этого, вы можете обнаружить, что \(D_{\textrm{KL}}(q_2 \|p)\) и \(D_{\textrm{KL}}(p \| q_2)\) часто оказываются выключенными, причём около 40% из них выключены, как показано ниже.
kl_q2p = kl_divergence(q2, p)
differ_percentage = abs(kl_q2p - kl_pq2) / ((kl_q2p + kl_pq2) / 2) * 100

kl_q2p, differ_percentage
22.11.5. Перекрёстная энтропия
Если вас интересует применение теории информации в глубоком обучении, вот краткий пример. Мы определим истинное распределение \(P\) с помощью распределения вероятностей \(p(x)\), а оценочное распределение \(Q\) — с помощью распределения вероятностей \(q(x)\), и будем использовать их в остальной части этого раздела.
Предположим, что нам нужно решить задачу бинарной классификации на основе заданных \(n\) примеров данных {\(x_1, \ldots, x_n\)}. Пусть метки положительного и отрицательного классов \(y_i\) закодированы как \(1\) и \(0\) соответственно, а наша нейронная сеть параметризована с помощью \(\theta\). Если мы стремимся найти оптимальные параметры \(\theta\), обеспечивающие условие \(\hat{y}_i= p_{\theta}(y_i \mid x_i)\), то естественно применить подход максимального логарифмического правдоподобия, как это было рассмотрено в Section 22.7. Конкретно, для истинных меток \(y_i\) и предсказаний \(\hat{y}_i= p_{\theta}(y_i \mid x_i)\) вероятность отнесения к положительному классу равна \(\pi_i= p_{\theta}(y_i = 1 \mid x_i)\). Следовательно, функция логарифмического правдоподобия будет иметь вид
Максимизация функции правдоподобия \(l(\theta)\) эквивалентна минимизации \(- l(\theta)\), поэтому наилучшее значение \(\theta\) можно найти именно так. Чтобы обобщить приведённую выше функцию потерь на любые распределения, мы также называем \(-l(\theta)\) перекрёстной энтропией \(\textrm{CE}(y, \hat{y})\), где \(y\) соответствует истинному распределению \(P\), а \(\hat{y}\) — оценённому распределению \(Q\).
Всё это было выведено исходя из точки зрения максимального правдоподобия. Однако, если присмотреться, можно заметить, что в наших вычислениях появились такие члены, как \(\log(\pi_i)\), что является надёжным указанием на то, что данное выражение можно понять с позиций теории информации.
22.11.5.1. Формальное определение
Как и расхождение Кульбака–Лейблера, для случайной величины \(X\) мы можем измерить расхождение между оценочным распределением \(Q\) и истинным распределением \(P\) с помощью перекрёстной энтропии,
Используя свойства энтропии, рассмотренные выше, мы можем также интерпретировать её как сумму энтропии \(H(P)\) и расхождения Кульбака–Лейблера между \(P\) и \(Q\), то есть
Мы можем реализовать функцию потерь перекрёстной энтропии следующим образом.
def cross_entropy(y_hat, y):
    ce = -torch.log(y_hat[range(len(y_hat)), y])
    return ce.mean()
Теперь определим два тензора для меток и предсказаний и вычислим перекрёстную энтропию между ними.
labels = torch.tensor([0, 2])
preds = torch.tensor([[0.3, 0.6, 0.1], [0.2, 0.3, 0.5]])

cross_entropy(preds, labels)
22.11.5.2. Свойства
Как упоминалось в начале этого раздела, перекрёстная энтропия (22.11.25) может быть использована для определения функции потерь в задаче оптимизации. Оказывается, следующие утверждения эквивалентны:
Максимизация предсказательной вероятности \(Q\) для распределения \(P\) (т. е. \(E_{x \sim P} [\log (q(x))]\));
Минимизация перекрёстной энтропии \(\textrm{CE} (P, Q)\);
Минимизация расхождения Кульбака–Лейблера \(D_{\textrm{KL}}(P\|Q)\).
Определение перекрёстной энтропии косвенно доказывает эквивалентность между второй и третьей целевыми функциями, при условии, что энтропия истинных данных \(H(P)\) постоянна.
22.11.5.3. Перекрёстная энтропия как целевая функция многоклассовой классификации
Если мы углубимся в целевую функцию классификации с перекрёстной энтропией в качестве функции потерь \(\textrm{CE}\), то обнаружим, что минимизация \(\textrm{CE}\) эквивалентна максимизации функции логарифмического правдоподобия \(L\).
Прежде всего предположим, что нам дан набор данных, содержащий \(n\) примеров, и его можно классифицировать на \(k\) классов. Для каждого примера данных \(i\) любую метку \(k\)-го класса \(\mathbf{y}_i = (y_{i1}, \ldots, y_{ik})\) мы представляем с помощью one-hot encoding. Конкретнее, если пример \(i\) принадлежит классу \(j\), то мы устанавливаем значение \(j\)-го элемента равным \(1\), а всех остальных компонентов — равными \(0\), то есть
Например, если задача многоклассовой классификации содержит три класса \(A\), \(B\) и \(C\), то метки объектов \(\mathbf{y}_i\) могут быть закодированы в {\(A: (1, 0, 0); B: (0, 1, 0); C: (0, 0, 1)\)}.
Предположим, что наша нейронная сеть параметризована \(\theta\). Для истинных векторов меток \(\mathbf{y}_i\) и предсказаний
Следовательно, потери перекрёстной энтропии будут равны
С другой стороны, мы можем подойти к этой задаче с помощью метода максимального правдоподобия. Для начала кратко введем распределение Мультиноми с \(k\) классами. Это расширение распределения Бернулли с бинарного класса на многоклассовый. Если случайная величина \(\mathbf{z} = (z_{1}, \ldots, z_{k})\) подчиняется распределению Мультиноми с \(k\) классами и вероятностями \(\mathbf{p} =\) (\(p_{1}, \ldots, p_{k}\)), то есть
, то функция совместной вероятности (p.m.f.) для \(\mathbf{z}\) равна
Видно, что метка каждого примера данных \(\mathbf{y}_i\) подчиняется \(k\)-классному мультиномиальному распределению с вероятностями \(\boldsymbol{\pi} =\) (\(\pi_{1}, \ldots, \pi_{k}\)). Следовательно, совместная функция вероятности (p.m.f.) каждого примера данных \(\mathbf{y}_i\) равна \(\mathbf{\pi}^{\mathbf{y}_i} = \prod_{j=1}^k \pi_{j}^{y_{ij}}.\). Таким образом, функция логарифмического правдоподобия имеет вид
Поскольку в методе максимального правдоподобия мы максимизируем целевую функцию \(l(\theta)\), используя \(\pi_{j} = p_{\theta} (y_{ij} \mid \mathbf{x}_i)\), то для любой задачи классификации на несколько классов максимизация приведённой выше функции правдоподобия \(l(\theta)\) эквивалентна минимизации функции потерь перекрестной энтропии (CE) \(\textrm{CE}(y, \hat{y})\).
Чтобы проверить приведённое выше доказательство, применим встроенную
меру NegativeLogLikelihood. Используя те же labels и preds,
что и в предыдущем примере, мы получим то же численное значение функции
потерь, что и в предыдущем примере, с точностью до пяти знаков после
запятой.
# Implementation of cross-entropy loss in PyTorch combines `nn.LogSoftmax()`
# and `nn.NLLLoss()`
nll_loss = NLLLoss()
loss = nll_loss(torch.log(preds), labels)
loss
22.11.6. Итоги
Теория информации — это область изучения кодирования, декодирования, передачи и обработки информации.
Энтропия — это мера количества информации, содержащейся в различных сигналах.
Расстояние Кульбака — Лейблера также может измерять расхождение между двумя распределениями.
Перекрёстную энтропию можно рассматривать как целевую функцию задачи многоклассовой классификации. Минимизация функции потерь перекрёстной энтропии эквивалентна максимизации функции правдоподобия.
22.11.7. Упражнения
Убедитесь, что примеры карт из первого раздела действительно обладают заявленной энтропией.
Покажите, что расхождение Кульбака — Лейблера \(D(p\|q)\) неотрицательно для любых распределений \(p\) и \(q\). Подсказка: используйте неравенство Йенсена, то есть тот факт, что \(-\log x\) является выпуклой функцией.
Вычислим энтропию для нескольких источников данных:
Предположим, вы наблюдаете за выводом, генерируемым обезьяной на пишущей машинке. Обезьяна нажимает любую из \(44\) клавиш случайным образом (можно предположить, что она ещё не обнаружила никаких специальных клавиш или клавишу Shift). Сколько бит случайности на символ вы наблюдаете?
Разочаровавшись в обезьяне, вы заменили её на пьяного наборщика. Он способен генерировать слова, пусть и бессвязные. Вместо этого он выбирает случайное слово из словаря, содержащего \(2,000\) слов. Предположим, что средняя длина слова в английском языке составляет \(4.5\) букв. Сколько бит случайности на символ вы наблюдаете теперь?
Все ещё оставаясь недовольным результатом, вы заменяете наборщик на высококачественную языковую модель. В настоящее время языковая модель может достигать перплексии, равной \(15\) баллам на слово. Перплексия perplexity языковой модели определяется как величина, обратная геометрическому среднему набора вероятностей, где каждой вероятности соответствует символ в слове. Конкретнее, если длина заданного слова составляет \(l\), то \(\textrm{PPL}(\textrm{word}) = \left[\prod_i p(\textrm{character}_i)\right]^{ -\frac{1}{l}} = \exp \left[ - \frac{1}{l} \sum_i{\log p(\textrm{character}_i)} \right].\). Предположим, что тестовое слово состоит из 4,5 букв. Сколько битов случайности на символ вы наблюдаете теперь?
Объясните интуитивно, почему \(I(X, Y) = H(X) - H(X \mid Y)\). Затем покажите, что это верно, выразив обе части как математическое ожидание относительно совместного распределения.
Чему равно расхождение Кульбака–Лейблера между двумя гауссовскими распределениями \(\mathcal{N}(\mu_1, \sigma_1^2)\) и \(\mathcal{N}(\mu_2, \sigma_2^2)\)?