
9.7. Обратное распространение ошибки через время
Если вы выполнили упражнения из Section 9.5, то заметили, что обрезка градиентов имеет решающее значение для предотвращения периодических экстремальных значений градиентов, которые могут дестабилизировать обучение. Мы упоминали, что взрыв градиентов возникает из-за обратного распространения ошибки по длинным последовательностям. Прежде чем переходить к обзору современных архитектур рекуррентных нейронных сетей, давайте подробнее разберем математическую сторону того, как работает обратное распространение в моделях последовательностей. Надеемся, что это обсуждение поможет прояснить понятия затухающих и взрывающихся градиентов. Если вы помните наше обсуждение прямого и обратного распространения через вычислительные графы при введении многослойных персептронов в Section 5.3, то прямое распространение в рекуррентных нейронных сетях покажется вам относительно простым. Применение обратного распространения в рекуррентных нейронных сетях называется обратным распространением через время (Werbos, 1990). Эта процедура требует развертки (или раскрутки) вычислительного графа рекуррентной нейронной сети шаг за шагом. Развернутая рекуррентная нейронная сеть по сути является прямолинейной нейронной сетью со специальным свойством: одни и те же параметры повторяются во всей развернутой сети, появляясь на каждом временном шаге. Затем, как и в любой прямолинейной нейронной сети, мы можем применить цепное правило, распространяя градиенты обратно через развернутую сеть. Градиент по каждому параметру должен быть просуммирован по всем местам, где этот параметр встречается в развернутой сети. Работа с таким связыванием весов должна быть вам знакома из глав, посвященных свёрточным нейронным сетям.
Осложнения возникают из-за того, что последовательности могут быть довольно длинными. Работа с текстовыми последовательностями, состоящими из более чем тысячи токенов, — обычное дело. Обратите внимание, что это создает проблемы как с точки зрения вычислений (нехватка памяти), так и с точки зрения оптимизации (численная неустойчивость). Входные данные с первого шага проходят через более 1000 матричных произведений, прежде чем попасть на выход, и ещё около 1000 матричных произведений требуется для вычисления градиента. Теперь мы проанализируем, что может пойти не так, и как решить эти проблемы на практике.
9.7.1. Анализ градиентов в RNN
Рассмотрим упрощённую модель работы рекуррентной нейронной сети. Эта модель не учитывает детали, касающиеся специфики скрытого состояния и механизма его обновления. Приведённая здесь математическая нотация явно не различает скаляры, векторы и матрицы. Мы лишь стремимся развить интуитивное понимание. В рамках данной упрощённой модели обозначим \(h_t\) как скрытое состояние, \(x_t\) как вход, а \(o_t\) — как выход на шаге времени \(t\). Вспомним обсуждение из Section 9.4.2, в котором отмечалось, что вход и скрытое состояние могут быть объединены перед умножением на единую переменную веса в скрытом слое. Следовательно, мы используем \(w_\textrm{h}\) и \(w_\textrm{o}\) для обозначения весов скрытого слоя и выходного слоя соответственно. В результате скрытые состояния и выходы на каждом шаге времени представляют собой
где \(f\) и \(g\) — это преобразования скрытого слоя и выходного слоя соответственно. Таким образом, мы получаем цепочку значений \(\{\ldots, (x_{t-1}, h_{t-1}, o_{t-1}), (x_{t}, h_{t}, o_t), \ldots\}\), которые зависят друг от друга посредством рекуррентных вычислений. Прямое распространение выполняется довольно просто. Нам нужно лишь один раз пройти по тройкам \((x_t, h_t, o_t)\), шаг за шагом. Расхождение между выходом \(o_t\) и желаемой целевой переменной \(y_t\) затем оценивается с помощью целевой функции по всем \(T\) временным шагам как
Для обратного распространения ошибки ситуация обстоит немного сложнее, особенно при вычислении градиентов по параметрам \(w_\textrm{h}\) целевой функции \(L\). А именно, согласно цепному правилу,
Первый и второй множители произведения в (9.7.3) вычислить несложно. Третий множитель \(\partial h_t/\partial w_\textrm{h}\) — вот где кроется сложность, поскольку нам необходимо рекуррентно вычислять влияние параметра \(w_\textrm{h}\) на \(h_t\). Согласно рекуррентному вычислению в (9.7.1), \(h_t\) зависит как от \(h_{t-1}\), так и от \(w_\textrm{h}\), при этом вычисление \(h_{t-1}\) также зависит от \(w_\textrm{h}\). Таким образом, применение цепного правила для нахождения полной производной \(h_t\) по \(w_\textrm{h}\) даёт
Чтобы вывести приведённый выше градиент, предположим, что у нас есть три последовательности \(\{a_{t}\},\{b_{t}\},\{c_{t}\}\), удовлетворяющие условиям \(a_{0}=0\) и \(a_{t}=b_{t}+c_{t}a_{t-1}\) для \(t=1, 2,\ldots\). Тогда для \(t\geq 1\) легко показать
Подставляя \(a_t\), \(b_t\) и \(c_t\) согласно
вычисление градиента в (9.7.4) удовлетворяет \(a_{t}=b_{t}+c_{t}a_{t-1}\). Следовательно, согласно (9.7.5), мы можем исключить рекуррентное вычисление в (9.7.4) с помощью
Хотя мы можем использовать цепное правило для рекурсивного вычисления \(\partial h_t/\partial w_\textrm{h}\), эта цепочка может становиться очень длинной, когда \(t\) велико. Давайте обсудим ряд стратегий решения этой проблемы.
9.7.1.1. Полное вычисление
Одна из идей — вычислить полную сумму в (9.7.7). Однако это очень медленно, а градиенты могут расходиться, поскольку малейшие изменения начальных условий могут существенно повлиять на результат. Иными словами, мы можем наблюдать явления, подобные эффекту бабочки, когда минимальные изменения начальных условий приводят к непропорционально большим изменениям результата. Это, как правило, нежелательно. В конце концов, мы ищем устойчивые оценщики, которые хорошо обобщаются. Поэтому на практике эту стратегию почти никогда не используют.
9.7.1.2. Отсечение временных шагов
В качестве альтернативы мы можем усечь сумму в (9.7.7) после \(\tau\) шагов. Именно это мы и обсуждали до сих пор. Это приводит к приближению истинного градиента за счёт обрыва суммы на \(\partial h_{t-\tau}/\partial w_\textrm{h}\). На практике это работает довольно хорошо. Этот подход обычно называют усечённым обратным распространением во времени (Jaeger, 2002). Одним из следствий такого подхода является то, что модель фокусируется преимущественно на краткосрочном влиянии, а не на долгосрочных последствиях. На самом деле это желательно, поскольку это смещает оценку в сторону более простых и стабильных моделей.
9.7.1.3. Случайное усечение
Наконец, мы можем заменить \(\partial h_t/\partial w_\textrm{h}\) случайной величиной, которая является несмещённой в смысле математического ожидания, но усечёт последовательность. Это достигается за счёт использования последовательности \(\xi_t\) с заранее определёнными \(0 \leq \pi_t \leq 1\), где \(P(\xi_t = 0) = 1-\pi_t\) и \(P(\xi_t = \pi_t^{-1}) = \pi_t\), следовательно, \(E[\xi_t] = 1\). Мы используем это для замены градиента \(\partial h_t/\partial w_\textrm{h}\) в (9.7.4) на
Из определения \(\xi_t\) следует, что выполняется \(E[z_t] = \partial h_t/\partial w_\textrm{h}\). Как только \(\xi_t = 0\), рекуррентные вычисления завершаются на этом временном шаге \(t\). Это приводит к взвешенной сумме последовательностей различной длины, где длинные последовательности встречаются редко, но имеют соответствующий избыточный вес. Эта идея была предложена в работе Tallec and Ollivier (2017).
9.7.1.4. Сравнение стратегий
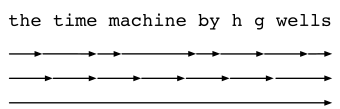
Fig. 9.7.1 Сравнение стратегий вычисления градиентов в RNN. Сверху вниз: случайное усечение, регулярное усечение и полное вычисление.
Fig. 9.7.1 иллюстрирует три стратегии при анализе первых нескольких символов книги «Машина времени» с использованием обратного распространения ошибки во времени для рекуррентных нейронных сетей:
Первая строка соответствует случайному усечению, которое разбивает текст на сегменты различной длины.
Вторая строка соответствует регулярному усечению, при котором текст разбивается на подпоследовательности одинаковой длины. Именно этот подход мы использовали в экспериментах с RNN.
Третья строка соответствует полному обратному распространению ошибки по времени, что приводит к вычислительно неосуществимому выражению.
К сожалению, хотя на теоретическом уровне рандомизированное усечение выглядит привлекательно, на практике оно работает не намного лучше обычного, скорее всего из-за ряда факторов. Во-первых, влияние наблюдения, полученного после нескольких шагов обратного распространения ошибки в прошлое, оказывается вполне достаточным для захвата зависимостей на практике. Во-вторых, возросшая дисперсия нивелирует тот факт, что градиент становится более точным при увеличении числа шагов. В-третьих, нам на самом деле хочется, чтобы модели имели лишь короткую область взаимодействия. Таким образом, регулярное усечение обратного распространения ошибки через время оказывает небольшое регуляризующее действие, которое может оказаться желательным.
9.7.2. Подробный разбор обратного распространения ошибки по времени
Рассмотрев общий принцип, перейдём к подробному разбору обратного распространения ошибки через время. В отличие от анализа в Section 9.7.1, далее мы покажем, как вычислять градиенты целевой функции по всем параметрам модели. Для простоты рассмотрим рекуррентную нейронную сеть без параметров смещения, в которой функция активации скрытого слоя задаётся тождественным отображением (\(\phi(x)=x\)). Для временного шага \(t\) пусть входной пример и целевая переменная равны \(\mathbf{x}_t \in \mathbb{R}^d\) и \(y_t\) соответственно. Скрытое состояние \(\mathbf{h}_t \in \mathbb{R}^h\) и выход \(\mathbf{o}_t \in \mathbb{R}^q\) вычисляются как
где \(\mathbf{W}_\textrm{hx} \in \mathbb{R}^{h \times d}\), \(\mathbf{W}_\textrm{hh} \in \mathbb{R}^{h \times h}\) и \(\mathbf{W}_\textrm{qh} \in \mathbb{R}^{q \times h}\) — параметры весов. Обозначим через \(l(\mathbf{o}_t, y_t)\) функцию потерь на шаге времени \(t\). Наша целевая функция, представляющая собой сумму потерь на \(T\) шагах времени от начала последовательности, имеет вид
Чтобы визуализировать зависимости между переменными модели и параметрами в процессе вычислений RNN, можно построить граф вычислений для модели, как показано на рисунке Fig. 9.7.2. Например, вычисление скрытых состояний для шага времени 3, \(\mathbf{h}_3\), зависит от параметров модели \(\mathbf{W}_\textrm{hx}\) и \(\mathbf{W}_\textrm{hh}\), скрытого состояния предыдущего шага времени \(\mathbf{h}_2\) и входа текущего шага времени \(\mathbf{x}_3\).
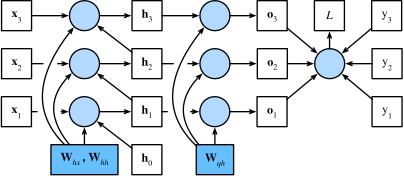
Fig. 9.7.2 Граф вычислений, демонстрирующий зависимости в модели RNN с тремя временными шагами. Прямоугольники обозначают переменные (не заштрихованные) или параметры (заштрихованные), а круги — операторы.
Как уже упоминалось, параметрами модели в Fig. 9.7.2 являются \(\mathbf{W}_\textrm{hx}\), \(\mathbf{W}_\textrm{hh}\) и \(\mathbf{W}_\textrm{qh}\). Как правило, обучение этой модели требует вычисления градиентов по этим параметрам \(\partial L/\partial \mathbf{W}_\textrm{hx}\), \(\partial L/\partial \mathbf{W}_\textrm{hh}\) и \(\partial L/\partial \mathbf{W}_\textrm{qh}\). Исходя из зависимостей, показанных в Fig. 9.7.2, мы можем двигаться в направлении, противоположном стрелкам, чтобы последовательно вычислять и сохранять градиенты. Чтобы гибко выражать умножение матриц, векторов и скаляров различных размерностей в рамках цепного правила, мы продолжаем использовать оператор \(\textrm{prod}\), как описано в Section 5.3.
Прежде всего, дифференцирование целевой функции по выходу модели на любом временном шаге \(t\) является достаточно простой задачей:
Теперь мы можем вычислить градиент функции потерь по параметру \(\mathbf{W}_\textrm{qh}\) выходного слоя: \(\partial L/\partial \mathbf{W}_\textrm{qh} \in \mathbb{R}^{q \times h}\). Согласно Fig. 9.7.2, функция потерь \(L\) зависит от \(\mathbf{W}_\textrm{qh}\) через \(\mathbf{o}_1, \ldots, \mathbf{o}_T\). Применяя цепное правило, получаем
где \(\partial L/\partial \mathbf{o}_t\) определяется выражением (9.7.11).
Далее, как показано в Fig. 9.7.2, на последнем временном шаге \(T\) целевая функция \(L\) зависит от скрытого состояния \(\mathbf{h}_T\) только через \(\mathbf{o}_T\). Следовательно, мы можем легко вычислить градиент \(\partial L/\partial \mathbf{h}_T \in \mathbb{R}^h\), используя цепное правило:
Для любого временного шага \(t < T\) ситуация усложняется, поскольку целевая функция \(L\) зависит от \(\mathbf{h}_t\) через \(\mathbf{h}_{t+1}\) и \(\mathbf{o}_t\). Согласно цепному правилу, градиент скрытого состояния \(\partial L/\partial \mathbf{h}_t \in \mathbb{R}^h\) на любом временном шаге \(t < T\) может быть вычислен рекуррентно следующим образом:
Для анализа раскроем рекуррентное вычисление для любого временного шага \(1 \leq t \leq T\):
Как видно из (9.7.15), даже этот простой линейный пример уже демонстрирует некоторые ключевые проблемы моделей с длинными последовательностями: он включает потенциально очень большие степени \(\mathbf{W}_\textrm{hh}^\top\). В нём собственные значения, меньшие единицы, затухают, а собственные значения, большие единицы, расходятся. Это численно неустойчиво, что проявляется в виде исчезающих и взрывающихся градиентов. Одним из способов решения этой проблемы является усечение временных шагов до вычислительно удобного размера, как обсуждалось в Section 9.7.1. На практике это усечение также можно реализовать, открепляя градиент после заданного количества временных шагов. Позже мы увидим, как более сложные модели последовательностей, такие как долгая краткосрочная память, могут дополнительно смягчить эту проблему.
Наконец, Fig. 9.7.2 показывает, что целевая функция \(L\) зависит от параметров модели \(\mathbf{W}_\textrm{hx}\) и \(\mathbf{W}_\textrm{hh}\) в скрытом слое через скрытые состояния \(\mathbf{h}_1, \ldots, \mathbf{h}_T\). Чтобы вычислить градиенты по этим параметрам \(\partial L / \partial \mathbf{W}_\textrm{hx} \in \mathbb{R}^{h \times d}\) и \(\partial L / \partial \mathbf{W}_\textrm{hh} \in \mathbb{R}^{h \times h}\), мы применяем цепное правило, что даёт
где \(\partial L/\partial \mathbf{h}_t\), которое рекуррентно вычисляется с помощью (9.7.13) и (9.7.14), является ключевой величиной, влияющей на численную устойчивость.
Поскольку обратное распространение ошибки через время представляет собой применение обратного распространения ошибки в рекуррентных нейронных сетях, как мы объяснили в Section 5.3, обучение RNN чередует прямое распространение с обратным распространением ошибки через время. Кроме того, обратное распространение ошибки через время последовательно вычисляет и сохраняет указанные выше градиенты. В частности, сохранённые промежуточные значения повторно используются для избежания избыточных вычислений, например, значение \(\partial L/\partial \mathbf{h}_t\) сохраняется для использования при вычислении как \(\partial L / \partial \mathbf{W}_\textrm{hx}\), так и \(\partial L / \partial \mathbf{W}_\textrm{hh}\).
9.7.3. Резюме
Обратное распространение ошибки через время — это лишь применение обратного распространения ошибки к моделям последовательностей со скрытым состоянием. Для удобства вычислений и численной устойчивости применяется усечение, например, регулярное или случайное. Высокие степени матриц могут приводить к расходящимся или исчезающим собственным значениям. Это проявляется в виде взрывающихся или исчезающих градиентов. Для эффективных вычислений промежуточные значения кэшируются во время обратного распространения ошибки через время.
9.7.4. Упражнения
Предположим, что у нас есть симметричная матрица \(\mathbf{M} \in \mathbb{R}^{n \times n}\) с собственными значениями \(\lambda_i\), которым соответствуют собственные векторы \(\mathbf{v}_i\) (\(i = 1, \ldots, n\)). Без ограничения общности предположим, что они упорядочены в порядке \(|\lambda_i| \geq |\lambda_{i+1}|\).
Покажите, что \(\mathbf{M}^k\) имеет собственные значения \(\lambda_i^k\).
Докажите, что для случайного вектора \(\mathbf{x} \in \mathbb{R}^n\) с высокой вероятностью \(\mathbf{M}^k \mathbf{x}\) будет сильно совпадать по направлению с собственным вектором \(\mathbf{v}_1\) матрицы \(\mathbf{M}\). Сформулируйте это утверждение строго.
Что означает вышеприведённый результат для градиентов в RNN?
Помимо обрезки градиента, можете ли вы придумать другие методы борьбы с взрывом градиента в рекуррентных нейронных сетях?