
13.2. Асинхронные вычисления
Современные компьютеры — это высокопараллельные системы, состоящие из нескольких ядер ЦП (часто с несколькими потоками на ядро), множества вычислительных элементов на GPU и, как правило, нескольких GPU на одном устройстве. Проще говоря, мы можем обрабатывать множество различных задач одновременно, часто на разных устройствах. К сожалению, Python не является удобным языком для написания параллельного и асинхронного кода, по крайней мере, без дополнительной поддержки. В конце концов, Python однопоточный, и маловероятно, что в будущем это изменится. Фреймворки глубокого обучения, такие как MXNet и TensorFlow, используют модель асинхронного программирования для повышения производительности, тогда как PyTorch использует собственный планировщик Python, что приводит к иному компромиссу в производительности. В PyTorch по умолчанию операции на GPU являются асинхронными. Когда вы вызываете функцию, использующую GPU, операции ставятся в очередь на соответствующее устройство, но не обязательно выполняются сразу. Это позволяет выполнять больше вычислений параллельно, включая операции на ЦП или других GPU.
Таким образом, понимание принципов асинхронного программирования помогает создавать более эффективные программы, за счет заблаговременного снижения вычислительных требований и взаимных зависимостей. Это позволяет уменьшить накладные расходы на память и повысить загрузку процессора.
import os
import subprocess
import numpy
import torch
from torch import nn
from d2l import torch as d2l
13.2.1. Асинхронность через бэкенд
Для разминки рассмотрим следующую простую задачу: мы хотим сгенерировать
случайную матрицу и умножить её. Выполним это действие как в NumPy, так
и с помощью тензоров PyTorch, чтобы увидеть разницу. Обратите внимание,
что PyTorch tensor определён на GPU.
# Warmup for GPU computation
device = d2l.try_gpu()
a = torch.randn(size=(1000, 1000), device=device)
b = torch.mm(a, a)

with d2l.Benchmark('numpy'):
    for _ in range(10):
        a = numpy.random.normal(size=(1000, 1000))
        b = numpy.dot(a, a)

with d2l.Benchmark('torch'):
    for _ in range(10):
        a = torch.randn(size=(1000, 1000), device=device)
        b = torch.mm(a, a)
Результаты бенчмарка через PyTorch оказались на несколько порядков быстрее. Скалярное произведение NumPy выполняется на процессоре CPU, тогда как матричное умножение PyTorch выполняется на GPU, поэтому последнее должно быть значительно быстрее. Однако огромная разница во времени указывает на то, что происходит что-то ещё. По умолчанию операции GPU в PyTorch являются асинхронными. Принудительное завершение всех вычислений PyTorch перед возвратом показывает, что происходило ранее: вычисления выполняются бэкендом, в то время как фронтенд возвращает управление Python.
with d2l.Benchmark():
    for _ in range(10):
        a = torch.randn(size=(1000, 1000), device=device)
        b = torch.mm(a, a)
    torch.cuda.synchronize(device)
В целом, PyTorch состоит из фронтенда для прямого взаимодействия с пользователями (например, через Python) и бэкенда, который используется системой для выполнения вычислений. Как показано на рисунке Fig. 13.2.1, пользователи могут писать программы на PyTorch на различных языках фронтенда, таких как Python и C++. Независимо от выбранного языка фронтенда, выполнение программ PyTorch происходит преимущественно в бэкенде, реализованном на C++. Операции, вызываемые через фронтенд, передаются в бэкенд для выполнения. Бэкенд управляет собственными потоками, которые непрерывно собирают и выполняют задачи из очереди. Обратите внимание, что для этого бэкенд должен отслеживать зависимости между различными этапами вычислительного графа. Следовательно, невозможно распараллелить операции, зависящие друг от друга.
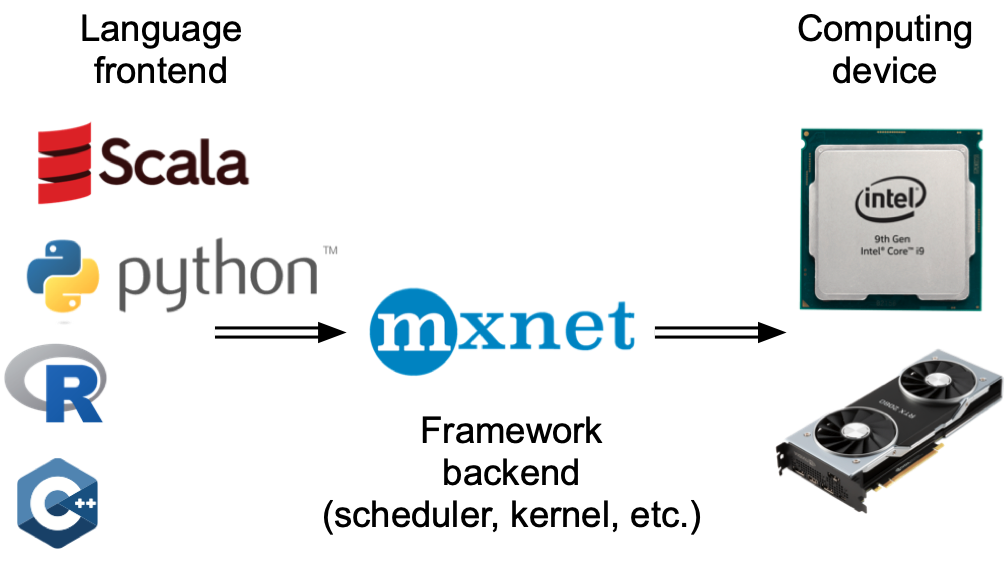
Fig. 13.2.1 Фронтенды языков программирования и бэкенды фреймворков глубокого обучения.
Рассмотрим ещё один учебный пример, чтобы лучше понять граф зависимостей.
x = torch.ones((1, 2), device=device)
y = torch.ones((1, 2), device=device)
z = x * y + 2
z
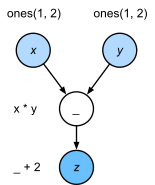
Fig. 13.2.2 Бэкенд отслеживает зависимости между различными шагами вычислительного графа.
Приведённый выше фрагмент кода также проиллюстрирован на рисунке
Fig. 13.2.2. Всякий раз, когда поток Python-фронтенда
выполняет одно из первых трёх утверждений, он просто возвращает задачу в
очередь бэкенда. Когда требуется вывести результаты последнего
утверждения, поток Python-фронтенда будет ожидать завершения вычисления
результата переменной z потоком C++-бэкенда. Одним из преимуществ
такого подхода является то, что поток Python-фронтенда не должен
выполнять фактические вычисления. Таким образом, на общую
производительность программы оказывается минимальное влияние, независимо
от скорости работы Python. На рисунке Fig. 13.2.3 показано
взаимодействие между фронтендом и бэкендом.
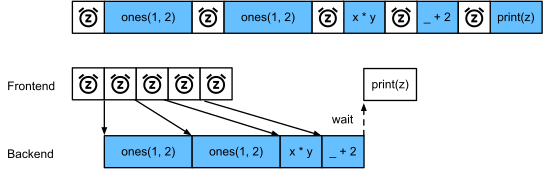
Fig. 13.2.3 Взаимодействие фронтенда и бэкенда.
13.2.2. Барьеры и блоки
13.2.3. Улучшение вычислений
13.2.4. Итоги
Фреймворки глубокого обучения могут разделять Python-интерфейс и бэкенд выполнения. Это позволяет быстро асинхронно добавлять команды в бэкенд и обеспечивает параллелизм.
Асинхронность обеспечивает достаточно отзывчивый интерфейс. Однако следует соблюдать осторожность, чтобы не переполнять очередь задач, так как это может привести к чрезмерному потреблению памяти. Рекомендуется синхронизировать работу для каждого мини-батча, чтобы фронтенд и бэкенд оставались примерно синхронизированными.
Производители чипов предлагают сложные инструменты анализа производительности, позволяющие получить гораздо более детальное представление об эффективности глубокого обучения.
13.2.5. Упражнения
На процессоре выполните бенчмарк тех же операций матричного умножения, что и в этом разделе. Удается ли по-прежнему наблюдать асинхронность через бэкенд?