
17. Обучение с подкреплением
Практик Чоудхари (Университет Пенсильвании и Amazon), Расул Факар (Amazon) и Кавош Асади (Amazon)
Обучение с подкреплением (Reinforcement Learning, RL) — это набор методов, позволяющих создавать системы машинного обучения, принимающие решения последовательно. Например, посылка с новой одеждой, купленной в интернет-магазине, попадает к вам домой после последовательности решений: магазин находит одежду на складе, ближайшем к вашему дому, упаковывает её в коробку, транспортирует коробку наземным или воздушным транспортом и доставляет её в ваш город. На пути следования посылки на неё влияет множество переменных, например, была ли одежда в наличии на складе, сколько времени заняла транспортировка коробки, прибыла ли она в ваш город до отправления ежедневного грузовика и т. д. Ключевая идея заключается в том, что на каждом этапе эти переменные, которыми мы обычно не управляем, влияют на всю последовательность будущих событий. Например, если на складе возникли задержки с упаковкой коробки, магазину может потребоваться отправить посылку воздушным транспортом вместо наземного, чтобы обеспечить своевременную доставку. Методы обучения с подкреплением позволяют нам предпринимать соответствующие действия на каждом этапе задачи последовательного принятия решений, чтобы в конечном итоге максимизировать некоторую полезность, например, своевременную доставку посылки вам.
Такие задачи последовательного принятия решений встречаются во многих других областях. Например, в игре [Go](https://en.wikipedia.org/wiki/Go_(game) ваш текущий ход определяет следующие ходы, а ходы противника — это переменные, которые вы не можете контролировать… последовательность ходов в конечном итоге определяет, выиграете вы или нет; фильмы, которые Netflix рекомендует вам сейчас, определяют, что вы будете смотреть, а то, понравится ли вам фильм, неизвестно Netflix; в конечном итоге последовательность рекомендаций фильмов определяет, насколько вы удовлетворены сервисом Netflix. Сегодня методы обучения с подкреплением используются для разработки эффективных решений этих проблем (Mnih et al., 2013, Silver et al., 2016). Ключевое отличие обучения с подкреплением от стандартного глубокого обучения заключается в том, что в стандартном глубоком обучении предсказание обученной модели для одного тестового примера не влияет на предсказания для будущих тестовых примеров; в обучении с подкреплением решения в будущие моменты времени (в RL решения также называют действиями) зависят от того, какие решения были приняты ранее.
В этой главе мы разработаем основы обучения с подкреплением и получим практический опыт реализации некоторых популярных методов обучения с подкреплением. Сначала мы введем понятие марковского процесса принятия решений (MDP), которое позволяет рассматривать подобные задачи последовательного принятия решений. Алгоритм итерации значений станет нашим первым шагом к решению задач обучения с подкреплением при условии, что мы знаем, как обычно ведут себя неконтролируемые переменные в MDP (в контексте обучения с подкреплением эти неконтролируемые переменные называются средой). Используя более общую версию итерации значений — алгоритм Q-обучения, — мы сможем совершать подходящие действия, даже если у нас нет полного знания о среде. Затем мы изучим, как использовать глубокие сети для решения задач обучения с подкреплением путем имитации действий эксперта. И наконец, мы разработаем метод обучения с подкреплением, использующий глубокую сеть для принятия действий в неизвестных средах. Эти техники составляют основу более сложных алгоритмов RL, которые применяются сегодня в различных реальных задачах; некоторые из них мы рассмотрим в этой главе.
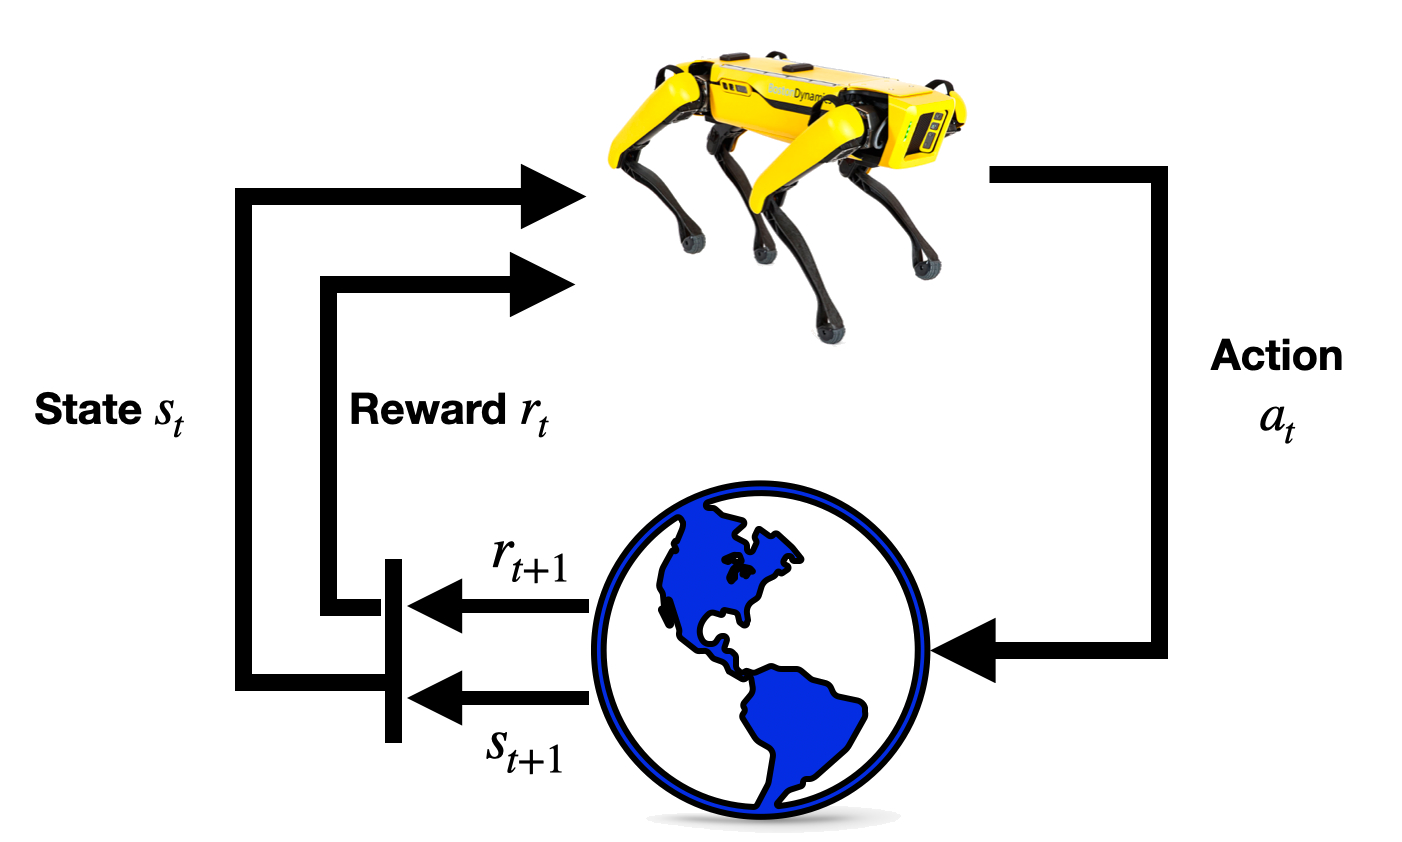
Fig. 17.1 Структура обучения с подкреплением
- 17.1. Марковский процесс принятия решений (MDP)
- 17.2. Итерация значений
- 17.2.1. Стохастическая политика
- 17.2.2. Функция значения
- 17.2.3. Функция значения действия
- 17.2.4. Оптимальная стохастическая политика
- 17.2.5. Принцип динамического программирования
- 17.2.6. Итерация значений
- 17.2.7. Оценка политики
- 17.2.8. Реализация итерации значений
- 17.2.9. Резюме
- 17.2.10. Упражнения
- 17.3. Q-обучение