
3.1. Линейная регрессия
Задачи регрессии возникают всякий раз, когда мы хотим предсказать числовое значение. Типичные примеры включают прогнозирование цен (на дома, акции и т. д.), продолжительности пребывания пациентов в больнице, спроса (при розничных продажах) и многие другие. Не каждая задача прогнозирования относится к классической регрессии. Позже мы рассмотрим задачи классификации, где цель состоит в том, чтобы предсказать принадлежность к одному из множества категорий.
В качестве рабочего примера предположим, что мы хотим оценить цены на дома (в долларах) на основе их площади (в квадратных футах) и возраста (в годах). Чтобы разработать модель для прогнозирования цен на дома, нам необходимо получить данные, включающие цену продажи, площадь и возраст для каждого дома. В терминологии машинного обучения набор данных называется обучающим набором или обучающей выборкой, а каждая строка (содержащая данные, соответствующие одной продаже) называется примером (или точкой данных, объектом, примером). То, что мы пытаемся предсказать (цену), называется меткой (или целевой переменной). Переменные (возраст и площадь), на основе которых строятся прогнозы, называются признаками (или ковариатами).
%matplotlib inline
import math
import time
import numpy as np
import torch
from d2l import torch as d2l
3.1.1. Основы
Линейная регрессия — это самый простой и наиболее популярный из стандартных инструментов для решения задач регрессии. Появившись в начале XIX века (Gauss, 1809, Legendre, 1805), линейная регрессия базируется на нескольких простых предположениях. Во-первых, мы предполагаем, что связь между признаками \(\mathbf{x}\) и целевой переменной \(y\) приблизительно линейна, то есть условное математическое ожидание \(E[Y \mid X=\mathbf{x}]\) можно выразить как взвешенную сумму признаков \(\mathbf{x}\). Такая постановка допускает, что значение целевой переменной может отклоняться от своего математического ожидания из-за шума наблюдений. Далее мы можем предположить, что подобный шум имеет хорошие свойства и подчиняется гауссовскому распределению. Обычно мы будем использовать \(n\) для обозначения количества примеров в нашем наборе данных. Мы используем верхние индексы для нумерации примеров и целевых переменных, а нижние индексы — для индексации координат. Более конкретно, \(\mathbf{x}^{(i)}\) обозначает \(i^{\textrm{th}}\) пример, а \(x_j^{(i)}\) — его \(j^{\textrm{th}}\) координату.
3.1.1.1. Модель
В основе каждого решения лежит модель, описывающая, как признаки преобразуются в оценку целевой переменной. Предположение о линейности означает, что математическое ожидание целевой переменной (цены) можно выразить как взвешенную сумму признаков (площади и возраста):
Здесь \(w_{\textrm{area}}\) и \(w_{\textrm{age}}\) называются весами, а \(b\) — смещением (или сдвигом или свободным членом). Веса определяют влияние каждого признака на наше предсказание. Смещение определяет значение оценки, когда все признаки равны нулю. Хотя мы никогда не встретим новые дома с площадью, точно равной нулю, нам всё равно необходимо смещение, поскольку оно позволяет нам выражать любые линейные функции наших признаков (а не ограничиваться только прямыми, проходящими через начало координат). Строго говоря, (3.1.1) представляет собой аффинное преобразование входных признаков, которое характеризуется линейным преобразованием признаков посредством взвешенной суммы, дополненным сдвигом за счёт добавленного смещения. Имея набор данных, наша цель — выбрать веса \(\mathbf{w}\) и смещение \(b\) так, чтобы в среднем предсказания нашей модели максимально точно соответствовали истинным ценам, наблюдаемым в данных.
В областях, где принято фокусироваться на наборах данных с небольшим количеством признаков, часто используют явное развёрнутое представление моделей, как в (3.1.1). В машинном обучении мы обычно имеем дело с многомерными наборами данных, где удобнее использовать компактную запись с помощью линейной алгебры. Если наши входные данные состоят из \(d\) признаков, мы можем пронумеровать каждый из них (индекс от \(1\) до \(d\)) и выразить наше предсказание \(\hat{y}\) (в общем случае символ «крышка» обозначает оценку) в виде
Объединив все признаки в вектор \(\mathbf{x} \in \mathbb{R}^d\) и все веса в вектор \(\mathbf{w} \in \mathbb{R}^d\), мы можем компактно выразить нашу модель через скалярное произведение между \(\mathbf{w}\) и \(\mathbf{x}\):
В (3.1.3) вектор \(\mathbf{x}\) соответствует признакам одного примера. Нам часто бывает удобно ссылаться на признаки всего нашего набора данных из \(n\) примеров с помощью матрицы признаков \(\mathbf{X} \in \mathbb{R}^{n \times d}\). Здесь \(\mathbf{X}\) содержит по одной строке для каждого примера и по одному столбцу для каждого признака. Для набора признаков \(\mathbf{X}\) прогнозы \(\hat{\mathbf{y}} \in \mathbb{R}^n\) можно выразить через произведение матрицы на вектор:
где транслирование (Section 2.1.4) применяется при суммировании. Имея признаки обучающего набора данных \(\mathbf{X}\) и соответствующие (известные) метки \(\mathbf{y}\), цель линейной регрессии заключается в нахождении вектора весов \(\mathbf{w}\) и смещения \(b\) таких, что для нового примера данных, сэмплированного из того же распределения, что и \(\mathbf{X}\), его метка будет предсказана (в математическом ожидании) с наименьшей ошибкой.
Даже если мы считаем, что наилучшей моделью для прогнозирования \(y\) по \(\mathbf{x}\) является линейная, мы не ожидаем найти реальный набор данных \(n\) примеров, в котором \(y^{(i)}\) в точности равно \(\mathbf{w}^\top \mathbf{x}^{(i)}+b\) для всех \(1 \leq i \leq n\). Например, какими бы инструментами мы ни измеряли признаки \(\mathbf{X}\) и метки \(\mathbf{y}\), всегда может присутствовать небольшая погрешность измерений. Поэтому, даже будучи уверенными в том, что лежащая в основе зависимость является линейной, мы вводим член шума, чтобы учесть подобные ошибки.
Прежде чем мы сможем приступить к поиску наилучших параметров (или параметров модели) \(\mathbf{w}\) и \(b\), нам понадобятся ещё две вещи: (i) мера качества заданной модели; и (ii) процедура обновления модели для повышения её качества.
3.1.1.2. Функция потерь
Естественно, чтобы подогнать нашу модель к данным, нам необходимо согласовать некоторую меру соответствия (или, что эквивалентно, несоответствия). Функции потерь измеряют расстояние между истинными и предсказанными значениями целевой переменной. Значение функции потерь обычно является неотрицательным числом, при этом меньшие значения лучше, а идеальное предсказание даёт потери, равные 0. Для задач регрессии наиболее распространённой функцией потерь является квадратичная ошибка. Когда наше предсказание для примера \(i\) равно \(\hat{y}^{(i)}\), а соответствующая истинная метка равна \(y^{(i)}\), квадратичная ошибка вычисляется следующим образом:
Константа \(\frac{1}{2}\) не играет существенной роли, но удобна для записи, поскольку она сокращается при взятии производной от функции потерь. Поскольку набор данных для обучения задан заранее и находится вне нашего контроля, эмпирическая ошибка зависит только от параметров модели. На рисунке Fig. 3.1.1 показана аппроксимация модели линейной регрессии для задачи с одномерными входными данными.
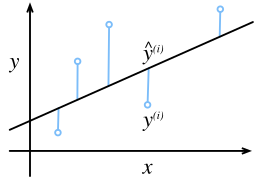
Fig. 3.1.1 Подгонка модели линейной регрессии к одномерным данным.
Обратите внимание, что большие расхождения между оценками \(\hat{y}^{(i)}\) и целевыми значениями \(y^{(i)}\) приводят к ещё большему вкладу в функцию потерь из-за её квадратичной формы (эта квадратичность может быть обоюдоострым мечом: хотя она стимулирует модель избегать больших ошибок, она также может приводить к чрезмерной чувствительности к аномальным данным). Чтобы оценить качество модели на всём наборе данных из \(n\) примеров, мы просто усредняем (или, что эквивалентно, суммируем) потери на обучающей выборке:
При обучении модели мы ищем параметры (\(\mathbf{w}^*, b^*\)), которые минимизируют суммарную функцию потерь по всем примерам обучающей выборки:
3.1.1.3. Аналитическое решение
В отличие от большинства моделей, которые мы рассмотрим, линейная регрессия представляет собой удивительно простую задачу оптимизации. В частности, мы можем найти оптимальные параметры (оцениваемые по обучающим данным) аналитически, применив следующую простую формулу. Сначала мы можем включить смещение \(b\) в параметр \(\mathbf{w}\), добавив к матрице признаков столбец, состоящий из одних единиц. Затем наша задача прогнозирования сводится к минимизации \(\|\mathbf{y} - \mathbf{X}\mathbf{w}\|^2\). При условии, что матрица признаков \(\mathbf{X}\) имеет полный ранг (ни один признак не является линейно зависимым от других), на поверхности функции потерь будет ровно одна критическая точка, которая соответствует минимуму функции потерь на всей области определения. Вычислив производную функции потерь по \(\mathbf{w}\) и приравняв её к нулю, получим:
Решение \(\mathbf{w}\) даёт нам оптимальное решение задачи оптимизации. Обратите внимание, что это решение
будет единственным только тогда, когда матрица \(\mathbf X^\top \mathbf X\) обратима, то есть когда столбцы матрицы признаков линейно независимы (Golub and Van Loan, 1996).
Хотя простые задачи, такие как линейная регрессия, могут иметь аналитические решения, не стоит привыкать к такому везению. Хотя аналитические решения позволяют проводить изящный математический анализ, требование наличия аналитического решения настолько ограничительно, что оно исключает почти все захватывающие аспекты глубокого обучения.
3.1.1.4. Мини-батч стохастический градиентный спуск
К счастью, даже в тех случаях, когда мы не можем решить модели аналитически, на практике мы всё же часто можем эффективно обучать модели. Более того, для многих задач оказывается, что эти сложные для оптимизации модели настолько лучше, что усилия по поиску способа их обучения в итоге полностью оправданы.
Ключевой метод оптимизации практически всех моделей глубокого обучения, который мы будем использовать на протяжении всей книги, заключается в итеративном уменьшении ошибки за счет обновления параметров в направлении, постепенно снижающем функцию потерь. Этот алгоритм называется градиентным спуском.
Самый простой подход к применению градиентного спуска заключается в вычислении производной функции потерь, которая представляет собой среднее значение потерь, вычисленных для каждого отдельного примера в наборе данных. На практике это может быть чрезвычайно медленно: нам необходимо пройти по всему набору данных перед выполнением одного обновления, даже если шаги обновления могут быть очень эффективными (Liu and Nocedal, 1989). Ещё хуже то, что если в обучающих данных присутствует значительная избыточность, то польза от полного обновления оказывается ограниченной.
Другой крайний случай — рассматривать только один пример за раз и выполнять обновление параметров на основе одного наблюдения. Полученный алгоритм, стохастический градиентный спуск (SGD), может быть эффективной стратегией (Bottou, 2010), даже для больших наборов данных. К сожалению, SGD имеет недостатки как вычислительного, так и статистического характера. Одна из проблем заключается в том, что процессоры значительно быстрее выполняют умножение и сложение чисел, чем перемещают данные из основной памяти в кэш процессора. Выполнение матрично-векторного умножения примерно на порядок эффективнее, чем выполнение соответствующего количества векторно-векторных операций. Это означает, что обработка одного примера за раз занимает гораздо больше времени по сравнению с обработкой полного батча. Вторая проблема заключается в том, что некоторые слои, такие как батч-нормализация (которая будет описана в Section 8.5), работают хорошо только тогда, когда мы имеем доступ более чем к одному наблюдению одновременно.
Решение обеих проблем заключается в выборе промежуточной стратегии: вместо того чтобы использовать полный батч или только один пример за раз, мы берём мини-батч наблюдений (Li et al., 2014). Конкретный выбор размера такого мини-батча зависит от множества факторов, таких как объём памяти, количество ускорителей, выбор слоёв и общий размер набора данных. Тем не менее хорошим начальным значением является число в диапазоне от 32 до 256, желательно кратное большой степени \(2\). Это приводит нас к стохастическому градиентному спуску на мини-батчах.
В самом базовом варианте в каждой итерации \(t\) мы сначала случайным образом выбираем мини-батч \(\mathcal{B}_t\), состоящий из фиксированного числа \(|\mathcal{B}|\) обучающих примеров. Затем мы вычисляем производную (градиент) средней функции потерь на мини-батче по параметрам модели. Наконец, мы умножаем градиент на заранее заданное небольшое положительное значение \(\eta\), называемое скоростью обучения, и вычитаем полученное значение из текущих значений параметров. Обновление можно выразить следующим образом:
Подводя итог, мини-батчный стохастический градиентный спуск (SGD) выполняется следующим образом: (i) инициализируем значения параметров модели, как правило, случайным образом; (ii) итеративно выбираем случайные мини-батчи из данных, обновляя параметры в направлении, противоположном градиенту. Для квадратичных функций потерь и аффинных преобразований это имеет аналитическое представление:
Поскольку мы выбираем мини-батч \(\mathcal{B}\), нам необходимо нормировать на его размер \(|\mathcal{B}|\). Размер мини-батча и скорость обучения часто задаются пользователем. Такие настраиваемые параметры, которые не обновляются в цикле обучения, называются гиперпараметрами. Их можно настраивать автоматически с помощью различных методов, таких как байесовская оптимизация (Frazier, 2018). В конечном итоге качество решения обычно оценивается на отдельном валидационном наборе данных (или валидационной выборке).
После обучения в течение заданного числа итераций (или до выполнения другого критерия остановки) мы фиксируем оценённые параметры модели, обозначаемые как \(\hat{\mathbf{w}}, \hat{b}\). Обратите внимание, что даже если наша функция действительно линейна и не содержит шума, эти параметры не будут точными минимизаторами функции потерь, а также не являются детерминированными. Хотя алгоритм медленно сходится к минимизаторам, на практике он обычно не находит их точно за конечное число шагов. Более того, мини-пакеты \(\mathcal{B}\), используемые для обновления параметров, выбираются случайным образом. Это нарушает детерминированность.
Линейная регрессия — это задача обучения, обладающая глобальным минимумом (когда \(\mathbf{X}\) имеет полный ранг, или, что эквивалентно, когда \(\mathbf{X}^\top \mathbf{X}\) обратима). Однако поверхности потерь глубоких сетей содержат множество седловых точек и локальных минимумов. К счастью, нас обычно не интересует поиск точного набора параметров, а лишь любого набора, обеспечивающего точные прогнозы (и, следовательно, низкое значение функции потерь). На практике специалисты по глубокому обучению редко сталкиваются с трудностями при поиске параметров, минимизирующих функцию потерь на обучающих наборах (Frankle and Carbin, 2018, Izmailov et al., 2018). Более сложной задачей является поиск параметров, обеспечивающих точные прогнозы на ранее не виденных данных, — проблема, известная как обобщающая способность. Мы будем возвращаться к этим темам на протяжении всей книги.
3.1.1.5. Прогнозы
Имея модель \(\hat{\mathbf{w}}^\top \mathbf{x} + \hat{b}\), мы можем теперь делать предсказания для нового примера, например, прогнозировать цену продажи ранее не встречавшегося дома, зная его площадь \(x_1\) и возраст \(x_2\). Практики в области глубокого обучения часто называют фазу предсказания выводом, но это не совсем точный термин: вывод в широком смысле означает любой вывод, сделанный на основе имеющихся данных, включая как значения параметров, так и вероятную метку для нового объекта. Если говорить точнее, в статистической литературе под выводом чаще понимают именно оценку параметров, и такое расширение значения термина создаёт ненужную путаницу при общении специалистов по глубокому обучению со статистиками. В дальнейшем мы будем по возможности использовать термин предсказание.
3.1.2. Векторизация для ускорения
При обучении моделей мы обычно хотим одновременно обрабатывать целые мини-пакеты примеров. Для этого необходимо векторизовать вычисления и использовать быстрые библиотеки линейной алгебры, а не писать дорогостоящие циклы for на Python.
Чтобы понять, почему это так важно, давайте рассмотрим два метода
сложения векторов. Сначала создадим два вектора размерности 10 000,
состоящие из единиц. В первом методе мы перебираем элементы векторов с
помощью цикла for в Python. Во втором — используем один вызов функции
+.
n = 10000
a = torch.ones(n)
b = torch.ones(n)
Теперь мы можем провести бенчмарк этих вычислений. Сначала мы складываем их, по одной координате за раз, используя цикл for.
c = torch.zeros(n)
t = time.time()
for i in range(n):
    c[i] = a[i] + b[i]
f'{time.time() - t:.5f} sec'
В качестве альтернативы мы используем перегруженный оператор + для
вычисления поэлементной суммы.
t = time.time()
d = a + b
f'{time.time() - t:.5f} sec'
Второй метод значительно быстрее первого. Векторизация кода часто обеспечивает ускорение на порядок величины. Кроме того, мы перекладываем больше математических операций на библиотеку, поэтому нам не нужно выполнять столько вычислений самостоятельно, что снижает вероятность ошибок и повышает переносимость кода.
3.1.3. Нормальное распределение и квадратичная функция потерь
До сих пор мы приводили достаточно прагматичное обоснование целевой функции квадратичной ошибки: оптимальные параметры возвращают условное математическое ожидание \(E[Y\mid X]\), когда лежащая в основе закономерность действительно линейна, а функция потерь накладывает большие штрафы на выбросы. Мы также можем дать более формальное обоснование целевой функции квадратичной ошибки, сделав вероятностные предположения о распределении шума.
Линейная регрессия была изобретена на рубеже XIX века. Хотя долгое время велись споры о том, кто первым предложил эту идею — Гаусс или Лежандр, именно Гаусс открыл нормальное распределение (также называемое гауссовским). Оказывается, что нормальное распределение и линейная регрессия с квадратичной функцией потерь связаны более глубоко, чем просто общим происхождением.
Для начала напомним, что нормальное распределение со средним \(\mu\) и дисперсией \(\sigma^2\) (стандартным отклонением \(\sigma\)) задаётся как
Ниже мы определяем функцию для вычисления нормального распределения.
def normal(x, mu, sigma):
    p = 1 / math.sqrt(2 * math.pi * sigma**2)
    return p * np.exp(-0.5 * (x - mu)**2 / sigma**2)
Теперь мы можем визуализировать нормальные распределения.
# Use NumPy again for visualization
x = np.arange(-7, 7, 0.01)

# Mean and standard deviation pairs
params = [(0, 1), (0, 2), (3, 1)]
d2l.plot(x, [normal(x, mu, sigma) for mu, sigma in params], xlabel='x',
         ylabel='p(x)', figsize=(4.5, 2.5),
         legend=[f'mean {mu}, std {sigma}' for mu, sigma in params])
Заметим, что изменение среднего значения соответствует сдвигу вдоль оси \(x\), а увеличение дисперсии приводит к растяжению распределения и снижению его пика.
Один из способов обосновать линейную регрессию с квадратичной функцией потерь заключается в предположении, что наблюдения представляют собой зашумлённые измерения, в которых шум \(\epsilon\) подчиняется нормальному распределению \(\mathcal{N}(0, \sigma^2)\):
Таким образом, мы можем теперь записать правдоподобие наблюдения конкретного \(y\) при заданном \(\mathbf{x}\) через
Таким образом, правдоподобие распадается на произведение. Согласно принципу максимального правдоподобия, наилучшие значения параметров \(\mathbf{w}\) и \(b\) — это те, которые максимизируют правдоподобие всего набора данных:
Равенство следует из того, что все пары \((\mathbf{x}^{(i)}, y^{(i)})\) выбирались независимо друг от друга. Оценки, полученные в соответствии с принципом максимального правдоподобия, называются оценками максимального правдоподобия. Хотя максимизация произведения многих экспоненциальных функций может показаться сложной задачей, мы можем существенно упростить вычисления, не меняя целевой функции, максимизируя вместо этого логарифм правдоподобия. По историческим причинам оптимизационные задачи чаще формулируются как задачи минимизации, а не максимизации. Следовательно, ничего не меняя, мы можем минимизировать отрицательный логарифм правдоподобия, что можно выразить следующим образом:
Если предположить, что \(\sigma\) фиксировано, можно опустить первый член, так как он не зависит от \(\mathbf{w}\) или \(b\). Второй член совпадает с функцией потерь квадратичной ошибки, рассмотренной ранее, за исключением мультипликативного коэффициента \(\frac{1}{\sigma^2}\). К счастью, решение также не зависит от \(\sigma\). Следовательно, минимизация среднеквадратичной ошибки эквивалентна методу максимального правдоподобия для линейной модели при предположении о наличии аддитивного гауссовского шума.
3.1.4. Линейная регрессия как нейронная сеть
Хотя линейные модели недостаточно богаты, чтобы выразить множество сложных сетей, которые мы рассмотрим в этой книге, (искусственные) нейронные сети достаточно богаты, чтобы включать линейные модели как частный случай сетей, в которых каждый признак представлен входным нейроном, все из которых напрямую соединены с выходом.
Fig. 3.1.2 показывает линейную регрессию в виде нейронной сети. На схеме выделен паттерн связности, например, то, как каждый вход соединён с выходом, но не указаны конкретные значения весов или смещений.
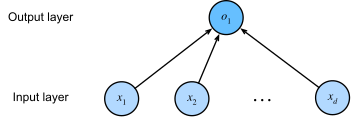
Fig. 3.1.2 Линейная регрессия — это однослойная нейронная сеть.
Входными данными являются \(x_1, \ldots, x_d\). Мы называем \(d\) числом входов или размерностью признаков входного слоя. Выходом сети является \(o_1\). Поскольку мы пытаемся предсказать лишь одно числовое значение, у нас есть только один выходной нейрон. Обратите внимание, что входные значения являются заданными. Существует лишь один вычисляемый нейрон. Таким образом, линейную регрессию можно рассматривать как однослойную полностью связанную нейронную сеть. В последующих главах мы встретим сети с гораздо большим числом слоёв.
3.1.4.1. Биология
Поскольку линейная регрессия предшествует вычислительной нейробиологии, может показаться анахронизмом описывать её в терминах нейронных сетей. Тем не менее, они стали естественным отправным пунктом, когда кибернетики и нейрофизиологи Уоррен Маккаллох и Уолтер Питтс начали разрабатывать модели искусственных нейронов. Рассмотрим упрощённое изображение биологического нейрона на рисунке Fig. 3.1.3, состоящее из дендритов (входных терминалов), ядра (процессора), аксона (выходного провода) и терминалов аксона (выходных терминалов), что позволяет устанавливать связи с другими нейронами посредством синапсов.
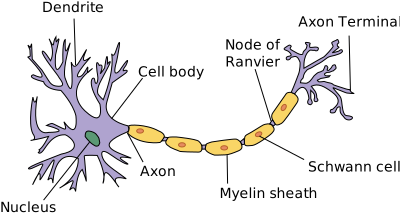
Fig. 3.1.3 Реальный нейрон (источник: «Анатомия и физиология», программа SEER (Surveillance, Epidemiology and End Results) Национального института рака США).
Информация \(x_i\), поступающая от других нейронов (или датчиков окружающей среды), принимается дендритами. В частности, эта информация взвешивается с помощью синаптических весов \(w_i\), определяющих влияние входных сигналов, например, активацию или торможение посредством произведения \(x_i w_i\). Взвешенные входные сигналы от множества источников суммируются в теле клетки как взвешенная сумма \(y = \sum_i x_i w_i + b\), которая затем может подвергаться нелинейной постобработке с помощью функции \(\sigma(y)\). Затем эта информация передается по аксону к его терминалям, откуда она достигает своей цели (например, эффектора, такого как мышца) или поступает в другой нейрон через его дендриты.
Действительно, высокоуровневая идея о том, что множество таких единиц можно объединить при наличии правильной структуры связей и алгоритма обучения, чтобы порождать поведение гораздо более интересное и сложное, чем то, которое способен выразить любой отдельный нейрон, возникла благодаря изучению реальных биологических нейронных систем. В то же время большинство современных исследований в области глубокого обучения черпает вдохновение из гораздо более широкого источника. Мы обращаемся к Russell and Norvig (2016), который отметил, что, хотя самолеты и могли быть вдохновлены птицами, орнитология уже несколько столетий не является главным двигателем инноваций в аэронавтике. Точно так же вдохновение в глубоком обучении сегодня в равной или даже большей степени приходит из математики, лингвистики, психологии, статистики, информатики и многих других областей.
3.1.5. Итоги
В этом разделе мы рассмотрели традиционную линейную регрессию, в которой параметры линейной функции выбираются так, чтобы минимизировать квадратичную функцию потерь на обучающей выборке. Мы также обосновали этот выбор целевой функции, опираясь на практические соображения и интерпретацию линейной регрессии как оценки максимального правдоподобия при предположении о линейности и гауссовском шуме. Обсудив вычислительные аспекты и связь со статистикой, мы показали, как такие линейные модели можно представить в виде простых нейронных сетей, где входы напрямую соединены с выходом. Хотя вскоре мы полностью откажемся от линейных моделей, они достаточны для введения большинства компонентов, необходимых всем нашим моделям: параметрических форм, дифференцируемых целевых функций, оптимизации с помощью стохастического градиентного спуска на мини-батчах и, в конечном счете, оценки на ранее не виденных данных.
3.1.6. Упражнения
Предположим, у нас есть некоторые данные \(x_1, \ldots, x_n \in \mathbb{R}\). Наша цель — найти константу \(b\), при которой \(\sum_i (x_i - b)^2\) минимизируется.
Найдите аналитическое решение для оптимального значения \(b\).
Как эта задача и её решение связаны с нормальным распределением?
Что произойдет, если мы заменим функцию потерь \(\sum_i (x_i - b)^2\) на \(\sum_i |x_i-b|\)? Можете ли вы найти оптимальное решение для \(b\)?
Докажите, что аффинные функции, представимые с помощью \(\mathbf{x}^\top \mathbf{w} + b\), эквивалентны линейным функциям на \((\mathbf{x}, 1)\).
Предположим, что мы хотим найти квадратичные функции от \(\mathbf{x}\), то есть \(f(\mathbf{x}) = b + \sum_i w_i x_i + \sum_{j \leq i} w_{ij} x_{i} x_{j}\). Как сформулировать это в глубокой сети?
Вспомним, что одним из условий разрешимости задачи линейной регрессии является то, что матрица признаков \(\mathbf{X}^\top \mathbf{X}\) имеет полный ранг.
Что произойдет, если это не так?
Как это исправить? Что произойдет, если добавить небольшое количество координатно независимого гауссова шума ко всем элементам \(\mathbf{X}\)?
Чему равно математическое ожидание матрицы дизайна \(\mathbf{X}^\top \mathbf{X}\) в этом случае?
Что происходит со стохастическим градиентным спуском, когда \(\mathbf{X}^\top \mathbf{X}\) не имеет полного ранга?
Предположим, что модель шума \(\epsilon\), описывающая аддитивный шум, соответствует экспоненциальному распределению. То есть \(p(\epsilon) = \frac{1}{2} \exp(-|\epsilon|)\).
Запишите отрицательное логарифмическое правдоподобие данных для модели \(-\log P(\mathbf y \mid \mathbf X)\).
Можете ли вы найти решение в замкнутой форме?
Предложите алгоритм стохастического градиентного спуска по мини-батчам для решения этой задачи. Что может пойти не так (подсказка: что происходит вблизи стационарной точки при постоянном обновлении параметров)? Можно ли это исправить?
Предположим, мы хотим спроектировать нейронную сеть с двумя слоями, объединив два линейных слоя. То есть выход первого слоя становится входом второго слоя. Почему такая наивная композиция не будет работать?
Что произойдет, если вы захотите использовать регрессию для реалистичной оценки цен на дома или акции?
Покажите, что предположение о прибавочном гауссовском шуме не является подходящим. Подсказка: могут ли цены быть отрицательными? А как насчёт колебаний?
Почему регрессия к логарифму цены будет гораздо лучше, т. е. \(y = \log \textrm{price}\)?
На что следует обратить внимание при работе с низколиквидными акциями (penny stocks), то есть акциями с очень низкой ценой? Подсказка: можно ли осуществлять торговлю по всем возможным ценам? Почему эта проблема более актуальна для дешевых акций? Для получения дополнительной информации ознакомьтесь с известной моделью Блэка–Шоулза для оценки опционов (Black and Scholes, 1973).
Предположим, мы хотим использовать регрессию для оценки количества проданных яблок в продуктовом магазине.
Каковы недостатки модели аддитивного гауссовского шума? Подсказка: вы продаете яблоки, а не нефть.
Распределение Пуассона Poisson distribution описывает распределения над целыми неотрицательными числами. Оно задается формулой \(p(k \mid \lambda) = \lambda^k e^{-\lambda}/k!\). Здесь \(\lambda\) — это параметр интенсивности, а \(k\) — количество наблюдаемых событий. Докажите, что \(\lambda\) является математическим ожиданием количества событий \(k\).
Разработайте функцию потерь, связанную с распределением Пуассона.
Разработайте функцию потерь для оценки \(\log \lambda\).