
16.6. Дообучение BERT для задач на уровне последовательностей и токенов
В предыдущих разделах этой главы мы рассмотрели различные модели для задач обработки естественного языка, такие как основанные на рекуррентных нейронных сетях (RNN), свёрточных нейронных сетях (CNN), механизмах внимания и многослойных перцептронах (MLP). Эти модели полезны при ограниченных вычислительных ресурсах или требованиях к времени работы, однако создание специализированной модели для каждой задачи обработки естественного языка практически нецелесообразно. В Section 15.8 мы представили модель предобучения BERT, которая требует минимальных изменений архитектуры для широкого спектра задач обработки естественного языка. С одной стороны, на момент своего появления BERT улучшил показатели state-of-the-art на множестве задач обработки естественного языка. С другой стороны, как отмечено в Section 15.10, две версии оригинальной модели BERT содержат 110 миллионов и 340 миллионов параметров соответственно. Таким образом, при наличии достаточных вычислительных ресурсов мы можем рассмотреть возможность дообучения BERT для прикладных задач обработки естественного языка.
В дальнейшем мы рассмотрим подмножество задач обработки естественного языка, разделив их на задачи на уровне последовательностей и на уровне токенов. На уровне последовательностей мы покажем, как преобразовать представление входного текста, полученное с помощью BERT, в метку для задач классификации одного текста или классификации/регрессии пары текстов. На уровне токенов мы кратко рассмотрим новые приложения, такие как тегирование текста и ответ на вопросы, и объясним, как BERT представляет входные данные и преобразует их в выходные метки. При дообучении «минимальные изменения архитектуры», необходимые BERT для различных приложений, — это дополнительные полносвязные слои. В процессе обучения с учителем для конкретной задачи параметры дополнительных слоёв обучаются с нуля, в то время как все параметры предварительно обученной модели BERT дообучаются.
16.6.1. Классификация отдельных текстов
Классификация одного текста принимает на вход одну текстовую последовательность и выдает результат её классификации. Помимо анализа тональности, который мы изучили в этой главе, набор данных Corpus of Linguistic Acceptability (CoLA) также предназначен для классификации одного текста: он определяет, является ли данное предложение грамматически допустимым или нет (Warstadt et al., 2019). Например, «I should study» является допустимым, а «I should studying» — нет.
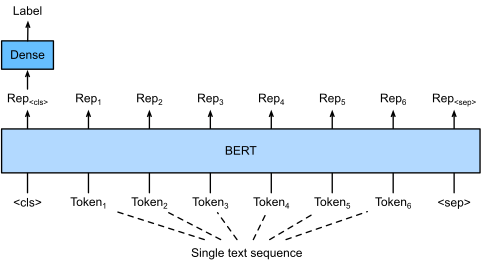
Fig. 16.6.1 Дообучение BERT для задач классификации отдельных текстов, таких как анализ тональности и проверка лингвистической приёмлемости. Предположим, что входной отдельный текст состоит из шести токенов.
Section 15.8 описывает представление входных данных BERT. Входная последовательность BERT однозначно представляет как одиночный текст, так и пары текстов: специальный токен классификации «<cls>» используется для классификации последовательности, а специальный токен «<sep>» обозначает конец одиночного текста или разделяет пару текстов. Как показано на рисунке Fig. 16.6.1, в задачах классификации одиночного текста представление специального токена «<cls>» кодирует информацию всей входной последовательности текста. В качестве представления входного одиночного текста оно подается в небольшую многослойный перцептрон (MLP), состоящий из полносвязных (плотных) слоёв, для получения распределения всех дискретных значений меток.
16.6.2. Классификация или регрессия пар текстов
Мы также рассмотрели задачу естественного языкового вывода в этой главе. Она относится к классификации текстовых пар — типу задач, в которых классифицируется пара текстов.
Задача регрессии текстовых пар (text pair regression), которая принимает на вход пару текстов, но выдает непрерывное значение, известна как семантическая текстовая схожесть (semantic textual similarity). Эта задача измеряет семантическую схожесть предложений. Например, в наборе данных Semantic Textual Similarity Benchmark оценка схожести пары предложений представляет собой порядковую шкалу от 0 (отсутствие смыслового перекрытия) до 5 (эквивалентность смыслов) (Cer et al., 2017). Цель состоит в том, чтобы предсказать эти оценки. Примеры из набора данных Semantic Textual Similarity Benchmark включают (предложение 1, предложение 2, оценка схожести):
«Самолот взлетает», «Самолёт взлетает», 5,000;
«Женщина ест что-то», «Женщина ест мясо», 3,000;
«Женщина танцует», «Мужчина говорит», 0,000.
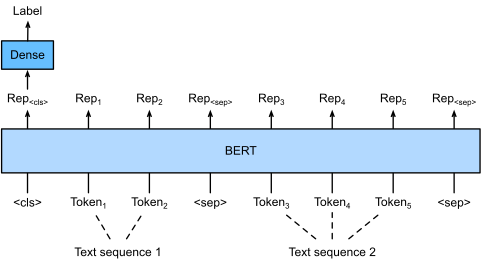
Fig. 16.6.2 Дообучение BERT для задач классификации или регрессии текстовых пар, таких как логический вывод и семантическое текстовое сходство. Предположим, что входная текстовая пара состоит из двух и трёх токенов.
В отличие от классификации одиночного текста в Fig. 16.6.1, дообучение BERT для классификации пар текстов в Fig. 16.6.2 отличается представлением входных данных. Для задач регрессии пар текстов, таких как семантическое текстовое сходство, можно применить простые изменения, например, выдавать непрерывное значение метки и использовать среднеквадратичную ошибку: это стандартные подходы для регрессии.
16.6.3. Разметка текста
Теперь рассмотрим задачи на уровне токенов, такие как разметка текста, где каждому токену присваивается метка. Среди задач разметки текста разметка частей речи (part-of-speech tagging) присваивает каждому слову тег части речи (например, прилагательное или определитель) в соответствии с ролью слова в предложении. Например, согласно набору тегов Penn Treebank II, предложение “John Smith ’s car is new” должно быть размечено как “NNP (существительное, единственное число, собственное) NNP POS (притяжательный суффикс) NN (существительное, единственное число или неисчисляемое) VB (глагол, базовая форма) JJ (прилагательное)”.
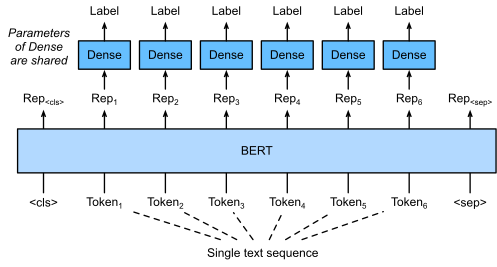
Fig. 16.6.3 Дообучение BERT для задач тегирования текста, таких как тегирование частей речи. Предположим, что входной текст состоит из шести токенов.
Дообучение BERT для задач тегирования текста показано на рисунке Fig. 16.6.3. В отличие от Fig. 16.6.1, единственное отличие заключается в том, что при тегировании текста представление каждого токена входного текста подается в одни и те же дополнительные полносвязные слои для получения метки токена, например, части речи.
16.6.4. Ответ на вопросы
В качестве ещё одного примера применения на уровне токенов, ответы на вопросы отражают способности к пониманию прочитанного. Например, набор данных Stanford Question Answering Dataset (SQuAD v1.1) состоит из текстовых отрывков и вопросов, где ответ на каждый вопрос — это фрагмент текста (текстовый спан) из отрывка, о котором идёт речь (Rajpurkar et al., 2016). Для пояснения рассмотрим отрывок «Некоторые эксперты сообщают, что эффективность масок неясна. Однако производители масок настаивают на том, что их продукция, например респираторы N95, может защищать от вируса», и вопрос «Кто говорит, что респираторы N95 могут защищать от вируса?». Ответом должен быть текстовый спан «производители масок» в отрывке. Таким образом, цель в SQuAD v1.1 заключается в предсказании начала и конца текстового спана в отрывке по паре «вопрос и отрывок».
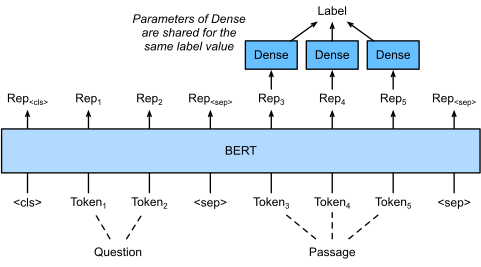
Fig. 16.6.4 Дообучение BERT для задач ответа на вопросы. Предположим, что входная пара текстов содержит два и три токена.
Для дообучения BERT на задаче ответа на вопросы вопрос и отрывок подаются на вход BERT в качестве первой и второй текстовых последовательностей соответственно. Для предсказания позиции начала текстового фрагмента тот же дополнительный полносвязный слой преобразует представление BERT любого токена из отрывка позиции \(i\) в скалярный балл \(s_i\). Такие баллы всех токенов отрывка далее преобразуются операцией софтмакс в распределение вероятностей, так что каждой позиции токена \(i\) в отрывке присваивается вероятность \(p_i\) того, что она является началом текстового фрагмента. Предсказание позиции конца текстового фрагмента аналогично описанному, за исключением того, что параметры его дополнительного полносвязного слоя независимы от параметров, используемых для предсказания начала. При предсказании конца любой токен отрывка позиции \(i\) преобразуется тем же полносвязным слоем в скалярный балл \(e_i\). Fig. 16.6.4 иллюстрирует дообучение BERT для ответа на вопросы.
Для задачи вопросно-ответного моделирования цель обучения с учителем столь же проста, как максимизация логарифмических правдоподобий истинных позиций начала и конца. При предсказании фрагмента мы можем вычислить оценку \(s_i + e_j\) для допустимого фрагмента, начинающегося в позиции \(i\) и заканчивающегося в позиции \(j\) (\(i \leq j\)), и выбрать фрагмент с наибольшей оценкой.
16.6.5. Итог
Для задач обработки естественного языка на уровне последовательности и токена, таких как классификация одиночного текста (например, анализ тональности и проверка лингвистической приёмлемости), классификация или регрессия пар текста (например, естественный языковой вывод и семантическое текстовое сходство), маркировка текста (например, разметка частей речи) и ответ на вопросы, BERT требует минимальных изменений архитектуры (добавления дополнительных полносвязных слоёв).
В процессе обучения с учителем для прикладной задачи параметры дополнительных слоёв обучаются с нуля, а все параметры предварительно обученной модели BERT дообучаются.
16.6.6. Упражнения
Давайте разработаем алгоритм поисковой системы для новостных статей. Когда система получает запрос (например, «нефтяная индустрия во время вспышки коронавируса»), она должна возвращать ранжированный список новостных статей, наиболее релевантных этому запросу. Предположим, что у нас есть огромный пул новостных статей и большое количество запросов. Для упрощения задачи предположим, что для каждого запроса уже размечена наиболее релевантная статья. Как мы можем применить отрицательную выборку (см. Section 15.2.1) и BERT при разработке алгоритма?
Как мы можем использовать BERT при обучении языковых моделей?
Можем ли мы использовать BERT в машинном переводе?