
9.1. Работа с последовательностями
До сих пор мы сосредотачивались на моделях, входные данные которых состояли из одного вектора признаков \(\mathbf{x} \in \mathbb{R}^d\). Основное изменение в подходе при разработке моделей, способных обрабатывать последовательности, заключается в том, что теперь мы фокусируемся на входах, состоящих из упорядоченного списка векторов признаков \(\mathbf{x}_1, \dots, \mathbf{x}_T\), где каждый вектор признаков \(\mathbf{x}_t\) индексирован временным шагом \(t \in \mathbb{Z}^+\), лежащим в \(\mathbb{R}^d\).
Некоторые наборы данных состоят из одной большой последовательности. Рассмотрим, например, чрезвычайно длинные потоки показаний датчиков, которые могут быть доступны климатологам. В таких случаях мы можем создавать обучающие наборы данных путем случайной выборки подпоследовательностей заданной длины. Чаще всего наши данные поступают в виде набора последовательностей. Рассмотрим следующие примеры: (i) набор документов, каждый из которых представлен как отдельная последовательность слов и имеет свою длину \(T_i\); (ii) представление последовательностей пребывания пациентов в больнице, где каждое пребывание состоит из ряда событий, а длина последовательности примерно зависит от продолжительности этого пребывания.
Ранее, при работе с отдельными примерами, мы предполагали, что они выбираются независимо из одного и того же распределения \(P(X)\). Хотя мы по-прежнему предполагаем, что целые последовательности (например, целые документы или траектории пациентов) выбираются независимо, мы не можем считать, что данные, поступающие на каждом временном шаге, независимы друг от друга. Например, слова, которые, вероятно, появятся позже в документе, сильно зависят от слов, встречающихся ранее в этом документе. Лекарство, которое, вероятно, получит пациент на 10-й день пребывания в больнице, сильно зависит от того, что происходило в предыдущие девять дней.
Это не должно вызывать удивления. Если бы мы не полагали, что элементы в последовательности связаны, нам не имело бы смысла моделировать их как последовательность с самого начала. Рассмотрим полезность функций автозаполнения, популярных в поисковых системах и современных почтовых клиентах. Они полезны именно потому, что часто можно предсказать (неточно, но лучше, чем случайный выбор), каковы могут быть вероятные продолжения последовательности, зная некоторый начальный префикс. Для большинства моделей последовательностей нам не требуется независимость или даже стационарность самих последовательностей. Вместо этого достаточно лишь того, чтобы последовательности выбирались из некоторого фиксированного базового распределения над множеством всех возможных последовательностей.
Этот гибкий подход позволяет учитывать такие явления, как (i) значительные различия между началом и концом документа; (ii) изменение состояния пациента в ходе госпитализации, которое может развиваться как в сторону выздоровления, так и в сторону летального исхода; (iii) предсказуемое изменение вкусов клиента в процессе продолжительного взаимодействия с рекомендательной системой.
Иногда нам нужно предсказать фиксированную целевую переменную \(y\) на основе входных данных с последовательной структурой (например, классификация тональности на основе кинокритики). В других случаях мы хотим предсказать целевую переменную с последовательной структурой (\(y_1, \ldots, y_T\)) на основе фиксированного входа (например, генерация подписей к изображениям). В иных ситуациях наша цель — предсказывать последовательные целевые переменные на основе последовательных входных данных (например, машинный перевод или генерация описаний видео). Такие задачи «последовательность-в-последовательность» имеют две формы: (i) выровненные, когда вход на каждом временном шаге соответствует соответствующей целевой переменной (например, разметка частей речи); (ii) невыровненные, когда вход и целевая переменная не обязательно демонстрируют пошаговое соответствие (например, машинный перевод).
Прежде чем разбираться с целевыми переменными любого вида, мы можем решить наиболее простую задачу: ненадзорное моделирование плотности (также называемое моделированием последовательностей). В этом случае, имея набор последовательностей, наша цель — оценить функцию вероятностной массы, которая показывает, насколько вероятно появление любой заданной последовательности, то есть \(p(\mathbf{x}_1, \ldots, \mathbf{x}_T)\).
%matplotlib inline
import torch
from torch import nn
from d2l import torch as d2l
9.1.1. Авторегрессионные модели
Прежде чем переходить к рассмотрению специализированных нейронных сетей, предназначенных для работы с данными, имеющими последовательную структуру, давайте посмотрим на реальные последовательные данные и сформулируем базовые интуитивные представления и статистические инструменты. В частности, мы сосредоточимся на данных о ценах акций индекса FTSE 100 (Fig. 9.1.1). На каждом шаге по времени \(t \in \mathbb{Z}^+\) мы наблюдаем цену \(x_t\) индекса в этот момент.
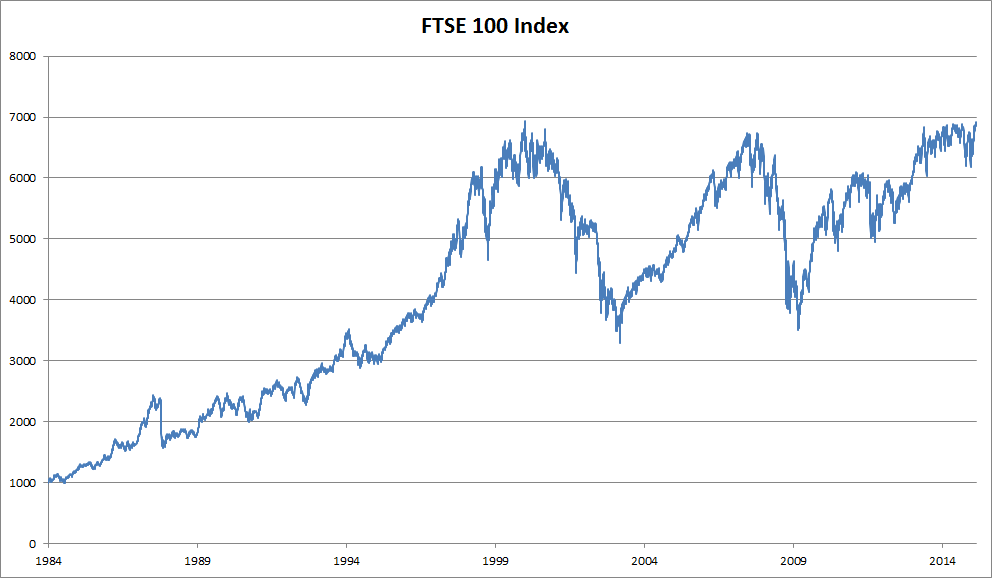
Fig. 9.1.1 Индекс FTSE 100 за примерно 30 лет.
Теперь предположим, что трейдер хочет совершать краткосрочные сделки, стратегически входя в индекс или выходя из него, в зависимости от того, считает ли он, что индекс вырастет или упадет на следующем временном шаге. При отсутствии других признаков (новостей, данных финансовой отчетности и т. д.) единственным доступным сигналом для прогнозирования следующего значения является история цен на текущий момент. Таким образом, трейдеру интересно узнать распределение вероятностей
по значениям, которые может принять индекс на следующем временном шаге. Хотя оценка всего распределения непрерывной случайной величины может быть сложной задачей, трейдеру было бы удобно сосредоточиться на нескольких ключевых статистиках этого распределения, в частности на математическом ожидании и дисперсии. Одна простая стратегия оценки условного математического ожидания
одним из вариантов было бы применение модели линейной регрессии (напомним Section 3.1). Такие модели, которые регрессируют значение сигнала на его предыдущие значения, естественно называются авторегрессионными моделями. Существует лишь одна серьезная проблема: количество входных данных, \(x_{t-1}, \ldots, x_1\), варьируется в зависимости от \(t\). Иными словами, число входных признаков увеличивается по мере того, как мы сталкиваемся с новыми данными. Таким образом, если мы хотим рассматривать наши исторические данные как обучающую выборку, мы сталкиваемся с проблемой, при которой каждый пример имеет разное количество признаков. Большая часть того, что будет рассмотрено в этой главе, будет вращаться вокруг методов преодоления этих трудностей при решении задач авторегрессионного моделирования, где объектом интереса является \(P(x_t \mid x_{t-1}, \ldots, x_1)\) или некоторые статистики этого распределения.
Некоторые стратегии встречаются довольно часто. Прежде всего, можно предположить, что, хотя доступны длинные последовательности \(x_{t-1}, \ldots, x_1\), при прогнозировании ближайшего будущего нет необходимости заглядывать так далеко в историю. В этом случае мы можем ограничиться условными данными на окне длины \(\tau\), используя только \(x_{t-1}, \ldots, x_{t-\tau}\) наблюдений. Немедленное преимущество заключается в том, что теперь количество аргументов всегда одинаково, по крайней мере для \(t > \tau\). Это позволяет нам обучать любые линейные модели или глубокие сети, которые требуют векторы фиксированной длины в качестве входа. Во-вторых, мы можем разработать модели, которые поддерживают некоторую сводку \(h_t\) прошлых наблюдений (см. Fig. 9.1.2) и одновременно обновляют \(h_t\) наряду с прогнозом \(\hat{x}_t\). Это приводит к моделям, которые оценивают не только \(x_t\) с помощью \(\hat{x}_t = P(x_t \mid h_{t})\), но и обновления вида \(h_t = g(h_{t-1}, x_{t-1})\). Поскольку \(h_t\) никогда не наблюдается, такие модели также называют латентными авторегрессионными моделями.
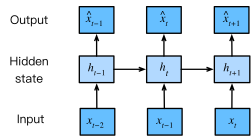
Fig. 9.1.2 Скрытая авторегрессионная модель.
Для формирования обучающих данных из исторических наблюдений примеры обычно создают путем случайной выборки окон. В общем случае мы не ожидаем, что время будет стоять на месте. Однако часто предполагается, что, хотя конкретные значения \(x_t\) могут меняться, динамика, определяющая генерацию каждого последующего наблюдения на основе предыдущих, остается неизменной. Статистики называют такую неизменную динамику стационарной.
9.1.2. Модели последовательностей
Иногда, особенно при работе с языковыми данными, нам необходимо оценить совместную вероятность всей последовательности. Это распространенная задача при работе с последовательностями, состоящими из дискретных токенов, таких как слова. Как правило, такие оцениваемые функции называют моделями последовательностей, а для данных естественного языка их называют языковыми моделями. Область моделирования последовательностей во многом развивалась благодаря обработке естественного языка, поэтому мы часто называем модели последовательностей «языковыми моделями», даже когда имеем дело с данными, не относящимися к языку. Языковые модели оказываются полезными по многим причинам. Иногда нам нужно оценить правдоподобие предложений. Например, мы можем захотеть сравнить естественность двух вариантов вывода, сгенерированных системой машинного перевода или системой распознавания речи. Однако языковое моделирование дает нам не только возможность оценивать правдоподобие, но и способность выбирать последовательности, а также оптимизировать их для получения наиболее вероятных вариантов.
Хотя языковое моделирование на первый взгляд может не выглядеть как авторегрессионная задача, мы можем свести его к авторегрессионному прогнозированию, разложив совместную плотность последовательности \(p(x_1, \ldots, x_T)\) в произведение условных плотностей слева направо с помощью цепного правила вероятности:
Обратите внимание, что при работе с дискретными сигналами, такими как слова, авторегрессионная модель должна быть вероятностным классификатором, выдающим полное распределение вероятностей по словарю для того слова, которое последует далее, с учётом контекста слева.
9.1.2.1. Модели Маркова
Предположим теперь, что мы хотим применить описанную выше стратегию, при которой мы учитываем только \(\tau\) предыдущих временных шагов, то есть \(x_{t-1}, \ldots, x_{t-\tau}\), а не всю историю последовательности \(x_{t-1}, \ldots, x_1\). Всякий раз, когда мы можем отбросить историю, предшествующую предыдущим \(\tau\) шагам, без потери предсказательной силы, мы говорим, что последовательность удовлетворяет условию Маркова, то есть будущее условно независимо от прошлого при условии недавней истории. Когда \(\tau = 1\), мы говорим, что данные описываются моделью Маркова первого порядка, а когда \(\tau = k\), мы говорим, что данные описываются \(k^{\textrm{th}}\)-порядковой моделью Маркова. Поскольку выполняется условие Маркова первого порядка (\(\tau = 1\)), разложение нашей совместной вероятности становится произведением вероятностей каждого слова при условии предыдущего слова:
Часто оказывается полезным использовать модели, которые работают так, как будто выполняется условие Маркова, даже если мы знаем, что это верно лишь приблизительно. В реальных текстовых документах мы продолжаем получать новую информацию по мере включения всё более широкого контекста слева. Однако эти приросты информации быстро убывают. Таким образом, иногда мы идём на компромисс, избегая вычислительных и статистических трудностей за счёт обучения моделей, корректность которых зависит от \(k^{\textrm{th}}\)-порядкового условия Маркова. Даже современные масштабные языковые модели на основе RNN и трансформеров редко учитывают контекст объёмом более нескольких тысяч слов.
Для дискретных данных истинная марковская модель просто подсчитывает, сколько раз каждое слово встречалось в каждом контексте, получая оценку относительной частоты \(P(x_t \mid x_{t-1})\). Всякий раз, когда данные принимают только дискретные значения (как в языке), наиболее вероятную последовательность слов можно эффективно вычислить с помощью динамического программирования.
9.1.2.2. Порядок декодирования
Возможно, вы задаетесь вопросом, почему мы представили факторизацию последовательности текста \(P(x_1, \ldots, x_T)\) в виде цепочки условных вероятностей, идущей слева направо. Почему бы не использовать направление справа налево или какой-либо другой, кажущийся случайным порядок? В принципе, нет ничего плохого в том, чтобы развернуть \(P(x_1, \ldots, x_T)\) в обратном порядке. Результатом будет корректная факторизация:
Тем не менее, существует множество причин, по которым для задачи языкового моделирования предпочтительнее факторизовать текст в том же направлении, в котором мы его читаем (слева направо для большинства языков, но справа налево для арабского и иврита). Во-первых, это более естественное направление для мышления. Ведь мы все читаем текст каждый день, и этот процесс опирается на нашу способность предвосхищать, какие слова и фразы, скорее всего, появятся дальше. Вспомните, сколько раз вы заканчивали чужие предложения. Таким образом, даже если бы у нас не было других причин отдавать предпочтение такому последовательному декодированию, оно было бы полезно хотя бы потому, что у нас лучше развита интуиция относительно того, что является вероятным при предсказании в таком порядке.
Во-вторых, факторизация в порядке позволяет присваивать вероятности последовательностям произвольной длины с использованием одной и той же языковой модели. Чтобы преобразовать вероятность для шагов \(1\) через \(t\) в вероятность, охватывающую слово \(t+1\), достаточно умножить её на условную вероятность дополнительного токена при условии предыдущих: \(P(x_{t+1}, \ldots, x_1) = P(x_{t}, \ldots, x_1) \cdot P(x_{t+1} \mid x_{t}, \ldots, x_1)\).
В-третьих, у нас есть более мощные предиктивные модели для предсказания соседних слов, чем для слов в произвольных других позициях. Хотя все порядки факторизации корректны, они не обязательно представляют собой задачи предиктивного моделирования одинаковой сложности. Это верно не только для языка, но и для других видов данных, например, когда данные имеют причинно-следственную структуру. Например, мы полагаем, что будущие события не могут влиять на прошлое. Следовательно, если мы изменим \(x_t\), мы сможем повлиять на то, что произойдет для \(x_{t+1}\) в дальнейшем, но не наоборот. То есть, если мы изменим \(x_t\), распределение прошлых событий не изменится. В некоторых контекстах это делает предсказание \(P(x_{t+1} \mid x_t)\) более простым, чем предсказание \(P(x_t \mid x_{t+1})\). Например, в некоторых случаях мы можем найти \(x_{t+1} = f(x_t) + \epsilon\) для некоторого аддитивного шума \(\epsilon\), тогда как обратное утверждение неверно (Hoyer et al., 2009). Это хорошая новость, поскольку обычно нас интересует оценка именно прямого направления. В книге Peters et al. (2017) можно найти больше информации по этой теме. Мы лишь поверхностно касаемся этой темы.
9.1.3. Обучение
Прежде чем сосредоточить внимание на текстовых данных, давайте сначала попробуем это на синтетических данных с непрерывными значениями.
Здесь наши 1000 синтетических примеров будут следовать за
тригонометрической sin функцией, примененной к 0,01 от временного
шага. Чтобы сделать задачу немного более интересной, мы добавим к
каждому примеру аддитивный шум. Из этой последовательности мы извлекаем
обучающие примеры, каждый из которых состоит из признаков и метки.
class Data(d2l.DataModule):
    def __init__(self, batch_size=16, T=1000, num_train=600, tau=4):
        self.save_hyperparameters()
        self.time = torch.arange(1, T + 1, dtype=torch.float32)
        self.x = torch.sin(0.01 * self.time) + torch.randn(T) * 0.2
data = Data()
d2l.plot(data.time, data.x, 'time', 'x', xlim=[1, 1000], figsize=(6, 3))
Для начала мы попробуем модель, которая предполагает, что данные удовлетворяют \(\tau^{\textrm{th}}\)-му условию Маркова, и поэтому предсказывает \(x_t\), используя только предыдущие \(\tau\) наблюдения. Таким образом, для каждого временного шага у нас есть пример с меткой \(y = x_t\) и признаками \(\mathbf{x}_t = [x_{t-\tau}, \ldots, x_{t-1}]\). Внимательный читатель мог заметить, что это дает \(1000-\tau\) примеров, поскольку нам не хватает достаточной истории для \(y_1, \ldots, y_\tau\). Хотя мы могли бы дополнить первые \(\tau\) последовательностей нулями, чтобы сохранить простоту, мы пока опустим их. Получающийся набор данных содержит \(T - \tau\) примеров, где каждый вход модели имеет длину последовательности \(\tau\). Мы создаем итератор данных для первых 600 примеров, охватывающий период синусоидальной функции.
@d2l.add_to_class(Data)
def get_dataloader(self, train):
    features = [self.x[i : self.T-self.tau+i] for i in range(self.tau)]
    self.features = torch.stack(features, 1)
    self.labels = self.x[self.tau:].reshape((-1, 1))
    i = slice(0, self.num_train) if train else slice(self.num_train, None)
    return self.get_tensorloader([self.features, self.labels], train, i)
В этом примере наша модель будет стандартной линейной регрессией.
model = d2l.LinearRegression(lr=0.01)
trainer = d2l.Trainer(max_epochs=5)
trainer.fit(model, data)
9.1.4. Прогнозирование
Чтобы оценить нашу модель, сначала проверим, насколько хорошо она справляется с прогнозированием на один шаг вперёд.
onestep_preds = model(data.features).detach().numpy()
d2l.plot(data.time[data.tau:], [data.labels, onestep_preds], 'time', 'x',
         legend=['labels', '1-step preds'], figsize=(6, 3))
Эти прогнозы выглядят хорошо, даже вблизи конца, на \(t=1000\).
Но что, если мы наблюдали данные последовательности только до шага
времени 604 (n_train + tau) и хотим сделать прогнозы на несколько
шагов вперёд? К сожалению, мы не можем напрямую вычислить одношаговый
прогноз для шага времени 609, поскольку не знаем соответствующие входные
данные, имея информацию только до момента \(x_{604}\). Мы можем
решить эту проблему, подставляя наши предыдущие прогнозы в качестве
входных данных в модель для получения последующих прогнозов, продвигаясь
вперёд шаг за шагом, пока не достигнем нужного шага времени:
Как правило, для наблюдаемой последовательности \(x_1, \ldots, x_t\) её предсказанное значение \(\hat{x}_{t+k}\) на шаге времени \(t+k\) называется прогнозом на \(k\) шагов вперёд. Поскольку мы наблюдали данные вплоть до шага \(x_{604}\), прогноз на \(k\) шагов вперёд равен \(\hat{x}_{604+k}\). Иными словами, для получения многошаговых прогнозов нам придётся постоянно использовать собственные предыдущие предсказания. Давайте посмотрим, насколько хорошо это работает.
multistep_preds = torch.zeros(data.T)
multistep_preds[:] = data.x
for i in range(data.num_train + data.tau, data.T):
    multistep_preds[i] = model(
        multistep_preds[i - data.tau:i].reshape((1, -1)))
multistep_preds = multistep_preds.detach().numpy()
d2l.plot([data.time[data.tau:], data.time[data.num_train+data.tau:]],
         [onestep_preds, multistep_preds[data.num_train+data.tau:]], 'time',
         'x', legend=['1-step preds', 'multistep preds'], figsize=(6, 3))
К сожалению, в данном случае мы терпим полное фиаско. Предсказания быстро стремятся к константе уже через несколько шагов. Почему алгоритм показал столь худшие результаты при прогнозировании на более отдаленные периоды? В конечном счете, это связано с накоплением ошибок. Допустим, после первого шага у нас есть некоторая ошибка \(\epsilon_1 = \bar\epsilon\). Теперь входные данные для второго шага искажены на величину \(\epsilon_1\), следовательно, мы получаем ошибку порядка \(\epsilon_2 = \bar\epsilon + c \epsilon_1\) для некоторой константы \(c\), и так далее. Предсказания могут быстро расходиться с истинными наблюдениями. Возможно, вы уже знакомы с этим распространенным явлением. Например, прогнозы погоды на следующие 24 часа обычно довольно точны, но за их пределами точность быстро снижается. Мы обсудим методы улучшения этого показателя на протяжении всей этой главы и далее.
Давайте рассмотрим подробнее трудности, связанные с прогнозированием на \(k\) шагов вперёд, вычислив прогнозы для всей последовательности в \(k = 1, 4, 16, 64\).
def k_step_pred(k):
    features = []
    for i in range(data.tau):
        features.append(data.x[i : i+data.T-data.tau-k+1])
    # The (i+tau)-th element stores the (i+1)-step-ahead predictions
    for i in range(k):
        preds = model(torch.stack(features[i : i+data.tau], 1))
        features.append(preds.reshape(-1))
    return features[data.tau:]
steps = (1, 4, 16, 64)
preds = k_step_pred(steps[-1])
d2l.plot(data.time[data.tau+steps[-1]-1:],
         [preds[k - 1].detach().numpy() for k in steps], 'time', 'x',
         legend=[f'{k}-step preds' for k in steps], figsize=(6, 3))
Это наглядно демонстрирует, как меняется качество прогноза по мере увеличения горизонта предсказания. Хотя прогнозы на 4 шага вперёд ещё выглядят приёмлемо, прогнозы на более длительные горизонты практически бесполезны.
9.1.5. Резюме
Существует существенная разница в сложности между интерполяцией и экстраполяцией. Следовательно, если у вас есть последовательность, всегда соблюдайте временной порядок данных при обучении, то есть никогда не обучайтесь на будущих данных. Для такого рода данных модели последовательностей требуют специализированных статистических инструментов для оценки. Два популярных варианта — это авторегрессионные модели и авторегрессионные модели со скрытыми переменными. Для каузальных моделей (например, при движении времени вперед) оценка прямого направления, как правило, значительно проще, чем обратного. Для наблюдаемой последовательности до шага времени \(t\) её предсказанный выход на шаге времени \(t+k\) представляет собой прогноз на :math:`k` шагов вперед. Поскольку мы предсказываем дальше во времени, увеличивая \(k\), ошибки накапливаются, и качество прогноза ухудшается, часто значительно.
9.1.6. Упражнения
Улучшите модель в эксперименте этого раздела.
Включать больше, чем последние четыре наблюдения? Сколько на самом деле нужно?
Сколько прошлых наблюдений вам потребовалось бы, если бы не было шума? Подсказка: вы можете записать \(\sin\) и \(\cos\) в виде дифференциального уравнения.
Можно ли учитывать более ранние наблюдения, сохраняя общее количество признаков неизменным? Повысится ли точность? Почему?
Измените архитектуру нейронной сети и оцените её качество. Вы можете обучить новую модель в течение большего числа эпох. Что вы наблюдаете?
Инвестор хочет найти хорошую ценную бумагу для покупки. Он анализирует историческую доходность, чтобы решить, какая из них, скорее всего, покажет хорошие результаты. Что может пойти не так в этой стратегии?
Применима ли причинность также к тексту? И в какой степени?
Приведите пример, когда для описания динамики данных может потребоваться латентная авторегрессионная модель.