
8.1. Глубокие свёрточные нейронные сети (AlexNet)
Хотя свёрточные нейронные сети были хорошо известны в сообществах компьютерного зрения и машинного обучения после появления LeNet (LeCun et al., 1995), они не сразу доминировали в этой области. Несмотря на то что LeNet показывал хорошие результаты на ранних небольших наборах данных, эффективность и возможность обучения свёрточных нейронных сетей на более крупных и реалистичных наборах данных ещё не были доказаны. Более того, в течение большей части периода между началом 1990-х годов и прорывными результатами 2012 года (Krizhevsky et al., 2012) нейронные сети часто уступали другим методам машинного обучения, таким как методы на основе ядра (Schölkopf and Smola, 2002), ансамблевые методы (Freund and Schapire, 1996) и структурированная оценка (Taskar et al., 2004).
Для задач компьютерного зрения это сравнение, возможно, не совсем корректно. Хотя входными данными свёрточных сетей являются необработанные или слегка обработанные (например, центрированные) значения пикселей, специалисты никогда не подавали сырые пиксели в традиционные модели. Вместо этого типичные конвейеры компьютерного зрения включали ручную разработку конвейеров извлечения признаков, таких как SIFT (Lowe, 2004), SURF (Bay et al., 2006) и «мешки визуальных слов» (Sivic and Zisserman, 2003). Признаки не обучались, а конструировались. Большинство достижений было связано с появлением более изощренных идей для извлечения признаков с одной стороны и глубоким пониманием геометрии (Hartley and Zisserman, 2000) с другой. Алгоритм обучения часто рассматривался как второстепенная задача.
Хотя в 1990-х годах уже существовали некоторые ускорители для нейронных сетей, их мощности было недостаточно для создания глубоких многоканальных многослойных свёрточных нейронных сетей с большим количеством параметров. Например, видеокарта NVIDIA GeForce 256, выпущенная в 1999 году, могла выполнять не более 480 миллионов операций с плавающей запятой (сложений и умножений) в секунду (MFLOPS), и при этом для нее не существовало значимых программных фреймворков для задач, выходящих за рамки игр. Современные ускорители способны выполнять более 1000 терафлопс на устройство. Кроме того, наборы данных были относительно небольшими: распознавание рукописного текста на 60 000 низкокачественных изображений размером \(28 \times 28\) пикселей считалось крайне сложной задачей. К этим препятствиям добавлялось отсутствие ключевых приёмов обучения нейронных сетей, таких как эвристики для инициализации параметров (Glorot and Bengio, 2010), эффективные варианты стохастического градиентного спуска (Kingma and Ba, 2014), неограниченные функции активации (Nair and Hinton, 2010) и эффективные методы регуляризации (Srivastava et al., 2014).
Таким образом, вместо обучения сквозных (от пикселей к классификации) систем классические конвейеры выглядели следующим образом:
Получите интересный набор данных. В ранние годы для создания таких наборов данных требовались дорогостоящие датчики. Например, камера Apple QuickTake 100 1994 года имела впечатляющее разрешение всего в 0,3 мегапикселя (VGA), позволяла сохранять до 8 изображений и стоила 1000 долларов.
Предобработка набора данных с использованием специально разработанных признаков, основанных на знаниях оптики, геометрии, других аналитических методов, а иногда и на случайных открытиях везучих аспирантов.
Подаем данные на стандартный набор извлекателей признаков, таких как SIFT (масштабно-инвариантное преобразование признаков) (Lowe, 2004), SURF (ускоренные устойчивые признаки) (Bay et al., 2006) или любую другую из множества ручных конвейеров обработки. OpenCV до сих пор предоставляет извлекатели SIFT!
Полученные представления подаются на вход вашему любимому классификатору, скорее всего, линейной модели или методу, использующему ядро, для обучения классификатора.
Если вы спросите исследователей в области машинного обучения, они ответят, что машинное обучение — это одновременно и важно, и красиво. Элегантные теории доказывали свойства различных классификаторов (Boucheron et al., 2005), а выпуклая оптимизация (Boyd and Vandenberghe, 2004) стала основным средством их получения. Эта область процветала, отличалась строгостью и была исключительно полезной. Однако, если вы поговорите с исследователем в области компьютерного зрения, вы услышите совсем другую историю. По их словам, грязная правда распознавания изображений заключается в том, что прогресс обеспечивали признаки, геометрия (Hartley and Zisserman, 2000, Hartley and Kahl, 2009) и инженерные решения, а не новые алгоритмы обучения. Исследователи в области компьютерного зрения справедливо полагали, что немного больший или более чистый набор данных, а также немного улучшенный конвейер извлечения признаков влияли на итоговую точность гораздо сильнее, чем любой алгоритм обучения.
import torch
from torch import nn
from d2l import torch as d2l
8.1.1. Обучение представлений
Другой взгляд на ситуацию заключается в том, что наиболее важной частью конвейера было представление. И вплоть до 2012 года представление вычислялось преимущественно механически. Фактически, конструирование нового набора функций признаков, улучшение результатов и описание метода занимали центральное место в статьях. SIFT (Lowe, 2004), SURF (Bay et al., 2006), HOG (гистограммы ориентированных градиентов) (Dalal and Triggs, 2005), мешки визуальных слов (Sivic and Zisserman, 2003) и аналогичные извлекатели признаков доминировали в этой области.
Другая группа исследователей, включая Яна Лекюна, Джеффа Хинтона, Юшуа Бенгио, Эндрю Нга, Сунъити Амати и Юргена Шмидхубера, придерживалась иных взглядов. Они полагали, что признаки следует обучать непосредственно. Более того, они считали, что для обеспечения достаточной сложности признаки должны иметь иерархическую структуру, формируемую несколькими совместно обучаемыми слоями, каждый из которых содержит обучаемые параметры. В случае с изображениями нижние слои могут научиться выявлять края, цвета и текстуры, по аналогии с тем, как зрительная система животных обрабатывает входные данные. В частности, автоматический дизайн визуальных признаков, таких как получаемые с помощью разреженного кодирования (Olshausen and Field, 1996), оставался нерешённой задачей до появления современных свёрточных нейронных сетей. Лишь в Dean et al. (2012), Le (2013) идея автоматического извлечения признаков из изображений получила широкое распространение.
Первая современная свёрточная нейронная сеть (Krizhevsky et al., 2012), названная AlexNet в честь одного из её создателей, Алекса Кржижевского, представляет собой значительное эволюционное развитие архитектуры LeNet. Она продемонстрировала отличные результаты в соревновании ImageNet 2012 года.
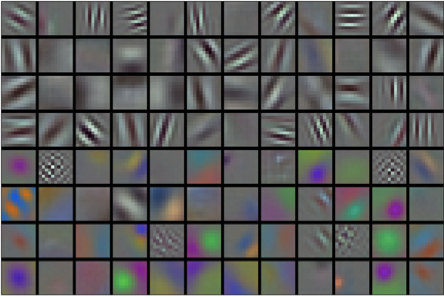
Fig. 8.1.1 Фильтры изображений, изученные первым слоем AlexNet. Воспроизведено с разрешения Krizhevsky et al. (2012).
Интересно, что на самых нижних слоях сети модель выучила извлекатели признаков, напоминающие некоторые традиционные фильтры. Fig. 8.1.1 показывает низкоуровневые признаки изображений. Более высокие слои сети могут использовать эти представления для описания более крупных структур, таких как глаза, носы, травинки и так далее. Ещё более высокие слои могут представлять целые объекты, такие как люди, самолёты, собаки или фрисби. В конечном итоге, финальное скрытое состояние учит компактное представление изображения, которое суммирует его содержимое таким образом, чтобы данные, принадлежащие к разным категориям, можно было легко разделить.
AlexNet (2012) и его предшественник LeNet (1995) имеют много общих архитектурных элементов. Это наводит на вопрос: почему же прошло так много времени? Ключевое отличие заключалось в том, что за предыдущие два десятилетия объём данных и вычислительные мощности значительно возросли. В результате AlexNet был гораздо больше: он обучался на значительно большем объёме данных и на гораздо более быстрых графических процессорах по сравнению с центральными процессорами, доступными в 1995 году.
8.1.1.1. Отсутствующий ингредиент: данные
Глубоким моделям с большим количеством слоёв требуются большие объёмы данных, чтобы перейти в режим, в котором они значительно превосходят традиционные методы, основанные на выпуклой оптимизации (например, линейные и ядерные методы). Однако, учитывая ограниченную ёмкость памяти компьютеров, относительно высокую стоимость (изображающих) сенсоров и более жёсткие исследовательские бюджеты в 1990-х годах, большинство исследований опиралось на крошечные наборы данных. Многие статьи использовали коллекции данных UCI, многие из которых содержали лишь сотни или (несколько тысяч) изображений, снятых в низком разрешении и часто с искусственно чистым фоном.
В 2009 году был выпущен набор данных ImageNet (Deng et al., 2009), который предлагал исследователям обучать модели на 1 млн примеров, по 1000 из 1000 различных категорий объектов. Эти категории базировались на наиболее популярных узлах-существительных в WordNet (Miller, 1995). Команда ImageNet использовала Google Image Search для предварительной фильтрации больших наборов кандидатов для каждой категории и применяла конвейер краудсорсинга Amazon Mechanical Turk для подтверждения того, относится ли каждое изображение к соответствующей категории. Такой масштаб был беспрецедентным, превышая другие на порядок и более (например, в CIFAR-100 содержится 60 000 изображений). Другой особенностью было то, что изображения имели относительно высокое разрешение \(224 \times 224\) пикселей, в отличие от набора данных TinyImages размером 80 млн изображений (Torralba et al., 2008), состоящего из миниатюр размером \(32 \times 32\) пикселей. Это позволило формировать признаки более высокого уровня. Сопутствующее соревнование, получившее название ImageNet Large Scale Visual Recognition Challenge (Russakovsky et al., 2015), продвинуло исследования в области компьютерного зрения и машинного обучения, бросив вызов исследователям определить, какие модели показывают лучшие результаты в более крупном масштабе, чем это ранее рассматривалось в академической среде. Самые крупные наборы данных для задач зрения, такие как LAION-5B (Schuhmann et al., 2022), содержат миллиарды изображений с дополнительными метаданными.
8.1.1.2. Недостающий компонент: аппаратное обеспечение
Модели глубокого обучения являются прожорливыми потребителями вычислительных ресурсов. Обучение может занимать сотни эпох, а каждая итерация требует пропускания данных через множество слоёв вычислительно сложных операций линейной алгебры. Это одна из главных причин, по которой в 1990-х и начале 2000-х годов предпочитались простые алгоритмы, основанные на более эффективно оптимизируемых выпуклых целевых функциях.
Графические процессоры (GPU) стали переломным моментом, сделавшим глубокое обучение возможным. Эти чипы изначально разрабатывались для ускорения обработки графики, что приносило пользу компьютерным играм. В частности, они были оптимизированы для высокопроизводительного вычисления матрично-векторных произведений \(4 \times 4\), необходимых для многих задач компьютерной графики. К счастью, математика здесь поразительно схожа с той, что требуется для вычислений в свёрточных слоях. В то же время компании NVIDIA и ATI начали оптимизировать GPU для общих вычислительных операций (Fernando, 2004), дойдя до того, что стали продвигать их как графические процессоры общего назначения (GPGPU).
Чтобы получить интуитивное понимание, рассмотрим ядра современного микропроцессора (CPU). Каждое из них обладает высокой производительностью благодаря высокой тактовой частоте и большим кэш-памятям (до нескольких мегабайт уровня L3). Каждое ядро хорошо подходит для выполнения широкого спектра инструкций: благодаря предсказателю ветвлений, глубокому конвейеру, специализированным исполнительным устройствам, спекулятивному выполнению и множеству других дополнительных возможностей оно способно запускать самые разнообразные программы со сложным потоком управления. Однако эта кажущаяся мощь является одновременно и ахиллесовой пятой: универсальные ядра очень дороги в производстве. Они превосходно справляются с общим кодом, содержащим множество ветвлений. Для этого требуется значительная площадь кристалла, причём не только для самого арифметико-логического устройства (АЛУ), где происходят вычисления, но и для всех вышеупомянутых дополнительных возможностей, а также для интерфейсов памяти, логики кэширования между ядрами, высокоскоростных шин связи и так далее. По сравнению со специализированным оборудованием, процессоры сравнительно плохо справляются с любой отдельной задачей. В современных ноутбуках обычно установлено 4–8 ядер, а в высокопроизводительных серверах количество ядер на сокет редко превышает 64, просто потому что это экономически нецелесообразно.
Для сравнения, графические процессоры (GPU) могут состоять из тысяч небольших вычислительных элементов (в новейших чипах NVIDIA Ampere до 6912 ядер CUDA), которые часто объединяются в более крупные группы (NVIDIA называет их «войпами» — warps). Детали архитектуры несколько различаются у разных производителей чипов, таких как NVIDIA, AMD, ARM и других. Хотя каждое отдельное ядро относительно слабое и работает на частоте около 1 ГГц, именно общее количество таких ядер делает GPU на порядки быстрее CPU. Например, графический процессор NVIDIA Ampere A100 обеспечивает более 300 терафлопс на чип для специализированных матричных умножений с 16-битной точностью (BFLOAT16) и до 20 терафлопс для более универсальных операций с плавающей запятой (FP32). В то же время производительность операций с плавающей запятой у процессоров редко превышает 1 терафлопс. Например, производительность чипа Amazon Graviton 3 достигает 2 терафлопс для операций с 16-битной точностью, что сопоставимо с производительностью графического процессора в чипе Apple M1.
Существует множество причин, по которым графические процессоры (GPU) значительно превосходят центральные процессоры (CPU) по количеству операций с плавающей запятой в секунду (FLOPs). Во-первых, потребление энергии обычно растет квадратично вместе с тактовой частотой. Следовательно, в рамках бюджета питания одного ядра CPU, работающего в четыре раза быстрее (типичное значение), можно использовать 16 ядер GPU \(\frac{1}{4}\) той же скорости, что обеспечит \(16 \times \frac{1}{4} = 4\) кратный прирост производительности. Во-вторых, ядра GPU значительно проще (на самом деле, долгое время они даже не могли выполнять универсальный код), что делает их более энергоэффективными. Например, (i) они, как правило, не поддерживают спекулятивное выполнение, (ii) обычно невозможно программировать каждый вычислительный элемент индивидуально, и (iii) кэш-память на одно ядро, как правило, значительно меньше. Наконец, многие операции в глубоком обучении требуют высокой пропускной способности памяти. И здесь снова графические процессоры демонстрируют превосходство благодаря шинам памяти, ширина которых как минимум в 10 раз превышает ширину шин многих процессоров.
Вернёмся в 2012 год. Важный прорыв произошел, когда Алекс Крижевский и Илья Сутскевер реализовали глубокую свёрточную нейронную сеть (CNN), способную работать на графических процессорах (GPU). Они поняли, что вычислительные узкие места в CNN, а именно свёртки и умножение матриц, — это операции, которые можно распараллелить на аппаратном уровне. Используя две видеокарты NVIDIA GTX 580 с памятью объёмом 3 ГБ, каждая из которых обеспечивала производительность 1,5 терафлопс (что и спустя десятилетие оставалось сложной задачей для большинства центральных процессоров), они реализовали быстрые свёртки. Код cuda-convnet был настолько хорош, что на протяжении нескольких лет оставался отраслевым стандартом и обеспечивал работу первых лет бума глубокого обучения.
8.1.2. AlexNet
AlexNet, использовавшая 8-слойную свёрточную нейронную сеть, одержала убедительную победу в конкурсе ImageNet Large Scale Visual Recognition Challenge 2012 (Russakovsky et al., 2013). Эта сеть впервые показала, что признаки, полученные в процессе обучения, могут превосходить признаки, разработанные вручную, тем самым нарушив прежнюю парадигму в области компьютерного зрения.
Архитектуры AlexNet и LeNet поразительно похожи, как показано на рисунке Fig. 8.1.2. Обратите внимание, что мы приводим слегка упрощённую версию AlexNet, в которой убраны некоторые особенности дизайна, необходимые в 2012 году для того, чтобы модель помещалась на два небольших GPU.
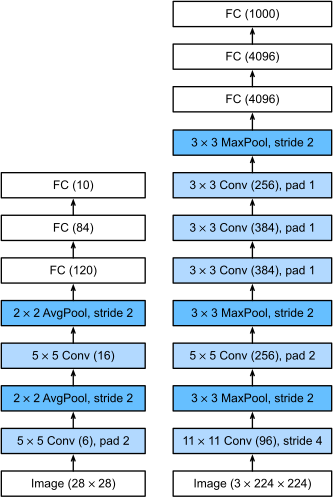
Fig. 8.1.2 От LeNet (слева) к AlexNet (справа).
Между AlexNet и LeNet также есть существенные различия. Во-первых, AlexNet значительно глубже по сравнению с относительно небольшой сетью LeNet-5. AlexNet состоит из восьми слоёв: пяти свёрточных слоёв, двух скрытых полносвязных слоёв и одного полносвязного выходного слоя. Во-вторых, в AlexNet в качестве функции активации используется ReLU вместо сигмоиды. Рассмотрим детали подробнее.
8.1.2.1. Архитектура
В первом слое AlexNet форма окна свёртки составляет \(11\times11\). Поскольку изображения в наборе данных ImageNet в восемь раз выше и шире, чем в MNIST, объекты на данных ImageNet, как правило, занимают больше пикселей и содержат больше визуальных деталей. Следовательно, для захвата объекта требуется окно свёртки большего размера. Форма окна свёртки во втором слое уменьшается до \(5\times5\), а затем до \(3\times3\). Кроме того, после первого, второго и пятого свёрточных слоёв сеть добавляет слои пулинга с формой окна \(3\times3\) и шагом 2. Более того, в AlexNet в десять раз больше каналов свёртки, чем в LeNet.
После последнего свёрточного слоя следуют два больших полносвязных слоя, каждый из которых имеет 4096 выходов. Эти слои требуют почти 1 ГБ параметров модели. Из-за ограниченного объёма памяти в ранних графических процессорах оригинальная архитектура AlexNet использовала двухпоточную обработку данных, благодаря чему каждый из двух графических процессоров отвечал только за хранение и вычисления своей половины модели. К счастью, память графических процессоров сейчас сравнительно велика, поэтому в наши дни нам редко приходится распределять модели между несколькими графическими процессорами (наша версия модели AlexNet в этом аспекте отклоняется от оригинальной статьи).
8.1.2.2. Функции активации
Более того, в AlexNet функцию активации sigmoid заменили на более простую функцию активации ReLU. С одной стороны, вычисление функции активации ReLU проще. Например, в ней отсутствует операция возведения в степень, которая присутствует в функции активации sigmoid. С другой стороны, функция активации ReLU облегчает обучение модели при использовании различных методов инициализации параметров. Это связано с тем, что когда выход функции активации sigmoid очень близок к 0 или 1, градиент в этих областях почти равен 0, из-за чего обратное распространение ошибки не может продолжать обновлять некоторые параметры модели. Напротив, градиент функции активации ReLU в положительном интервале всегда равен 1 (Section 5.1.2). Следовательно, если параметры модели инициализированы неправильно, функция sigmoid может дать градиент, близкий к 0, в положительном интервале, что означает невозможность эффективного обучения модели.
8.1.2.3. Контроль ёмкости и предварительная обработка
AlexNet контролирует сложность модели полносвязного слоя с помощью дропаута (Section 5.6), тогда как LeNet использует только затухание весов. Для дополнительной аугментации данных в цикл обучения AlexNet было добавлено множество методов аугментации изображений, таких как отражение, обрезка и изменение цвета. Это делает модель более устойчивой, а увеличение размера выборки эффективно снижает переобучение. Подробный обзор таких этапов предобработки см. в Buslaev et al. (2020).
class AlexNet(d2l.Classifier):
    def __init__(self, lr=0.1, num_classes=10):
        super().__init__()
        self.save_hyperparameters()
        self.net = nn.Sequential(
            nn.LazyConv2d(96, kernel_size=11, stride=4, padding=1),
            nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2),
            nn.LazyConv2d(256, kernel_size=5, padding=2), nn.ReLU(),
            nn.MaxPool2d(kernel_size=3, stride=2),
            nn.LazyConv2d(384, kernel_size=3, padding=1), nn.ReLU(),
            nn.LazyConv2d(384, kernel_size=3, padding=1), nn.ReLU(),
            nn.LazyConv2d(256, kernel_size=3, padding=1), nn.ReLU(),
            nn.MaxPool2d(kernel_size=3, stride=2), nn.Flatten(),
            nn.LazyLinear(4096), nn.ReLU(), nn.Dropout(p=0.5),
            nn.LazyLinear(4096), nn.ReLU(),nn.Dropout(p=0.5),
            nn.LazyLinear(num_classes))
        self.net.apply(d2l.init_cnn)
Мы создаём пример данных с одним каналом высотой и шириной 224 чтобы наблюдать форму выхода каждого слоя. Он соответствует архитектуре AlexNet из Fig. 8.1.2.
AlexNet().layer_summary((1, 1, 224, 224))
8.1.3. Обучение
Хотя AlexNet обучался на наборе данных ImageNet в
Krizhevsky et al. (2012), здесь мы используем
Fashion-MNIST, поскольку обучение модели ImageNet до сходимости может
занять часы или даже дни даже на современном GPU. Одна из проблем при
прямом применении AlexNet к Fashion-MNIST заключается в том, что его
изображения имеют меньшее разрешение (\(28 \times 28\) пикселей) по
сравнению с изображениями ImageNet. Чтобы это работало, мы увеличиваем
их размер до \(224 \times 224\). В целом это не лучшая практика, так
как она просто увеличивает вычислительную сложность, не добавляя новой
информации. Тем не менее, мы делаем это здесь, чтобы сохранить
архитектуру AlexNet. Это изменение размера выполняется с помощью
аргумента resize в конструкторе d2l.FashionMNIST.
Теперь мы можем начать обучение AlexNet. По сравнению с LeNet в Section 7.6, основное отличие заключается в использовании меньшей скорости обучения и значительно более медленном обучении из-за более глубокой и широкой сети, более высокого разрешения изображений и более затратных операций свёртки.
model = AlexNet(lr=0.01)
data = d2l.FashionMNIST(batch_size=128, resize=(224, 224))
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
trainer.fit(model, data)
8.1.4. Обсуждение
Структура AlexNet во многом напоминает LeNet, но с рядом важных улучшений, как для повышения точности (дропаут), так и для упрощения обучения (ReLU). Не менее примечательным является прогресс, достигнутый в области инструментов для глубокого обучения. То, что в 2012 году требовало нескольких месяцев работы, сегодня можно реализовать в dozen строк кода с использованием любого современного фреймворка.
Рассматривая архитектуру, мы видим, что у AlexNet есть «ахиллесова пята» с точки зрения эффективности: последние два скрытых слоя требуют матриц размером \(6400 \times 4096\) и \(4096 \times 4096\) соответственно. Это соответствует 164 МБ памяти и 81 MFLOPs вычислений, что является значительными затратами, особенно на небольших устройствах, таких как мобильные телефоны. Это одна из причин, по которой AlexNet был превзойден гораздо более эффективными архитектурами, которые мы рассмотрим в следующих разделах. Тем не менее, это важный шаг от неглубоких сетей к глубоким сетям, которые используются в настоящее время. Обратите внимание, что, хотя количество параметров значительно превышает объём обучающих данных в наших экспериментах (последние два слоя имеют более 40 миллионов параметров, обученных на наборе данных из 60 тысяч изображений), практически нет переобучения: потери при обучении и валидации практически идентичны на протяжении всего процесса обучения. Это связано с улучшенной регуляризацией, такой как дропаут, присущей современным архитектурам глубоких сетей.
Хотя в реализации AlexNet всего на несколько строк больше, чем в LeNet, академическому сообществу потребовалось много лет, чтобы принять эту концептуальную новизну и воспользоваться её превосходными экспериментальными результатами. Это также было связано с отсутствием эффективных вычислительных инструментов. В то время ни DistBelief (Dean et al., 2012), ни Caffe (Jia et al., 2014) ещё не существовали, а Theano (Bergstra et al., 2010) не хватало многих важных функций. Ситуация кардинально изменилась с появлением TensorFlow (Abadi et al., 2016).
8.1.5. Упражнения
В продолжение предыдущего обсуждения проанализируйте вычислительные характеристики AlexNet.
Вычислите объём памяти, занимаемый операциями свёртки и полносвязными слоями, соответственно. Какой из них доминирует?
Вычислите вычислительную сложность операций для свёрточных и полносвязных слоёв.
Как память (пропускная способность чтения и записи, задержка, объём) влияет на вычисления? Есть ли различия в её влиянии на обучение и вывод?
Вы — разработчик чипов и должны найти компромисс между вычислительной мощностью и пропускной способностью памяти. Например, более быстрый чип требует больше энергии и, возможно, большей площади. Большая пропускная способность памяти требует большего количества выводов и логики управления, что также увеличивает площадь. Как вы оптимизируете?
Почему инженеры больше не приводят бенчмарки производительности для AlexNet?
Попробуйте увеличить количество эпох при обучении AlexNet. Как результаты отличаются от LeNet? Почему?
AlexNet может быть слишком сложной моделью для набора данных Fashion-MNIST, особенно из-за низкого разрешения исходных изображений.
Попробуйте упростить модель, чтобы ускорить обучение, при этом убедившись, что точность не упадёт значительно.
Разработайте более совершенную модель, которая работает непосредственно с изображениями \(28 \times 28\).
Измените размер батча и наблюдайте за изменениями пропускной способности (изображений/с), точности и объёма памяти GPU.
Примените дропаут и ReLU к LeNet-5. Приводит ли это к улучшению? Можно ли добиться дальнейшего улучшения, выполнив предварительную обработку, чтобы использовать инвариантности, присущие изображениям?
Можно ли заставить AlexNet переобучиться? Какой признак нужно удалить или изменить, чтобы нарушить обучение?