
11.4. Механизм внимания Бадау
Когда мы рассматривали машинный перевод в Section 10.7, мы разработали архитектуру кодировщик–декодировщик для обучения последовательность–в–последовательность на основе двух рекуррентных нейронных сетей (Sutskever et al., 2014). В частности, кодировщик RNN преобразует последовательность переменной длины в контекстную переменную фиксированной формы. Затем декодировщик RNN генерирует выходную последовательность (целевую) токен за токеном на основе уже сгенерированных токенов и контекстной переменной.
Вспомним Fig. 10.7.2, что мы повторим (Fig. 11.4.1) с некоторыми дополнительными подробностями. Согласно общепринятой практике, в RNN весь релевантный исходной последовательности кодировщик преобразует в некоторое внутреннее представление состояния фиксированной размерности. Именно это состояние декодировщик использует в качестве полного и единственного источника информации для генерации переведенной последовательности. Другими словами, механизм последовательность-в-последовательность рассматривает промежуточное состояние как достаточную статистику любой строки, которая могла служить входными данными.
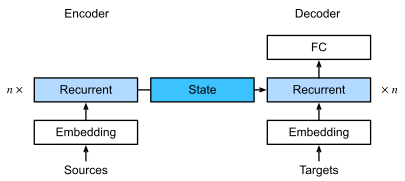
Fig. 11.4.1 Модель «последовательность-в-последовательность». Состояние, генерируемое кодировщиком, является единственным фрагментом информации, передаваемым от кодировщика к декодировщику.
Хотя такой подход вполне приёмлем для коротких последовательностей, становится очевидно, что он неприменим для длинных, таких как глава книги или даже просто очень длинное предложение. В конце концов, со временем в промежуточном представлении просто не хватит «места», чтобы сохранить всю важную информацию исходной последовательности. В результате декодировщик не сможет правильно перевести длинные и сложные предложения. Одними из первых с этой проблемой столкнулись авторы работы Graves (2013), которые пытались разработать рекуррентную нейронную сеть для генерации рукописного текста. Поскольку исходный текст мог иметь произвольную длину, они предложили дифференцируемую модель внимания для выравнивания символов текста с гораздо более длинной траекторией движения пера, при этом выравнивание происходило только в одном направлении. Эта идея, в свою очередь, опирается на алгоритмы декодирования, используемые в распознавании речи, например, на скрытые марковские модели (Rabiner and Juang, 1993).
Вдохновленные идеей обучения выравниванию, Bahdanau et al. (2014) предложили дифференцируемую модель внимания без ограничения одностороннего выравнивания. При предсказании токена, если не все входные токены релевантны, модель выравнивается (или обращает внимание) только на те части входной последовательности, которые считаются релевантными для текущего предсказания. Это используется для обновления текущего состояния перед генерацией следующего токена. Хотя в описании это выглядит вполне невинно, механизм внимания Бадау стал, пожалуй, одной из самых влиятельных идей в глубоком обучении за последнее десятилетие, породив Transformers (Vaswani et al., 2017) и множество связанных с ними новых архитектур.
import torch
from torch import nn
from d2l import torch as d2l
11.4.1. Модель
Мы используем обозначения, введённые в архитектуре «последовательность-в-последовательность» Section 10.7, в частности (10.7.3). Основная идея заключается в том, что вместо фиксации состояния, то есть переменной контекста \(\mathbf{c}\), суммирующей исходное предложение, мы динамически обновляем её как функцию как исходного текста (скрытых состояний кодировщика \(\mathbf{h}_{t}\)), так и уже сгенерированного текста (скрытых состояний декодировщика \(\mathbf{s}_{t'-1}\)). В результате получаем \(\mathbf{c}_{t'}\), которое обновляется после любого шага декодирования \(t'\). Предположим, что длина входной последовательности равна \(T\). В этом случае переменная контекста является результатом агрегирования по вниманию:
В качестве запроса мы использовали \(\mathbf{s}_{t' - 1}\), а в качестве ключа и значения — \(\mathbf{h}_{t}\). Обратите внимание, что \(\mathbf{c}_{t'}\) затем используется для формирования состояния \(\mathbf{s}_{t'}\) и генерации нового токена: см. (10.7.3). В частности, вес внимания \(\alpha\) вычисляется так же, как в (11.3.3), с использованием аддитивной функции оценки, определённой в (11.3.7). Эта архитектура кодировщика–декодировщика на основе рекуррентных нейронных сетей с механизмом внимания изображена на рисунке Fig. 11.4.2. Обратите внимание, что впоследствии эта модель была модифицирована таким образом, чтобы уже сгенерированные токены учитывались в декодировщике как дополнительный контекст (то есть сумма внимания не ограничивается \(T\), а продолжается до \(t'-1\)). Например, описание этой стратегии, примененной к распознаванию речи, можно найти в Chan et al. (2015).
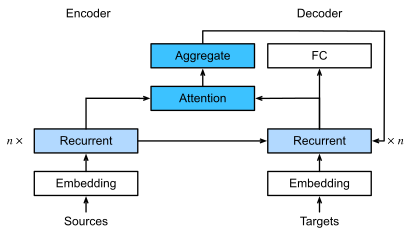
Fig. 11.4.2 Слои в модели кодировщик–декодировщик RNN с механизмом внимания Бадаоу.
11.4.2. Определение декодировщика с вниманием
Чтобы реализовать RNN-кодировщик-декодировщик с вниманием, нам
достаточно переопределить только декодировщик (исключение генерируемых
символов из функции внимания упрощает конструкцию). Начнём с базового
интерфейса для декодировщиков с вниманием, определив класс
AttentionDecoder, название которого вполне ожидаемо.
class AttentionDecoder(d2l.Decoder):  #@save
    """The base attention-based decoder interface."""
    def __init__(self):
        super().__init__()

    @property
    def attention_weights(self):
        raise NotImplementedError
Нам нужно реализовать RNN-декодировщик в классе
Seq2SeqAttentionDecoder. Состояние декодировщика инициализируется с
помощью (i) скрытых состояний последнего слоя кодировщика на всех
временных шагах, которые используются в качестве ключей и значений для
механизма внимания; (ii) скрытого состояния кодировщика на всех слоях в
последний момент времени, которое служит для инициализации скрытого
состояния декодировщика; и (iii) допустимой длины кодировщика, чтобы
исключить токены дополнения при агрегировании по вниманию. На каждом
шаге декодирования скрытое состояние последнего слоя декодировщика,
полученное на предыдущем шаге, используется в качестве запроса механизма
внимания. Выход механизма внимания и входной эмбеддинг объединяются,
чтобы служить входом для RNN-декодировщика.
class Seq2SeqAttentionDecoder(AttentionDecoder):
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0):
        super().__init__()
        self.attention = d2l.AdditiveAttention(num_hiddens, dropout)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        self.rnn = nn.GRU(
            embed_size + num_hiddens, num_hiddens, num_layers,
            dropout=dropout)
        self.dense = nn.LazyLinear(vocab_size)
        self.apply(d2l.init_seq2seq)

    def init_state(self, enc_outputs, enc_valid_lens):
        # Shape of outputs: (num_steps, batch_size, num_hiddens).
        # Shape of hidden_state: (num_layers, batch_size, num_hiddens)
        outputs, hidden_state = enc_outputs
        return (outputs.permute(1, 0, 2), hidden_state, enc_valid_lens)

    def forward(self, X, state):
        # Shape of enc_outputs: (batch_size, num_steps, num_hiddens).
        # Shape of hidden_state: (num_layers, batch_size, num_hiddens)
        enc_outputs, hidden_state, enc_valid_lens = state
        # Shape of the output X: (num_steps, batch_size, embed_size)
        X = self.embedding(X).permute(1, 0, 2)
        outputs, self._attention_weights = [], []
        for x in X:
            # Shape of query: (batch_size, 1, num_hiddens)
            query = torch.unsqueeze(hidden_state[-1], dim=1)
            # Shape of context: (batch_size, 1, num_hiddens)
            context = self.attention(
                query, enc_outputs, enc_outputs, enc_valid_lens)
            # Concatenate on the feature dimension
            x = torch.cat((context, torch.unsqueeze(x, dim=1)), dim=-1)
            # Reshape x as (1, batch_size, embed_size + num_hiddens)
            out, hidden_state = self.rnn(x.permute(1, 0, 2), hidden_state)
            outputs.append(out)
            self._attention_weights.append(self.attention.attention_weights)
        # After fully connected layer transformation, shape of outputs:
        # (num_steps, batch_size, vocab_size)
        outputs = self.dense(torch.cat(outputs, dim=0))
        return outputs.permute(1, 0, 2), [enc_outputs, hidden_state,
                                          enc_valid_lens]

    @property
    def attention_weights(self):
        return self._attention_weights
В дальнейшем мы проверим реализованный декодировщик с вниманием на мини-батче из четырёх последовательностей, каждая из которых состоит из семи временных шагов.
vocab_size, embed_size, num_hiddens, num_layers = 10, 8, 16, 2
batch_size, num_steps = 4, 7
encoder = d2l.Seq2SeqEncoder(vocab_size, embed_size, num_hiddens, num_layers)
decoder = Seq2SeqAttentionDecoder(vocab_size, embed_size, num_hiddens,
                                  num_layers)
X = torch.zeros((batch_size, num_steps), dtype=torch.long)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
d2l.check_shape(output, (batch_size, num_steps, vocab_size))
d2l.check_shape(state[0], (batch_size, num_steps, num_hiddens))
d2l.check_shape(state[1][0], (batch_size, num_hiddens))
11.4.3. Обучение
Теперь, когда мы определили новый декодировщик, мы можем поступить аналогично Section 10.7.6: задать гиперпараметры, создать обычный кодировщик и декодировщик с механизмом внимания, а затем обучить эту модель для машинного перевода.
data = d2l.MTFraEng(batch_size=128)
embed_size, num_hiddens, num_layers, dropout = 256, 256, 2, 0.2
encoder = d2l.Seq2SeqEncoder(
    len(data.src_vocab), embed_size, num_hiddens, num_layers, dropout)
decoder = Seq2SeqAttentionDecoder(
    len(data.tgt_vocab), embed_size, num_hiddens, num_layers, dropout)
model = d2l.Seq2Seq(encoder, decoder, tgt_pad=data.tgt_vocab['<pad>'],
                    lr=0.005)
trainer = d2l.Trainer(max_epochs=30, gradient_clip_val=1, num_gpus=1)
trainer.fit(model, data)
После обучения модели мы используем её для перевода нескольких английских предложений на французский язык и вычисления их оценок BLEU.
engs = ['go .', 'i lost .', 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
preds, _ = model.predict_step(
    data.build(engs, fras), d2l.try_gpu(), data.num_steps)
for en, fr, p in zip(engs, fras, preds):
    translation = []
    for token in data.tgt_vocab.to_tokens(p):
        if token == '<eos>':
            break
        translation.append(token)
    print(f'{en} => {translation}, bleu,'
          f'{d2l.bleu(" ".join(translation), fr, k=2):.3f}')
Давайте визуализируем веса внимания при переводе последнего английского предложения. Мы видим, что каждый запрос присваивает неравномерные веса парам ключ–значение. Это демонстрирует, что на каждом шаге декодирования различные части входных последовательностей выборочно агрегируются с помощью агрегирования по вниманию.
_, dec_attention_weights = model.predict_step(
    data.build([engs[-1]], [fras[-1]]), d2l.try_gpu(), data.num_steps, True)
attention_weights = torch.cat(
    [step[0][0][0] for step in dec_attention_weights], 0)
attention_weights = attention_weights.reshape((1, 1, -1, data.num_steps))
# Plus one to include the end-of-sequence token
d2l.show_heatmaps(
    attention_weights[:, :, :, :len(engs[-1].split()) + 1].cpu(),
    xlabel='Key positions', ylabel='Query positions')
11.4.4. Резюме
При предсказании токена, если не все входные токены релевантны, кодировщик и декодировщик на основе рекуррентной нейронной сети с механизмом внимания Баданау выборочно агрегируют различные части входной последовательности. Это достигается за счёт того, что состояние (переменная контекста) рассматривается как результат агрегирования по вниманию с аддитивным механизмом. В кодировщике и декодировщике на основе рекуррентной нейронной сети механизм внимания Баданау использует скрытое состояние декодировщика на предыдущем временном шаге в качестве запроса, а скрытые состояния кодировщика на всех временных шагах — в качестве ключей и значений.
11.4.5. Упражнения
Замените GRU на LSTM в эксперименте.
Модифицируйте эксперимент, заменив функцию оценки аддитивного внимания на масштабированное скалярное произведение. Как это влияет на эффективность обучения?