
7.4. Несколько входных и выходных каналов
Хотя в Section 7.1.4 мы описали многоканальные изображения (например, стандартные каналы RGB в цветных изображениях, указывающие интенсивность красного, зеленого и синего цветов) и свёрточные слои для нескольких каналов, до сих пор мы упрощали все численные примеры, используя только один входной и один выходной канал. Это позволяло рассматривать входные данные, свёрточные ядра и выходные данные как двумерные тензоры.
Когда мы добавляем каналы, наши входные данные и скрытые представления становятся трёхмерными тензорами. Например, каждое входное RGB-изображение имеет форму \(3\times h\times w\). Эту ось размером 3 мы называем размерностью канала. Понятие каналов существует с тех пор, как появились свёрточные нейронные сети: например, LeNet-5 (LeCun et al., 1995) использует их. В этом разделе мы подробнее рассмотрим свёрточные ядра с несколькими входными и несколькими выходными каналами.
import torch
from d2l import torch as d2l
7.4.1. Несколько входных каналов
Когда входные данные содержат несколько каналов, необходимо создать свёрточное ядро с тем же числом входных каналов, что и у входных данных, чтобы оно могло выполнять перекрёстную корреляцию с входными данными. Если число каналов входных данных равно \(c_\textrm{i}\), то и число входных каналов свёрточного ядра должно быть равно \(c_\textrm{i}\). Если форма окна нашего свёрточного ядра равна \(k_\textrm{h}\times k_\textrm{w}\), то при \(c_\textrm{i}=1\) мы можем рассматривать наше свёрточное ядро как двумерный тензор формы \(k_\textrm{h}\times k_\textrm{w}\).
Однако, когда \(c_\textrm{i}>1\), нам требуется ядро, содержащее тензор формы \(k_\textrm{h}\times k_\textrm{w}\) для каждого входного канала. Объединение этих \(c_\textrm{i}\) тензоров даёт свёрточное ядро формы \(c_\textrm{i}\times k_\textrm{h}\times k_\textrm{w}\). Поскольку входной тензор и свёрточное ядро имеют по \(c_\textrm{i}\) каналов, мы можем выполнить операцию перекрёстной корреляции между двумерным тензором входных данных и двумерным тензором свёрточного ядра для каждого канала, сложив \(c_\textrm{i}\) полученных результата (суммирование по каналам), чтобы получить двумерный тензор. Это и есть результат двумерной перекрёстной корреляции между многоканальным входом и многоканальным свёрточным ядром.
Fig. 7.4.1 приводит пример двумерной кросс-корреляции с двумя входными каналами. Заштрихованные области обозначают первый элемент выходного тензора, а также элементы входного тензора и ядра, использованные для его вычисления: \((1\times1+2\times2+4\times3+5\times4)+(0\times0+1\times1+3\times2+4\times3)=56\).
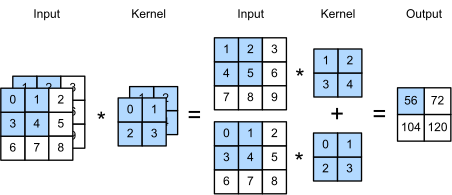
Fig. 7.4.1 Вычисление кросс-корреляции с двумя входными каналами.
Чтобы убедиться, что мы действительно понимаем, что здесь происходит, мы можем самостоятельно реализовать операции кросс-корреляции с несколькими входными каналами. Обратите внимание, что всё, что мы делаем, — это выполняем операцию кросс-корреляции для каждого канала, а затем суммируем результаты.
def corr2d_multi_in(X, K):
    # Iterate through the 0th dimension (channel) of K first, then add them up
    return sum(d2l.corr2d(x, k) for x, k in zip(X, K))
Мы можем создать входной тензор X и тензор ядра K,
соответствующие значениям в Fig. 7.4.1, чтобы
проверить вывод операции кросс-корреляции.
X = torch.tensor([[[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]],
               [[1.0, 2.0, 3.0], [4.0, 5.0, 6.0], [7.0, 8.0, 9.0]]])
K = torch.tensor([[[0.0, 1.0], [2.0, 3.0]], [[1.0, 2.0], [3.0, 4.0]]])

corr2d_multi_in(X, K)
7.4.2. Несколько выходных каналов
Независимо от количества входных каналов, до сих пор мы всегда получали один выходной канал. Однако, как мы обсуждали в Section 7.1.4, оказывается, что наличие нескольких каналов на каждом слое является существенным. В самых популярных архитектурах нейронных сетей мы фактически увеличиваем размерность канала по мере углубления в нейронную сеть, обычно уменьшая пространственное разрешение в обмен на большую глубину каналов. Интуитивно можно представить, что каждый канал реагирует на свой набор признаков. Однако реальность немного сложнее. Наивная интерпретация могла бы предположить, что представления обучаются независимо для каждого пикселя или канала. Вместо этого каналы оптимизируются так, чтобы быть совместно полезными. Это означает, что вместо того чтобы отображать один канал на детектор краёв, может оказаться, что просто какое-то направление в пространстве каналов соответствует обнаружению краёв.
Обозначим через \(c_\textrm{i}\) и \(c_\textrm{o}\) количество входных и выходных каналов соответственно, а через \(k_\textrm{h}\) и \(k_\textrm{w}\) — высоту и ширину ядра. Чтобы получить выходной тензор с несколькими каналами, мы создаём тензор ядра формы \(c_\textrm{i}\times k_\textrm{h}\times k_\textrm{w}\) для каждого выходного канала. Мы объединяем их по размерности выходных каналов, так что форма свёрточного ядра становится \(c_\textrm{o}\times c_\textrm{i}\times k_\textrm{h}\times k_\textrm{w}\). В операциях кросс-корреляции результат на каждом выходном канале вычисляется с использованием ядра, соответствующего этому выходному каналу, и принимает на вход все каналы входного тензора.
Мы реализуем функцию кросс-корреляции для вычисления отклика нескольких каналов, как показано ниже.
def corr2d_multi_in_out(X, K):
    # Iterate through the 0th dimension of K, and each time, perform
    # cross-correlation operations with input X. All of the results are
    # stacked together
    return torch.stack([corr2d_multi_in(X, k) for k in K], 0)
Мы создадим тривиальное свёрточное ядро с тремя выходными каналами,
объединив тензор ядра для K с K+1 и K+2.
K = torch.stack((K, K + 1, K + 2), 0)
K.shape
Ниже мы выполняем операции поперечной корреляции на входном тензоре
X с использованием тензора ядра K. Теперь выход содержит три
канала. Результат первого канала совпадает с результатом предыдущего
входного тензора X и ядра с несколькими входными каналами и одним
выходным каналом.
corr2d_multi_in_out(X, K)
7.4.3. \(1\times 1\) Свёрточный слой
На первый взгляд, :math:`1 times 1` свёртка, т. е. \(k_\textrm{h} = k_\textrm{w} = 1\), не кажется особенно осмысленной. Ведь свёртка учитывает соседние пиксели. Очевидно, что \(1 \times 1\) свёртка этого не делает. Тем не менее, это распространённые операции, которые иногда включают в архитектуру сложных глубоких сетей (Lin et al., 2013, Szegedy et al., 2017). Давайте подробнее разберёмся, что же они на самом деле делают.
Поскольку используется минимальное окно, свёртка \(1\times 1\) теряет способность, присущую свёрточным слоям с большими окнами, распознавать паттерны, состоящие из взаимодействий между соседними элементами по размерностям высоты и ширины. Единственные вычисления в свёртке \(1\times 1\) производятся по размерности каналов.
Fig. 7.4.2 демонстрирует вычисление кросс-корреляции с использованием ядра \(1\times 1\) свёртки, имеющего 3 входных канала и 2 выходных канала. Обратите внимание, что высота и ширина входных и выходных данных совпадают. Каждый элемент выхода получается в результате линейной комбинации элементов в той же позиции входного изображения. Слой \(1\times 1\) свёртки можно рассматривать как полносвязный слой, применяемый к каждому отдельному пикселю для преобразования \(c_\textrm{i}\) соответствующих входных значений в \(c_\textrm{o}\) выходные значения. Поскольку это всё ещё свёрточный слой, веса связаны между собой для всех позиций пикселей. Таким образом, слой \(1\times 1\) свёртки требует \(c_\textrm{o}\times c_\textrm{i}\) весов (плюс смещение). Также обратите внимание, что за свёрточными слоями обычно следуют нелинейные функции. Это гарантирует, что свёртки \(1 \times 1\) не могут быть просто сведены к другим свёрткам.
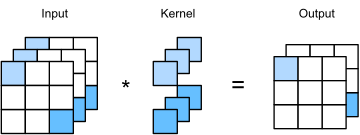
Fig. 7.4.2 Вычисление кросс-корреляции использует \(1\times 1\) ядро свёртки с тремя входными каналами и двумя выходными каналами. Входные и выходные данные имеют одинаковую высоту и ширину.
Давайте проверим, работает ли это на практике: мы реализуем \(1 \times 1\) свёртку с помощью полносвязного слоя. Единственное, что нужно сделать, — это внести некоторые изменения в форму данных перед и после матричного умножения.
def corr2d_multi_in_out_1x1(X, K):
    c_i, h, w = X.shape
    c_o = K.shape[0]
    X = X.reshape((c_i, h * w))
    K = K.reshape((c_o, c_i))
    # Matrix multiplication in the fully connected layer
    Y = torch.matmul(K, X)
    return Y.reshape((c_o, h, w))
При выполнении свёрток \(1\times 1\) описанная выше функция
эквивалентна ранее реализованной функции перекрёстной корреляции
corr2d_multi_in_out. Проверим это на некоторых примерах данных.
X = torch.normal(0, 1, (3, 3, 3))
K = torch.normal(0, 1, (2, 3, 1, 1))
Y1 = corr2d_multi_in_out_1x1(X, K)
Y2 = corr2d_multi_in_out(X, K)
assert float(torch.abs(Y1 - Y2).sum()) < 1e-6
7.4.4. Обсуждение
Каналы позволяют объединить лучшие стороны обоих подходов: многослойных персептронов, обеспечивающих значительные нелинейности, и свёрток, позволяющих проводить локальный анализ признаков. В частности, каналы позволяют свёрточной нейронной сети одновременно учитывать несколько признаков, таких как детекторы краев и форм. Они также обеспечивают практический компромисс между радикальным сокращением числа параметров, обусловленным инвариантностью к сдвигу и локальностью, и необходимостью использования выразительных и разнообразных моделей в компьютерном зрении.
Обратите внимание, однако, что эта гибкость достигается ценой. Для изображения размера \((h \times w)\) стоимость вычисления свёртки с ядром размера \(k \times k\) составляет \(\mathcal{O}(h \cdot w \cdot k^2)\). При наличии \(c_\textrm{i}\) входных и \(c_\textrm{o}\) выходных каналов эта стоимость возрастает до \(\mathcal{O}(h \cdot w \cdot k^2 \cdot c_\textrm{i} \cdot c_\textrm{o})\). Для изображения размером \(256 \times 256\) пикселей с ядром размера \(5 \times 5\) и \(128\) входными и выходными каналами соответственно это составляет более 53 миллиардов операций (мы считаем умножения и сложения отдельно). Далее мы рассмотрим эффективные стратегии снижения вычислительных затрат, например, за счёт требования блочно-диагональной структуры операций по каналам, что приводит к таким архитектурам, как ResNeXt (Xie et al., 2017).
7.4.5. Упражнения
Предположим, что у нас есть два свёрточных ядра размером \(k_1\) и \(k_2\) соответственно (без нелинейности между ними).
Докажите, что результат операции можно выразить одной свёрткой.
Какова размерность эквивалентной свёртки, выполняемой одним слоем?
Верно ли обратное, то есть можно ли всегда разложить свёртку на две более мелкие?
Предположим, что входные данные имеют форму \(c_\textrm{i}\times h\times w\), а ядро свёртки — форму \(c_\textrm{o}\times c_\textrm{i}\times k_\textrm{h}\times k_\textrm{w}\), дополнение равно \((p_\textrm{h}, p_\textrm{w})\), а шаг — \((s_\textrm{h}, s_\textrm{w})\).
Какова вычислительная стоимость (умножений и сложений) для прямого распространения?
Каков объём потребляемой памяти?
Каков объём памяти, занимаемый обратным вычислением?
Какова вычислительная сложность обратного распространения ошибки?
Во сколько раз увеличится количество вычислений, если удвоить число входных каналов \(c_\textrm{i}\) и число выходных каналов \(c_\textrm{o}\)? Что произойдет, если удвоить дополнение?
Являются ли переменные
Y1иY2в последнем примере этого раздела абсолютно одинаковыми? Почему?Выразите свёртки через матричное умножение, даже когда окно свёртки не равно \(1 \times 1\).
Ваша задача — реализовать быстрые свёртки с ядром размера \(k \times k\). Один из вариантов алгоритма — сканировать входные данные по горизонтали, считывая полосу шириной \(k\) и вычисляя выходную полосу ширины \(1\) по одному значению за раз. Альтернативный подход заключается в считывании полосы шириной \(k + \Delta\) и вычислении выходной полосы ширины \(\Delta\). Почему второй вариант предпочтительнее? Существует ли предел того, насколько большим можно выбрать \(\Delta\)?
Предположим, что у нас есть матрица размера \(c \times c\).
Во сколько раз быстрее выполняется умножение с блочно-диагональной матрицей, если она разбита на \(b\) блоков?
Каков недостаток наличия блоков \(b\)? Как можно частично это исправить?