
16.7. Вывод на естественном языке: дообучение BERT
В предыдущих разделах этой главы мы разработали архитектуру на основе механизма внимания (в Section 16.5) для задачи естественного языкового вывода на наборе данных SNLI (как описано в Section 16.4). Теперь мы рассмотрим эту задачу с помощью дообучения BERT. Как обсуждалось в Section 16.6, естественный языковой вывод представляет собой задачу классификации пар текстов на уровне последовательности, и для дообучения BERT требуется лишь дополнительная архитектура на основе многослойного перцептрона, как показано на рисунке Fig. 16.7.1.
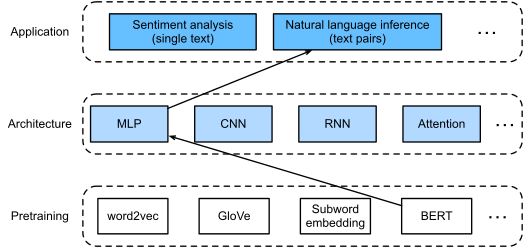
Fig. 16.7.1 В этом разделе предобученная модель BERT используется в архитектуре на основе многослойного перцептрона для решения задачи естественного языкового вывода.
В этом разделе мы загрузим предварительно обученную компактную версию BERT, а затем выполним тонкую настройку для задачи естественного языкового вывода на наборе данных SNLI.
import json
import multiprocessing
import os
import torch
from torch import nn
from d2l import torch as d2l
16.7.1. Загрузка предварительно обученной модели BERT
В разделах Section 15.9 и Section 15.10 мы объяснили, как предобучить BERT на наборе данных WikiText-2 (обратите внимание, что оригинальная модель BERT предобучалась на гораздо более крупных корпусах). Как обсуждалось в Section 15.10, оригинальная модель BERT содержит сотни миллионов параметров. Далее мы представим две версии предобученного BERT: «bert.base» сопоставима по размеру с оригинальной базовой моделью BERT, для тонкой настройки которой требуется значительный объём вычислительных ресурсов, тогда как «bert.small» — это уменьшенная версия, предназначенная для упрощения демонстрации.
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.torch.zip',
                             '225d66f04cae318b841a13d32af3acc165f253ac')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.torch.zip',
                              'c72329e68a732bef0452e4b96a1c341c8910f81f')
Каждая из предобученных моделей BERT содержит файл vocab.json,
определяющий набор словаря, и файл pretrained.params с
предобученными параметрами. Мы реализуем следующую
load_pretrained_model функцию для загрузки предобученных параметров
BERT.
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
                          num_heads, num_blks, dropout, max_len, devices):
    data_dir = d2l.download_extract(pretrained_model)
    # Define an empty vocabulary to load the predefined vocabulary
    vocab = d2l.Vocab()
    vocab.idx_to_token = json.load(open(os.path.join(data_dir, 'vocab.json')))
    vocab.token_to_idx = {token: idx for idx, token in enumerate(
        vocab.idx_to_token)}
    bert = d2l.BERTModel(
        len(vocab), num_hiddens, ffn_num_hiddens=ffn_num_hiddens, num_heads=4,
        num_blks=2, dropout=0.2, max_len=max_len)
    # Load pretrained BERT parameters
    bert.load_state_dict(torch.load(os.path.join(data_dir,
                                                 'pretrained.params')))
    return bert, vocab
Чтобы продемонстрировать работу на большинстве машин, в этом разделе мы загрузим и дообучим небольшую версию предобученной модели BERT («bert.small»). В упражнении мы покажем, как дообучить значительно более крупную модель «bert.base», что позволит существенно повысить точность на тестовой выборке.
devices = d2l.try_all_gpus()
bert, vocab = load_pretrained_model(
    'bert.small', num_hiddens=256, ffn_num_hiddens=512, num_heads=4,
    num_blks=2, dropout=0.1, max_len=512, devices=devices)
16.7.2. Набор данных для дообучения BERT
Для задачи естественного языкового вывода на наборе данных SNLI мы
определяем пользовательский класс набора данных SNLIBERTDataset. В
каждом примере посылка и гипотеза образуют пару текстовых
последовательностей, которые объединяются в одну входную
последовательность BERT, как показано на рисунке
Fig. 16.6.2. Напоминание
Section 15.8.4: идентификаторы сегментов используются
для различения посылки и гипотезы во входной последовательности BERT.
При заданной максимальной длине входной последовательности BERT
(max_len) последний токен более длинной из пары входных текстов
постоянно удаляется до тех пор, пока не будет выполнено условие
max_len. Для ускорения создания набора данных SNLI для дообучения
BERT мы используем 4 рабочих процесса для параллельной генерации
обучающих или тестовых примеров.
class SNLIBERTDataset(torch.utils.data.Dataset):
    def __init__(self, dataset, max_len, vocab=None):
        all_premise_hypothesis_tokens = [[
            p_tokens, h_tokens] for p_tokens, h_tokens in zip(
            *[d2l.tokenize([s.lower() for s in sentences])
              for sentences in dataset[:2]])]

        self.labels = torch.tensor(dataset[2])
        self.vocab = vocab
        self.max_len = max_len
        (self.all_token_ids, self.all_segments,
         self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
        print('read ' + str(len(self.all_token_ids)) + ' examples')

    def _preprocess(self, all_premise_hypothesis_tokens):
        pool = multiprocessing.Pool(4)  # Use 4 worker processes
        out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
        all_token_ids = [
            token_ids for token_ids, segments, valid_len in out]
        all_segments = [segments for token_ids, segments, valid_len in out]
        valid_lens = [valid_len for token_ids, segments, valid_len in out]
        return (torch.tensor(all_token_ids, dtype=torch.long),
                torch.tensor(all_segments, dtype=torch.long),
                torch.tensor(valid_lens))

    def _mp_worker(self, premise_hypothesis_tokens):
        p_tokens, h_tokens = premise_hypothesis_tokens
        self._truncate_pair_of_tokens(p_tokens, h_tokens)
        tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
        token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
                             * (self.max_len - len(tokens))
        segments = segments + [0] * (self.max_len - len(segments))
        valid_len = len(tokens)
        return token_ids, segments, valid_len

    def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
        # Reserve slots for '<CLS>', '<SEP>', and '<SEP>' tokens for the BERT
        # input
        while len(p_tokens) + len(h_tokens) > self.max_len - 3:
            if len(p_tokens) > len(h_tokens):
                p_tokens.pop()
            else:
                h_tokens.pop()

    def __getitem__(self, idx):
        return (self.all_token_ids[idx], self.all_segments[idx],
                self.valid_lens[idx]), self.labels[idx]

    def __len__(self):
        return len(self.all_token_ids)
После загрузки набора данных SNLI мы создаем примеры для обучения и
проверки, инициализируя класс SNLIBERTDataset. Эти примеры будут
считываться мини-пакетами в процессе обучения и проверки задачи вывода в
естественном языке.
# Reduce `batch_size` if there is an out of memory error. In the original BERT
# model, `max_len` = 512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = torch.utils.data.DataLoader(train_set, batch_size, shuffle=True,
                                   num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(test_set, batch_size,
                                  num_workers=num_workers)
16.7.3. Дообучение BERT
Как показано в Fig. 16.6.2, дообучение BERT для задачи
естественного языкового вывода требует лишь добавления многослойного
перцептрона (MLP), состоящего из двух полносвязных слоёв (см.
self.hidden и self.output в следующем классе
BERTClassifier). Этот MLP преобразует представление BERT
специального токена «<cls>», которое кодирует информацию как из
посылки, так и из гипотезы, в три выхода для естественного языкового
вывода: утверждение, противоречие и нейтральность.
class BERTClassifier(nn.Module):
    def __init__(self, bert):
        super(BERTClassifier, self).__init__()
        self.encoder = bert.encoder
        self.hidden = bert.hidden
        self.output = nn.LazyLinear(3)

    def forward(self, inputs):
        tokens_X, segments_X, valid_lens_x = inputs
        encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x)
        return self.output(self.hidden(encoded_X[:, 0, :]))
В дальнейшем предобученная модель BERT bert подается на вход объекту
BERTClassifier net для решения прикладной задачи. В типичных
реализациях дообучения BERT параметры выходного слоя дополнительного MLP
(net.output) обучаются с нуля. Все параметры предобученного
кодировщика BERT (net.encoder) и скрытого слоя дополнительного MLP
(net.hidden) проходят дообучение.
net = BERTClassifier(bert)
Напомним, что в Section 15.8 как классификатор MaskLM, так и
классификатор NextSentencePred используют многослойные перцептроны
(MLP) со своими параметрами. Эти параметры входят в состав параметров
предобученной модели BERT bert, а следовательно, являются частью
параметров в net. Однако эти параметры используются только для
вычисления функции потерь маскированного языкового моделирования и
функции потерь предсказания следующего предложения в процессе
предобучения. Поскольку эти две функции потерь не имеют отношения к
дообучению для прикладных задач, параметры MLP в MaskLM и
NextSentencePred не обновляются (остаются неизменными) при
дообучении BERT.
Чтобы разрешить использование параметров со старыми градиентами, флаг
ignore_stale_grad=True устанавливается в функции step модуля
d2l.train_batch_ch13. Мы используем эту функцию для обучения и
оценки модели net на обучающей выборке (train_iter) и тестовой
выборке (test_iter) набора данных SNLI. В связи с ограниченными
вычислительными ресурсами точность обучения и тестирования может быть
дополнительно повышена; обсуждение этого вопроса мы оставляем для
упражнений.
lr, num_epochs = 1e-4, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction='none')
net(next(iter(train_iter))[0])
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
16.7.4. Резюме
Мы можем дообучить предварительно обученную модель BERT для задач последующей обработки, таких как естественный языковой вывод на наборе данных SNLI.
Во время дообучения модель BERT становится частью модели для прикладной задачи. Параметры, связанные только с функцией потерь предобучения, не обновляются в процессе дообучения.
16.7.5. Упражнения
Дообучите значительно более крупную предварительно обученную модель BERT, размер которой примерно соответствует оригинальной модели BERT base, если ваши вычислительные ресурсы позволяют. Задайте аргументы в функции
load_pretrained_modelследующим образом: замените ‘bert.small’ на ‘bert.base’, а значенияnum_hiddens=256,ffn_num_hiddens=512,num_heads=4иnum_blks=2увеличьте до 768, 3072, 12 и 12 соответственно. Увеличив количество эпох дообучения (и, возможно, настроив другие гиперпараметры), сможете ли вы получить точность на тестовой выборке выше 0,86?Как обрезать пару последовательностей в зависимости от соотношения их длин? Сравните этот метод обрезки пар с тем, который используется в классе
SNLIBERTDataset. Каковы их преимущества и недостатки?