
19.2. API оптимизации гиперпараметров
Прежде чем перейти к методологии, обсудим базовую структуру кода,
позволяющую эффективно реализовывать различные алгоритмы оптимизации
гиперпараметров (HPO). В общем случае все рассматриваемые здесь
алгоритмы HPO должны реализовывать две примитивные операции принятия
решений: поиск и планирование. Во-первых, им необходимо выбирать
новые конфигурации гиперпараметров, что часто включает определённый вид
поиска по пространству конфигураций. Во-вторых, для каждой конфигурации
алгоритм HPO должен планировать её оценку и решать, сколько ресурсов
выделить. Как только мы начинаем оценивать конфигурацию, мы будем
называть её испытанием. Мы отображаем эти решения на два класса,
HPOSearcher и HPOScheduler. Кроме того, мы предоставляем класс
HPOTuner, который выполняет процесс оптимизации.
Эта концепция планировщика и поисковика также реализована в популярных библиотеках оптимизации гиперпараметров, таких как Syne Tune (Salinas et al., 2022), Ray Tune (Liaw et al., 2018) или Optuna (Akiba et al., 2019).
import time
from scipy import stats
from d2l import torch as d2l
19.2.1. Поисковик
Ниже мы определяем базовый класс для поисковых алгоритмов, который
предоставляет новую конфигурацию через функцию sample_configuration.
Простой способ реализации этой функции заключается в равномерной
случайной выборке конфигураций, как мы делали это для случайного поиска
в Section 19.1. Более сложные алгоритмы, такие как
байесовская оптимизация, принимают эти решения на основе результатов
предыдущих испытаний. В результате такие алгоритмы способны со временем
выбирать более перспективные кандидаты. Мы добавляем функцию update
для обновления истории предыдущих испытаний, которую затем можно
использовать для улучшения нашего распределения выборки.
class HPOSearcher(d2l.HyperParameters):  #@save
    def sample_configuration() -> dict:
        raise NotImplementedError

    def update(self, config: dict, error: float, additional_info=None):
        pass
В приведённом ниже коде показано, как реализовать наш оптимизатор
случайного поиска из предыдущего раздела с использованием данного API. В
качестве небольшого расширения мы позволяем пользователю задать первую
конфигурацию для оценки через initial_config, тогда как последующие
выбираются случайным образом.
class RandomSearcher(HPOSearcher):  #@save
    def __init__(self, config_space: dict, initial_config=None):
        self.save_hyperparameters()

    def sample_configuration(self) -> dict:
        if self.initial_config is not None:
            result = self.initial_config
            self.initial_config = None
        else:
            result = {
                name: domain.rvs()
                for name, domain in self.config_space.items()
            }
        return result
19.2.2. Планировщик
Помимо выбора конфигураций для новых экспериментов, нам также необходимо
решать, когда и как долго запускать каждый эксперимент. На практике все
эти решения принимает HPOScheduler, который делегирует выбор новых
конфигураций HPOSearcher. Метод suggest вызывается всякий раз,
когда становится доступным ресурс для обучения. Помимо вызова метода
sample_configuration поискового алгоритма, он также может принимать
решения относительно таких параметров, как max_epochs (то есть, как
долго обучать модель). Метод update вызывается всякий раз, когда
эксперимент возвращает новое наблюдение.
class HPOScheduler(d2l.HyperParameters):  #@save
    def suggest(self) -> dict:
        raise NotImplementedError

    def update(self, config: dict, error: float, info=None):
        raise NotImplementedError
Для реализации случайного поиска, а также других алгоритмов оптимизации гиперпараметров (HPO), достаточно базового планировщика, который назначает новую конфигурацию каждый раз, когда становятся доступны новые ресурсы.
class BasicScheduler(HPOScheduler):  #@save
    def __init__(self, searcher: HPOSearcher):
        self.save_hyperparameters()

    def suggest(self) -> dict:
        return self.searcher.sample_configuration()

    def update(self, config: dict, error: float, info=None):
        self.searcher.update(config, error, additional_info=info)
19.2.3. Тюнер
Наконец, нам нужен компонент, который запускает планировщик/поисковик и ведёт учёт результатов. Приведённый ниже код реализует последовательное выполнение испытаний HPO, оценивая одну задачу обучения за другой, и будет служить базовым примером. Позже мы будем использовать Syne Tune для более масштабируемых распределённых случаев HPO.
class HPOTuner(d2l.HyperParameters):  #@save
    def __init__(self, scheduler: HPOScheduler, objective: callable):
        self.save_hyperparameters()
        # Bookeeping results for plotting
        self.incumbent = None
        self.incumbent_error = None
        self.incumbent_trajectory = []
        self.cumulative_runtime = []
        self.current_runtime = 0
        self.records = []

    def run(self, number_of_trials):
        for i in range(number_of_trials):
            start_time = time.time()
            config = self.scheduler.suggest()
            print(f"Trial {i}: config = {config}")
            error = self.objective(**config)
            error = float(error.cpu().detach().numpy())
            self.scheduler.update(config, error)
            runtime = time.time() - start_time
            self.bookkeeping(config, error, runtime)
            print(f"    error = {error}, runtime = {runtime}")
19.2.4. Учёт производительности алгоритмов HPO
При использовании любого алгоритма HPO нас в первую очередь интересует
конфигурация с наилучшей производительностью (называемая инкумбентом)
и её ошибка валидации по прошествии заданного времени. Именно поэтому мы
отслеживаем runtime на каждой итерации, что включает как время
выполнения оценки (вызов objective), так и время принятия решения
(вызов scheduler.suggest). Далее мы будем строить график зависимости
cumulative_runtime от incumbent_trajectory, чтобы
визуализировать производительность в любой момент времени алгоритма
HPO, определяемую через scheduler (и searcher). Это позволяет
нам количественно оценить не только то, насколько хорошо работает
конфигурация, найденная оптимизатором, но и то, как быстро оптимизатор
способен её найти.
@d2l.add_to_class(HPOTuner)  #@save
def bookkeeping(self, config: dict, error: float, runtime: float):
    self.records.append({"config": config, "error": error, "runtime": runtime})
    # Check if the last hyperparameter configuration performs better
    # than the incumbent
    if self.incumbent is None or self.incumbent_error > error:
        self.incumbent = config
        self.incumbent_error = error
    # Add current best observed performance to the optimization trajectory
    self.incumbent_trajectory.append(self.incumbent_error)
    # Update runtime
    self.current_runtime += runtime
    self.cumulative_runtime.append(self.current_runtime)
19.2.5. Пример: Оптимизация гиперпараметров свёрточной нейронной сети
Теперь мы используем нашу новую реализацию случайного поиска для
оптимизации размера батча и скорости обучения LeNet свёрточной
нейронной сети из Section 7.6. Мы начинаем с определения
целевой функции, которой вновь будет ошибка на валидационной выборке.
def hpo_objective_lenet(learning_rate, batch_size, max_epochs=10):  #@save
    model = d2l.LeNet(lr=learning_rate, num_classes=10)
    trainer = d2l.HPOTrainer(max_epochs=max_epochs, num_gpus=1)
    data = d2l.FashionMNIST(batch_size=batch_size)
    model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
    trainer.fit(model=model, data=data)
    validation_error = trainer.validation_error()
    return validation_error
Нам также необходимо определить пространство конфигураций. При этом первой конфигурацией, подлежащей оценке, будет настройка по умолчанию, использованная в Section 7.6.
config_space = {
    "learning_rate": stats.loguniform(1e-2, 1),
    "batch_size": stats.randint(32, 256),
}
initial_config = {
    "learning_rate": 0.1,
    "batch_size": 128,
}
Теперь мы можем приступить к случайному поиску:
searcher = RandomSearcher(config_space, initial_config=initial_config)
scheduler = BasicScheduler(searcher=searcher)
tuner = HPOTuner(scheduler=scheduler, objective=hpo_objective_lenet)
tuner.run(number_of_trials=5)
Ниже мы построим график траектории оптимизации текущего лучшего решения, чтобы получить производительность случайного поиска в любой момент времени:
board = d2l.ProgressBoard(xlabel="time", ylabel="error")
for time_stamp, error in zip(
    tuner.cumulative_runtime, tuner.incumbent_trajectory
):
    board.draw(time_stamp, error, "random search", every_n=1)
19.2.6. Сравнение алгоритмов HPO
Так же как и при сравнении алгоритмов обучения или архитектур моделей, важно понимать, как наилучшим образом сравнивать различные алгоритмы настройки гиперпараметров (HPO). Каждый запуск HPO зависит от двух основных источников случайности: случайных факторов процесса обучения, таких как случайная инициализация весов или порядок формирования мини-выборок, и внутренней случайности самого алгоритма HPO, например, случайной выборке при случайном поиске. Следовательно, при сравнении различных алгоритмов критически важно запускать каждый эксперимент несколько раз и сообщать статистические показатели, такие как среднее значение или медиана, по совокупности нескольких повторений алгоритма с использованием различных начальных значений генератора случайных чисел.
Чтобы проиллюстрировать это, мы сравним случайный поиск (см. Section 19.1.2) и байесовскую оптимизацию (Snoek et al., 2012) при настройке гиперпараметров нейронной сети прямого распространения. Каждый алгоритм оценивался \(50\) раз с разными случайными начальными значениями. Сплошная линия показывает среднюю производительность лучшей найденной конфигурации по этим \(50\) повторениям, а пунктирная — стандартное отклонение. Мы видим, что случайный поиск и байесовская оптимизация демонстрируют примерно одинаковые результаты вплоть до ~1000 секунд, однако байесовская оптимизация способна использовать предыдущие наблюдения для выявления более эффективных конфигураций, благодаря чему после этого момента она начинает значительно превосходить случайный поиск.
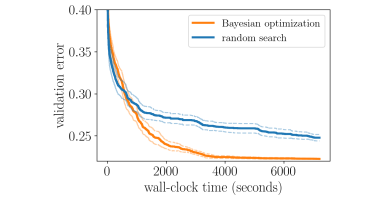
Fig. 19.2.1 Пример графика производительности в любой момент времени для сравнения двух алгоритмов A и B.
19.2.7. Итоги
В этом разделе мы описали простой, но гибкий интерфейс для реализации различных алгоритмов HPO, которые будут рассмотрены в этой главе. Аналогичные интерфейсы можно найти в популярных открытых фреймворках для HPO. Мы также обсудили методы сравнения алгоритмов HPO и потенциальные ошибки, на которые следует обратить внимание.
19.2.8. Упражнения
Цель этого упражнения — реализовать целевую функцию для чуть более сложной задачи HPO и провести более реалистичные эксперименты. Мы будем использовать многослойный перцептрон с двумя скрытыми слоями
DropoutMLP, реализованный в Section 5.6.Реализуйте целевую функцию, которая должна зависеть от всех гиперпараметров модели и
batch_size. Используйтеmax_epochs=50. Графические процессоры здесь не помогут, поэтомуnum_gpus=0. Подсказка: изменитеhpo_objective_lenet.Выберите разумное пространство поиска, где
num_hiddens_1иnum_hiddens_2— целые числа из \([8, 1024]\), значения дропаута находятся в диапазоне \([0, 0.95]\), аbatch_size— в диапазоне \([16, 384]\). Предоставьте код дляconfig_space, используя разумные распределения изscipy.stats.Выполните случайный поиск на этом примере с
number_of_trials=20и постройте графики результатов. Убедитесь, что сначала вы оценили конфигурацию по умолчанию Section 5.6, которая равнаinitial_config = {'num_hiddens_1': 256, 'num_hiddens_2': 256, 'dropout_1': 0.5, 'dropout_2': 0.5, 'lr': 0.1, 'batch_size': 256}.
В этом упражнении вы реализуете новый алгоритм поиска (подкласс
HPOSearcher), который принимает решения на основе предыдущих данных. Он зависит от параметровprobab_local,num_init_random. Его методsample_configurationработает следующим образом. Для первыхnum_init_randomвызовов поступайте так же, как вRandomSearcher.sample_configuration. В противном случае с вероятностью1 - probab_localпоступайте так же, как вRandomSearcher.sample_configuration. В остальных случаях выберите конфигурацию, достигшую наименьшей ошибки на валидационной выборке на данный момент, случайным образом выберите один из её гиперпараметров и случайным образом выберите его значение, как вRandomSearcher.sample_configuration, но оставьте все остальные значения неизменными. Верните эту конфигурацию, которая идентична лучшей конфигурации на данный момент, за исключением одного гиперпараметра.Реализуйте новый
LocalSearcher. Подсказка: при создании вашего поисковика требуется передатьconfig_spaceв качестве аргумента. Вы можете использовать поле типаRandomSearcher. Вам также потребуется реализовать методupdate.Повторите эксперимент из предыдущего упражнения, но используйте вместо
RandomSearcherваш новый алгоритм поиска. Экспериментируйте с различными значениямиprobab_localиnum_init_random. Обратите внимание, что для корректного сравнения различных методов HPO необходимо повторять эксперименты несколько раз и, в идеале, использовать ряд бенчмарк-задач.