
7.5. Пулинг
Во многих случаях конечная задача требует ответа на глобальный вопрос об изображении, например: содержит ли оно кошку? Следовательно, нейроны нашего последнего слоя должны реагировать на весь входной сигнал. Постепенно агрегируя информацию и получая всё более грубые карты признаков, мы достигаем цели обучения глобального представления, сохраняя при этом все преимущества свёрточных слоёв на промежуточных этапах обработки. Чем глубже мы продвигаемся по сети, тем больше рецептивное поле (относительно входа), к которому чувствителен каждый скрытый узел. Снижение пространственного разрешения ускоряет этот процесс, поскольку свёрточные ядра охватывают большую эффективную область.
Более того, при обнаружении признаков нижнего уровня, таких как края
(как обсуждалось в Section 7.2), мы часто хотим, чтобы
наши представления были в некоторой степени инвариантны к сдвигу.
Например, если мы возьмем изображение X с резкой границей между
черным и белым и сдвинем его на один пиксель вправо, т.е.
Z[i, j] = X[i, j + 1], то выход для нового изображения Z может
оказаться совершенно другим. Край сместится на один пиксель. На практике
объекты редко оказываются в одном и том же месте. Более того, даже при
использовании штатива и неподвижного объекта вибрация камеры из-за
движения затвора может сдвинуть всё примерно на один пиксель (в камерах
высокого класса предусмотрены специальные функции для решения этой
проблемы).
В этом разделе вводятся слои пулинга, которые выполняют две функции: снижение чувствительности свёрточных слоёв к положению и пространственное уменьшение размерности представлений.
import torch
from torch import nn
from d2l import torch as d2l
7.5.1. Максимальный пулинг и средний пулинг
Как и в свёрточных слоях, операторы пулинга используют окно фиксированной формы, которое скользит по всем областям входных данных с заданным шагом, вычисляя одно выходное значение для каждой позиции, пройденной окном фиксированной формы (иногда называемым окном пулинга). Однако, в отличие от вычисления кросс-корреляции между входными данными и ядрами в свёрточном слое, в слое пулинга отсутствуют параметры (отсутствует ядро). Вместо этого операторы пулинга являются детерминированными и обычно вычисляют либо максимальное, либо среднее значение элементов в окне пулинга. Эти операции называются максимальным пулингом (max-pooling для краткости) и средним пулингом соответственно.
Средний пулинг по своей сути так же стар, как и свёрточные нейронные сети. Эта идея аналогична уменьшению разрешения изображения. Вместо того чтобы просто брать значение каждого второго (или третьего) пикселя для изображения с меньшим разрешением, мы можем усреднять значения соседних пикселей, чтобы получить изображение с лучшим отношением сигнал/шум, поскольку мы объединяем информацию из нескольких соседних пикселей. Максимальный пулинг был предложен в Riesenhuber and Poggio (1999) в контексте когнитивной нейронауки для описания того, как иерархическая агрегация информации может использоваться для распознавания объектов; ранее уже существовала его более ранняя версия в задачах распознавания речи (Yamaguchi et al., 1990). В большинстве случаев максимальный пулинг, как его также называют, предпочтительнее среднего пулинга.
В обоих случаях, как и в случае с оператором кросс-корреляции, мы можем считать, что окно пулинга начинает движение с верхнего левого угла входного тензора и скользит по нему слева направо и сверху вниз. В каждой позиции, где оказывается окно пулинга, оно вычисляет максимальное или среднее значение входного подтензора в пределах окна в зависимости от того, используется ли максимальный или средний пулинг.
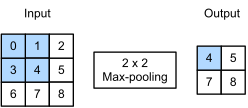
Fig. 7.5.1 Пулинг с использованием максимального значения и формой окна пулинга \(2\times 2\). Затенённые области обозначают первый элемент выходного тензора, а также элементы входного тензора, использованные для вычисления этого элемента: \(\max(0, 1, 3, 4)=4\).
Выходной тензор в Fig. 7.5.1 имеет высоту 2 и ширину 2. Четыре элемента получены из максимальных значений в каждом окне пулинга:
Более того, мы можем определить \(p \times q\) пулинг-слой,
агрегируя значения в области указанного размера. Возвращаясь к задаче
обнаружения краев, мы используем выход свёрточного слоя в качестве входа
для \(2\times 2\) max-pooling. Обозначим через X вход
свёрточного слоя и через Y выход пулинг-слоя. Независимо от того,
различаются ли значения X[i, j], X[i, j + 1], X[i+1, j] и
X[i+1, j + 1], пулинг-слой всегда выдает Y[i, j] = 1. Иными
словами, используя \(2\times 2\) max-pooling-слой, мы по-прежнему
можем обнаружить, если паттерн, распознанный свёрточным слоем, смещается
не более чем на один элемент по высоте или ширине.
В приведённом ниже коде мы реализуем прямое распространение слоя
пулинга в функции pool2d. Эта функция аналогична функции
corr2d из Section 7.2. Однако ядро не требуется,
поскольку выход вычисляется как максимум или среднее значение для каждой
области входных данных.
def pool2d(X, pool_size, mode='max'):
    p_h, p_w = pool_size
    Y = torch.zeros((X.shape[0] - p_h + 1, X.shape[1] - p_w + 1))
    for i in range(Y.shape[0]):
        for j in range(Y.shape[1]):
            if mode == 'max':
                Y[i, j] = X[i: i + p_h, j: j + p_w].max()
            elif mode == 'avg':
                Y[i, j] = X[i: i + p_h, j: j + p_w].mean()
    return Y
Мы можем сформировать входной тензор X в Fig. 7.5.1,
чтобы проверить выходные данные двумерного слоя максимального пулинга.
X = torch.tensor([[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]])
pool2d(X, (2, 2))
Кроме того, мы можем поэкспериментировать с слоем усредняющего пулинга.
pool2d(X, (2, 2), 'avg')
7.5.2. Дополнение и шаг
Как и в случае со свёрточными слоями, слои пулинга изменяют выходную
форму. И, как и ранее, мы можем настроить операцию, чтобы получить
желаемую выходную форму, применяя дополнение к входным данным и изменяя
шаг. Мы можем продемонстрировать использование дополнения и шага в слоях
пулинга с помощью встроенного двумерного слоя максимального пулинга из
фреймворка глубокого обучения. Сначала мы создадим входной тензор X,
форма которого имеет четыре измерения, где количество примеров (размер
батча) и количество каналов равны 1.
X = torch.arange(16, dtype=torch.float32).reshape((1, 1, 4, 4))
X
Поскольку пулинг агрегирует информацию из области, фреймворки
глубокого обучения по умолчанию устанавливают шаг, равный размеру окна
пулинга. Например, если мы используем окно пулинга формы (3, 3),
то по умолчанию получим шаг формы (3, 3).
pool2d = nn.MaxPool2d(3)
# Pooling has no model parameters, hence it needs no initialization
pool2d(X)
Разумеется, шаг и дополнение можно задать вручную, чтобы переопределить значения по умолчанию фреймворка, если это необходимо.
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
pool2d(X)
Конечно, мы можем задать произвольное прямоугольное окно пулинга с произвольной высотой и шириной, как показывает пример ниже.
pool2d = nn.MaxPool2d((2, 3), stride=(2, 3), padding=(0, 1))
pool2d(X)
7.5.3. Несколько каналов
При обработке многоканальных входных данных слой пулинга выполняет
пулинг каждого входного канала отдельно, а не суммирует их по каналам,
как в свёрточном слое. Это означает, что количество выходных каналов
слоя пулинга совпадает с количеством входных каналов. Ниже мы объединим
тензоры X и X + 1 по размерности каналов, чтобы сформировать
вход с двумя каналами.
X = torch.cat((X, X + 1), 1)
X
Как мы видим, количество выходных каналов по-прежнему равно двум после пулинга.
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
pool2d(X)
7.5.4. Итоги
Пулинг — чрезвычайно простая операция. Она делает ровно то, на что указывает её название: агрегирует значения в пределах окна. Все параметры свёртки, такие как шаг и дополнение, применяются так же, как и ранее. Обратите внимание, что пулинг не учитывает каналы, то есть он не изменяет количество каналов и применяется к каждому каналу отдельно. Наконец, из двух популярных вариантов предпочтительнее использовать максимальный пулинг, поскольку он обеспечивает некоторую степень инвариантности выходных данных. Популярным выбором является размер окна пулинга \(2 \times 2\), который уменьшает пространственное разрешение выходных данных в четыре раза.
Обратите внимание, что способов снижения разрешения существует гораздо больше, чем просто пулинг. Например, в стохастическом пулинге (Zeiler and Fergus, 2013) и дробном максимальном пулинге (Graham, 2014) агрегация сочетается со случайностью. Это может незначительно повысить точность в некоторых случаях. Наконец, как мы увидим позже при рассмотрении механизма внимания, существуют более изощренные способы агрегации по выходам, например, с использованием выравнивания между векторами запроса и представления.
7.5.5. Упражнения
Реализуйте пулинг усреднением через свёртку.
Докажите, что максимальный пулинг не может быть реализован исключительно с помощью свёртки.
Макс-пулинг может быть реализован с помощью операций ReLU, то есть \(\textrm{ReLU}(x) = \max(0, x)\).
Выразите \(\max (a, b)\), используя только операции ReLU.
Используйте это для реализации максимального пулинга с помощью свёрточных слоёв и слоёв ReLU.
Сколько каналов и слоёв требуется для свёртки \(2 \times 2\)? Сколько для свёртки \(3 \times 3\)?
Какова вычислительная стоимость слоя пулинга? Предположим, что входные данные слоя пулинга имеют форму \(c\times h\times w\), окно пулинга имеет форму \(p_\textrm{h}\times p_\textrm{w}\), дополнение равно \((p_\textrm{h}, p_\textrm{w})\), а шаг равен \((s_\textrm{h}, s_\textrm{w})\).
Почему вы ожидаете, что max-пулинг и average-пулинг будут работать по-разному?
Нужен ли нам отдельный слой минимального пулинга? Можно ли заменить его другой операцией?
Мы могли бы использовать операцию софтмакс для пулинга. Почему она не так популярна?