
11.8. Трансформеры для компьютерного зрения
Архитектура трансформера изначально была предложена для обучения задачам «последовательность-в-последовательность» с акцентом на машинный перевод. Впоследствии трансформеры стали моделями выбора для различных задач обработки естественного языка (Brown et al., 2020, Devlin et al., 2018, Radford et al., 2018, Radford et al., 2019, Raffel et al., 2020). Однако в области компьютерного зрения доминирующей архитектурой оставалась свёрточная нейронная сеть (CNN) Section 8. Естественным образом исследователи начали задаваться вопросом: возможно ли добиться лучших результатов, адаптировав модели трансформеров для работы с изображениями. Этот вопрос вызвал огромный интерес в сообществе компьютерного зрения. Недавно Ramachandran et al. (2019) предложили схему замены свёртки на самовнимание. Однако использование ими специализированных паттернов в механизме внимания затрудняет масштабирование моделей на аппаратных ускорителях. Затем Cordonnier et al. (2020) теоретически доказали, что самовнимание может научиться вести себя аналогично свёртке. Эмпирически \(2 \times 2\) использовали фрагменты изображений в качестве входных данных, но малый размер фрагментов ограничивает применимость модели только изображениями низкого разрешения.
Без жёстких ограничений на размер патчей трансформеры для зрения (ViT) извлекают патчи из изображений и передают их в кодировщик трансформера для получения глобального представления, которое затем преобразуется для классификации (Dosovitskiy et al., 2021). Примечательно, что трансформеры демонстрируют лучшую масштабируемость по сравнению с CNN: при обучении более крупных моделей на более крупных наборах данных трансформеры для зрения значительно превосходят ResNet. Подобно тому, как это произошло в области проектирования архитектур сетей для обработки естественного языка, трансформеры также стали переломным моментом в компьютерном зрении.
import torch
from torch import nn
from d2l import torch as d2l
11.8.1. Модель
Fig. 11.8.1 изображает архитектуру модели трансформеров для зрения. Эта архитектура состоит из стема, который разбивает изображения на патчи, тела на основе многослойного кодировщика трансформера и головы, которая преобразует глобальное представление в выходную метку.
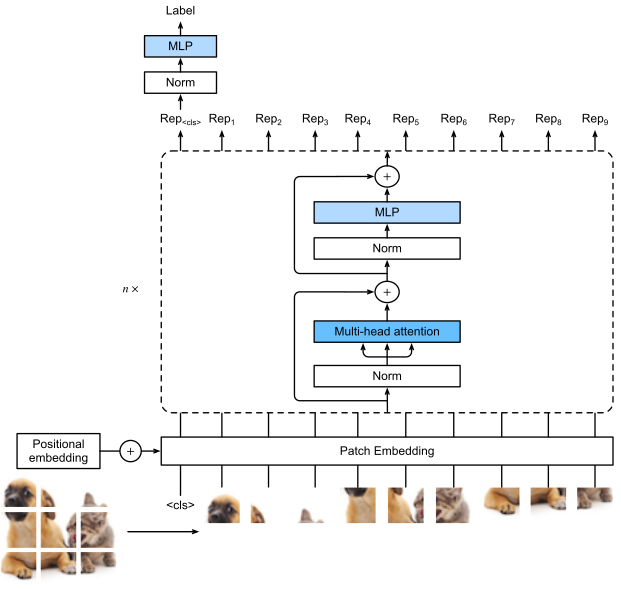
Fig. 11.8.1 Архитектура Vision Transformer. В этом примере изображение разбивается на девять патчей. Специальный токен «» и девять сплющенных патчей изображения преобразуются с помощью эмбеддинга патчей и \(\mathit{n}\) блоков кодировщика трансформера в десять представлений соответственно. Представление «» далее преобразуется в выходную метку.
Рассмотрим входное изображение высотой \(h\), шириной \(w\) и с \(c\) каналами. Если задать высоту и ширину патча равными \(p\), изображение разбивается на последовательность из \(m = hw/p^2\) патчей, каждый из которых сворачивается в вектор длины \(cp^2\). Таким образом, патчи изображения можно обрабатывать аналогично токенам в текстовых последовательностях с помощью кодировщиков трансформера. Специальный токен «<cls>» (class) и \(m\) сплюснутых патчей изображения линейно проецируются в последовательность из \(m+1\) векторов, к которым прибавляются обучаемые позиционные эмбеддинги. Многоуровневый кодировщик трансформера преобразует \(m+1\) входных векторов в такое же количество выходных векторных представлений той же длины. Он работает точно так же, как исходный кодировщик трансформера в Fig. 11.7.1, за исключением положения нормализации. Поскольку токен «<cls>» обращает внимание на все патчи изображения посредством самовнимания (см. Fig. 11.6.1), его представление на выходе кодировщика трансформера будет дополнительно преобразовано в выходную метку.
11.8.2. Встраивание патчей
Для реализации визуального трансформера начнем с эмбеддинга патчей в Fig. 11.8.1. Разбиение изображения на патчи и линейная проекция этих сплющенных патчей можно упростить до одной операции свёртки, при этом размер ядра и шаг устанавливаются равными размеру патча.
class PatchEmbedding(nn.Module):
    def __init__(self, img_size=96, patch_size=16, num_hiddens=512):
        super().__init__()
        def _make_tuple(x):
            if not isinstance(x, (list, tuple)):
                return (x, x)
            return x
        img_size, patch_size = _make_tuple(img_size), _make_tuple(patch_size)
        self.num_patches = (img_size[0] // patch_size[0]) * (
            img_size[1] // patch_size[1])
        self.conv = nn.LazyConv2d(num_hiddens, kernel_size=patch_size,
                                  stride=patch_size)

    def forward(self, X):
        # Output shape: (batch size, no. of patches, no. of channels)
        return self.conv(X).flatten(2).transpose(1, 2)
В следующем примере, где изображения с высотой и шириной img_size
подаются на вход, эмбеддинг патчей выдает (img_size//patch_size)**2
патчей, которые линейно проецируются в векторы длины num_hiddens.
img_size, patch_size, num_hiddens, batch_size = 96, 16, 512, 4
patch_emb = PatchEmbedding(img_size, patch_size, num_hiddens)
X = torch.zeros(batch_size, 3, img_size, img_size)
d2l.check_shape(patch_emb(X),
                (batch_size, (img_size//patch_size)**2, num_hiddens))
11.8.3. Кодировщик Vision Transformer
Многослойный перцептрон (MLP) кодировщика Vision Transformer немного отличается от позиционно-независимой полносвязной сети (FFN) оригинального кодировщика трансформера (см. Section 11.7.2). Во-первых, в качестве функции активации здесь используется гауссовская линейная единица (GELU), которую можно рассматривать как более плавный аналог ReLU (Hendrycks and Gimpel, 2016). Во-вторых, для регуляризации к выходу каждого полносвязного слоя в MLP применяется дропаут.
class ViTMLP(nn.Module):
    def __init__(self, mlp_num_hiddens, mlp_num_outputs, dropout=0.5):
        super().__init__()
        self.dense1 = nn.LazyLinear(mlp_num_hiddens)
        self.gelu = nn.GELU()
        self.dropout1 = nn.Dropout(dropout)
        self.dense2 = nn.LazyLinear(mlp_num_outputs)
        self.dropout2 = nn.Dropout(dropout)

    def forward(self, x):
        return self.dropout2(self.dense2(self.dropout1(self.gelu(
            self.dense1(x)))))
Реализация блока кодировщика Vision Transformer следует архитектуре с предварительной нормализацией, описанной в Fig. 11.8.1, где нормализация применяется непосредственно перед механизмом многоголовного внимания или блоком MLP. В отличие от пост-нормализации («add & norm» в Fig. 11.7.1), при которой нормализация выполняется сразу после остаточных связей, предварительная нормализация обеспечивает более эффективное или быстрое обучение трансформеров (Baevski and Auli, 2018, Wang et al., 2019, Xiong et al., 2020).
class ViTBlock(nn.Module):
    def __init__(self, num_hiddens, norm_shape, mlp_num_hiddens,
                 num_heads, dropout, use_bias=False):
        super().__init__()
        self.ln1 = nn.LayerNorm(norm_shape)
        self.attention = d2l.MultiHeadAttention(num_hiddens, num_heads,
                                                dropout, use_bias)
        self.ln2 = nn.LayerNorm(norm_shape)
        self.mlp = ViTMLP(mlp_num_hiddens, num_hiddens, dropout)

    def forward(self, X, valid_lens=None):
        X = X + self.attention(*([self.ln1(X)] * 3), valid_lens)
        return X + self.mlp(self.ln2(X))
Как и в Section 11.7.4, блок кодировщика трансформера для зрения не изменяет форму своих входных данных.
X = torch.ones((2, 100, 24))
encoder_blk = ViTBlock(24, 24, 48, 8, 0.5)
encoder_blk.eval()
d2l.check_shape(encoder_blk(X), X.shape)
11.8.4. Собираем всё вместе
Прямой проход в трансформерах для зрения, приведённый ниже, прост.
Сначала входные изображения подаются в объект PatchEmbedding, вывод
которого конкатенируется с эмбеддингом токена «<cls>». Затем они
суммируются с обучаемыми позиционными эмбеддингами перед применением
дропаута. После этого вывод подается в кодировщик трансформера, который
состоит из num_blks экземпляров класса ViTBlock. Наконец,
представление токена «<cls>» проецируется головкой сети.
class ViT(d2l.Classifier):
    """Vision Transformer."""
    def __init__(self, img_size, patch_size, num_hiddens, mlp_num_hiddens,
                 num_heads, num_blks, emb_dropout, blk_dropout, lr=0.1,
                 use_bias=False, num_classes=10):
        super().__init__()
        self.save_hyperparameters()
        self.patch_embedding = PatchEmbedding(
            img_size, patch_size, num_hiddens)
        self.cls_token = nn.Parameter(torch.zeros(1, 1, num_hiddens))
        num_steps = self.patch_embedding.num_patches + 1  # Add the cls token
        # Positional embeddings are learnable
        self.pos_embedding = nn.Parameter(
            torch.randn(1, num_steps, num_hiddens))
        self.dropout = nn.Dropout(emb_dropout)
        self.blks = nn.Sequential()
        for i in range(num_blks):
            self.blks.add_module(f"{i}", ViTBlock(
                num_hiddens, num_hiddens, mlp_num_hiddens,
                num_heads, blk_dropout, use_bias))
        self.head = nn.Sequential(nn.LayerNorm(num_hiddens),
                                  nn.Linear(num_hiddens, num_classes))

    def forward(self, X):
        X = self.patch_embedding(X)
        X = torch.cat((self.cls_token.expand(X.shape[0], -1, -1), X), 1)
        X = self.dropout(X + self.pos_embedding)
        for blk in self.blks:
            X = blk(X)
        return self.head(X[:, 0])
11.8.5. Обучение
Обучение визуального трансформера на наборе данных Fashion-MNIST аналогично обучению свёрточных нейронных сетей, описанному в Section 8.
img_size, patch_size = 96, 16
num_hiddens, mlp_num_hiddens, num_heads, num_blks = 512, 2048, 8, 2
emb_dropout, blk_dropout, lr = 0.1, 0.1, 0.1
model = ViT(img_size, patch_size, num_hiddens, mlp_num_hiddens, num_heads,
            num_blks, emb_dropout, blk_dropout, lr)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(img_size, img_size))
trainer.fit(model, data)
11.8.6. Итоги и обсуждение
Вы могли заметить, что для небольших наборов данных, таких как Fashion-MNIST, реализованный нами Vision Transformer не превосходит ResNet в Section 8.6. Аналогичные наблюдения можно сделать даже на наборе данных ImageNet (1,2 миллиона изображений). Это связано с тем, что трансформеры не обладают такими полезными свойствами свёрток, как инвариантность к сдвигу и локальность (Section 7.1). Однако ситуация меняется при обучении более крупных моделей на больших наборах данных (например, 300 миллионов изображений), где Vision Transformer значительно превосходит ResNet в классификации изображений, демонстрируя внутреннее преимущество трансформеров в масштабируемости (Dosovitskiy et al., 2021). Появление Vision Transformer изменило ландшафт проектирования сетей для моделирования изображений. Вскоре было показано, что они эффективны на наборе данных ImageNet при использовании стратегий обучения, требующих меньшего объёма данных, как в DeiT (Touvron et al., 2021). Однако квадратичная сложность самовнимания (Section 11.6) делает архитектуру трансформера менее подходящей для изображений высокого разрешения. В стремлении создать универсальную базовую сеть для компьютерного зрения, Swin Transformer решил проблему квадратичной вычислительной сложности относительно размера изображения (Section 11.6.2) и восстановил приоритеты, подобные свёрточным, расширив применимость трансформеров на ряд задач компьютерного зрения за пределами классификации изображений, достигнув наивысших результатов (Liu et al., 2021).
11.8.7. Упражнения
Как значение
img_sizeвлияет на время обучения?Вместо проецирования представления токена
<cls>на выход, как бы вы спроецировали усреднённые представления патчей? Реализуйте это изменение и посмотрите, как оно повлияет на точность.Можете ли вы изменить гиперпараметры, чтобы повысить точность трансформера для зрения?