
15.1. Эмбеддинг слов (word2vec)
Естественный язык — это сложная система, используемая для выражения смыслов. В этой системе слова являются базовой единицей смысла. Как следует из названия, векторы слов — это векторы, используемые для представления слов, которые также можно рассматривать как векторы признаков или представления слов. Техника отображения слов в вещественные векторы называется эмбеддингом слов. В последние годы эмбеддинг слов постепенно стал базовым знанием в области обработки естественного языка.
15.1.1. Векторы с одним активным элементом — плохой выбор
В разделе Section 9.5 мы использовали one-hot-векторы для представления слов (символы также считаются словами). Предположим, что количество различных слов в словаре (размер словаря) равно \(N\), и каждому слову соответствует уникальное целое число (индекс) от \(0\) до \(N-1\). Чтобы получить one-hot-векторное представление для любого слова с индексом \(i\), мы создаём вектор длины \(N\), состоящий из нулей, и устанавливаем значение элемента на позиции \(i\) равным 1. Таким образом, каждое слово представляется в виде вектора длины \(N\), который может быть непосредственно использован нейронными сетями.
Хотя одномерные векторы слов легко конструировать, обычно они не являются хорошим выбором. Основная причина заключается в том, что одномерные векторы слов не позволяют точно выразить степень сходства между различными словами, например, с помощью косинусного сходства, которое мы часто используем. Для векторов \(\mathbf{x}, \mathbf{y} \in \mathbb{R}^d\) их косинусное сходство равно косинусу угла между ними:
Поскольку косинусное сходство между one-hot-векторами любых двух различных слов равно нулю, one-hot-векторы не могут кодировать сходства между словами.
15.1.2. Самостоятельное обучение word2vec
Инструмент word2vec был предложен для решения указанной выше проблемы. Он отображает каждое слово в вектор фиксированной длины, причём эти векторы позволяют лучше выражать сходство и аналогичные отношения между различными словами. Инструмент word2vec включает две модели, а именно skip-gram (Mikolov et al., 2013) и continuous bag of words (CBOW) (Mikolov et al., 2013). Для получения семантически значимых представлений их обучение опирается на условные вероятности, которые можно рассматривать как предсказание некоторых слов на основе некоторых из окружающих их слов в корпусе. Поскольку обучение происходит на данных без меток, как skip-gram, так и continuous bag of words являются моделями с самообучением.
В дальнейшем мы рассмотрим эти две модели и методы их обучения.
15.1.3. Модель Skip-Gram
Модель skip-gram предполагает, что слово может использоваться для генерации окружающих его слов в текстовой последовательности. Возьмем текстовую последовательность «the», «man», «loves», «his», «son» в качестве примера. Пусть слово «loves» будет центральным словом, а размер контекстного окна равен 2. Как показано на Fig. 15.1.1, при заданном центральном слове «loves» модель skip-gram рассматривает условную вероятность генерации контекстных слов: «the», «man», «his» и «son», которые находятся на расстоянии не более двух слов от центрального слова:
Предположим, что контекстные слова генерируются независимо при заданном центральном слове (т. е. условие условной независимости). В этом случае вышеуказанная условная вероятность может быть переписана как
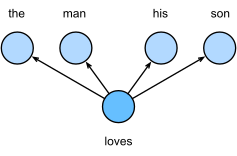
Fig. 15.1.1 Модель skip-gram рассматривает условную вероятность генерации окружающих контекстных слов при заданном центральном слове.
В модели skip-gram каждое слово имеет два \(d\)-мерных векторных представления для вычисления условных вероятностей. Более конкретно, для любого слова с индексом \(i\) в словаре обозначим через \(\mathbf{v}_i\in\mathbb{R}^d\) и \(\mathbf{u}_i\in\mathbb{R}^d\) его два вектора, используемые соответственно в качестве центрального слова и слова контекста. Условная вероятность появления любого слова контекста \(w_o\) (с индексом \(o\) в словаре) при заданном центральном слове \(w_c\) (с индексом \(c\) в словаре) может быть смоделирована с помощью операции софтмакс над скалярными произведениями векторов:
где \(\mathcal{V} = \{0, 1, \ldots, |\mathcal{V}|-1\}\) — множество индексов словаря. Рассмотрим текстовую последовательность длины \(T\), в которой слово на шаге времени \(t\) обозначается как \(w^{(t)}\). Предположим, что контекстные слова генерируются независимо при заданном центральном слове. Для размера контекстного окна \(m\) функция правдоподобия модели Skip-Gram представляет собой вероятность генерации всех контекстных слов при заданном центральном слове:
где любые временные шаги, меньшие \(1\) или большие \(T\), могут быть опущены.
15.1.3.1. Обучение
Параметры модели skip-gram — это векторы центрального слова и контекстного слова для каждого слова в словаре. В процессе обучения мы находим параметры модели, максимизируя функцию правдоподобия (то есть применяя метод максимального правдоподобия). Это эквивалентно минимизации следующей функции потерь:
При использовании стохастического градиентного спуска для минимизации функции потерь на каждой итерации мы можем случайным образом выбрать более короткую подпоследовательность и вычислить (стохастический) градиент по этой подпоследовательности для обновления параметров модели. Чтобы вычислить этот (стохастический) градиент, нам необходимо получить градиенты логарифма условной вероятности по вектору центрального слова и вектору контекстного слова. В общем случае, согласно (15.1.4), логарифм условной вероятности, включающей любую пару центрального слова \(w_c\) и контекстного слова \(w_o\), равен
С помощью дифференцирования мы можем получить его градиент по вектору центрального слова \(\mathbf{v}_c\):
Обратите внимание, что вычисление в (15.1.8) требует знания условных вероятностей всех слов в словаре при условии, что \(w_c\) является центральным словом. Градиенты для остальных векторов слов могут быть получены аналогичным образом.
После обучения для любого слова с индексом \(i\) в словаре мы получаем как векторы центрального слова \(\mathbf{v}_i\), так и векторы контекстного слова \(\mathbf{u}_i\). В задачах обработки естественного языка векторы центрального слова модели skip-gram обычно используются в качестве представлений слов.
15.1.4. Модель непрерывного суммирования слов (CBOW)
Модель непрерывного мешка слов (CBOW) аналогична модели skip-gram. Главное отличие модели непрерывного мешка слов от модели skip-gram заключается в том, что она предполагает, что центральное слово генерируется на основе окружающих его слов контекста в текстовой последовательности. Например, в той же текстовой последовательности «the», «man», «loves», «his» и «son», где «loves» является центральным словом, а размер окна контекста равен 2, модель непрерывного мешка слов рассматривает условную вероятность генерации центрального слова «loves» на основе слов контекста «the», «man», «his» и «son» (как показано на Fig. 15.1.2), которая равна
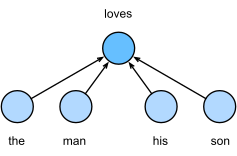
Fig. 15.1.2 Модель непрерывного мешка слов (CBOW) рассматривает условную вероятность генерации центрального слова при заданных окружающих его словах контекста.
Поскольку в модели непрерывного мешка слов (CBOW) используется несколько контекстных слов, их векторы усредняются при вычислении условной вероятности. Конкретно, для любого слова с индексом \(i\) в словаре обозначим через \(\mathbf{v}_i\in\mathbb{R}^d\) и \(\mathbf{u}_i\in\mathbb{R}^d\) его два вектора, используемые в качестве вектора контекстного слова и центрального слова (в модели skip-gram их значения меняются местами) соответственно. Условная вероятность генерации любого центрального слова \(w_c\) (с индексом \(c\) в словаре) при заданных окружающих его контекстных словах \(w_{o_1}, \ldots, w_{o_{2m}}\) (с индексами \(o_1, \ldots, o_{2m}\) в словаре) может быть смоделирована следующим образом:
Для краткости обозначим \(\mathcal{W}_o= \{w_{o_1}, \ldots, w_{o_{2m}}\}\) и \(\bar{\mathbf{v}}_o = \left(\mathbf{v}_{o_1} + \ldots + \mathbf{v}_{o_{2m}} \right)/(2m)\). Тогда (15.1.10) можно упростить до
Рассмотрим текстовую последовательность длины \(T\), где слово на шаге времени \(t\) обозначается как \(w^{(t)}\). Для размера контекстного окна \(m\) функция правдоподобия модели непрерывного мешка слов представляет собой вероятность генерации всех центральных слов при заданных словах контекста:
15.1.4.1. Обучение
Обучение моделей непрерывного мешка слов (CBOW) практически не отличается от обучения моделей skip-gram. Метод максимального правдоподобия для модели непрерывного мешка слов эквивалентен минимизации следующей функции потерь:
Заметим, что
Дифференцированием мы можем получить его градиент по любому вектору контекстного слова \(\mathbf{v}_{o_i}\)(\(i = 1, \ldots, 2m\)) в виде
Градиенты для остальных векторов слов можно получить аналогичным образом. В отличие от модели skip-gram, модель непрерывного мешка слов (CBOW) обычно использует векторы контекстных слов в качестве представлений слов.
15.1.5. Итоги
Векторы слов — это векторы, используемые для представления слов, которые также можно рассматривать как векторы признаков или представления слов. Техника отображения слов в вещественные векторы называется эмбеддингом слов.
Инструмент word2vec содержит как модель skip-gram, так и модель непрерывного мешка слов (continuous bag of words).
Модель skip-gram предполагает, что слово может использоваться для генерации окружающих его слов в текстовой последовательности, тогда как модель continuous bag of words предполагает, что центральное слово генерируется на основе окружающих его контекстных слов.
15.1.6. Упражнения
Какова вычислительная сложность вычисления каждого градиента? Какие могут возникнуть проблемы, если размер словаря огромен?
Некоторые устойчивые словосочетания в английском языке состоят из нескольких слов, например «new york». Как обучать их векторные представления? Подсказка: см. раздел 4 в статье word2vec (Mikolov et al., 2013).
Давайте проанализируем архитектуру word2vec на примере модели skip-gram. Какова связь между скалярным произведением двух векторов слов в модели skip-gram и косинусным сходством? Почему для пары слов с близким значением косинусное сходство их векторов (обученных с помощью модели skip-gram) может быть высоким?