
22.10. Статистика
Безусловно, чтобы стать ведущим специалистом в области глубокого обучения, умение обучать современные модели с высокой точностью имеет решающее значение. Однако зачастую неясно, являются ли улучшения значимыми или же они лишь результатом случайных колебаний в процессе обучения. Чтобы иметь возможность обсуждать неопределённость в оценках значений, нам необходимо изучить некоторые разделы статистики.
Первое упоминание статистики относится к арабскому учёному Аль-Кинди в \(9^{\textrm{th}}\) веке, который подробно описал, как использовать статистику и частотный анализ для расшифровки зашифрованных сообщений. Спустя 800 лет в Германии в XVIII веке возникла современная статистика, когда исследователи сосредоточились на сборе и анализе демографических и экономических данных. Сегодня статистика — это научная дисциплина, занимающаяся сбором, обработкой, анализом, интерпретацией и визуализацией данных. Более того, основные теоретические положения статистики широко применяются в исследованиях в академической среде, промышленности и государственном управлении.
Более конкретно, статистику можно разделить на описательную статистику и статистический вывод. Первая занимается обобщением и визуализацией характеристик набора наблюдаемых данных, который называется примером. Пример выбирается из генеральной совокупности, которая представляет собой полный набор схожих объектов, элементов или событий, представляющих интерес для нашего эксперимента. В отличие от описательной статистики, статистический вывод позволяет делать выводы о характеристиках генеральной совокупности на основе имеющихся примеров, исходя из предположения, что распределение примера в определённой степени воспроизводит распределение генеральной совокупности.
Возникает вопрос: «В чем заключается фундаментальное различие между машинным обучением и статистикой?» По своей сути статистика сосредоточена на проблеме вывода. К таким задачам относятся моделирование взаимосвязей между переменными, например, каузальный вывод, а также проверка статистической значимости параметров модели, как, например, в A/B-тестировании. В отличие от этого, машинное обучение делает акцент на получении точных прогнозов, без явного программирования и понимания функциональности каждого параметра.
В этом разделе мы рассмотрим три типа методов статистического вывода: оценку и сравнение оценок, проверку гипотез и построение доверительных интервалов. Эти методы позволяют нам делать выводы о характеристиках заданной генеральной совокупности, то есть о истинном параметре \(\theta\). Для краткости мы предполагаем, что истинный параметр \(\theta\) заданной генеральной совокупности является скалярным значением. Легко обобщить этот случай на тот, когда \(\theta\) является вектором или тензором, поэтому мы опустим его рассмотрение.
22.10.1. Оценка и сравнение оценщиков
В статистике оценчик — это функция от заданных выборок, используемая для оценки истинного параметра \(\theta\). Мы будем обозначать \(\hat{\theta}_n = \hat{f}(x_1, \ldots, x_n)\) оценку \(\theta\) после наблюдения выборок {\(x_1, x_2, \ldots, x_n\)}.
Простые примеры оценщиков мы уже рассматривали в разделе Section 22.7. Если у нас есть набор выборок из бернуллиевской случайной величины, то оценку максимального правдоподобия вероятности того, что случайная величина равна единице, можно получить, подсчитав количество единиц и разделив его на общее число выборок. Аналогично, в одном из упражнений требовалось показать, что оценка максимального правдоподобия математического ожидания гауссовского распределения, полученная по набору выборок, равна среднему значению всех выборок. Эти оценщики почти никогда не дают истинного значения параметра, но в идеале при большом числе выборок оценка должна быть близка к нему.
В качестве примера ниже показана истинная плотность гауссовской случайной величины со средним нуль и дисперсией единица, а также набор выборок из этого распределения. Мы построили \(y\) координаты так, чтобы каждая точка была видна и связь с исходной плотностью была более очевидной.
import torch
from d2l import torch as d2l

torch.pi = torch.acos(torch.zeros(1)) * 2  #define pi in torch

# Sample datapoints and create y coordinate
epsilon = 0.1
torch.manual_seed(8675309)
xs = torch.randn(size=(300,))

ys = torch.tensor(
    [torch.sum(torch.exp(-(xs[:i] - xs[i])**2 / (2 * epsilon**2))\
               / torch.sqrt(2*torch.pi*epsilon**2)) / len(xs)\
     for i in range(len(xs))])

# Compute true density
xd = torch.arange(torch.min(xs), torch.max(xs), 0.01)
yd = torch.exp(-xd**2/2) / torch.sqrt(2 * torch.pi)

# Plot the results
d2l.plot(xd, yd, 'x', 'density')
d2l.plt.scatter(xs, ys)
d2l.plt.axvline(x=0)
d2l.plt.axvline(x=torch.mean(xs), linestyle='--', color='purple')
d2l.plt.title(f'sample mean: {float(torch.mean(xs).item()):.2f}')
d2l.plt.show()
Существует множество способов вычисления оценки параметра \(\hat{\theta}_n\). В этом разделе мы рассмотрим три распространенных метода оценки и сравнения оценок: среднеквадратичную ошибку, стандартное отклонение и статистическое смещение.
22.10.1.1. Среднеквадратичная ошибка
Возможно, самой простой метрикой, используемой для оценки оценщиков, является среднеквадратичная ошибка (MSE) (или \(l_2\) потеря), которую можно определить как
Это позволяет нам количественно оценить среднее квадратичное отклонение от истинного значения. MSE всегда неотрицательно. Если вы читали Section 3.1, вы узнаете в нём наиболее часто используемую функцию потерь для регрессии. В качестве меры оценки оценщика, чем ближе его значение к нулю, тем ближе оценщик к истинному параметру \(\theta\).
22.10.1.2. Статистическое смещение
Среднеквадратичная ошибка (MSE) предоставляет естественную метрику, но мы можем легко представить множество различных явлений, способных привести к её значительному росту. Два фундаментально важных из них — это колебания оценки из-за случайности в наборе данных и систематическая ошибка оценки, обусловленная процедурой оценивания.
Сначала измерим систематическую ошибку. Для оценщика \(\hat{\theta}_n\) математическое определение статистического смещения можно задать как
Обратите внимание, что когда \(\textrm{bias}(\hat{\theta}_n) = 0\), математическое ожидание оценки \(\hat{\theta}_n\) равно истинному значению параметра. В этом случае мы говорим, что \(\hat{\theta}_n\) является несмещённой оценкой. В общем случае несмещённая оценка лучше смещённой, поскольку её математическое ожидание совпадает с истинным значением параметра.
Однако стоит иметь в виду, что на практике часто используются смещённые оценщики. Существуют случаи, когда несмещённые оценщики не существуют без дополнительных предположений или их вычисление затруднительно. Это может показаться существенным недостатком оценщика, однако большинство оценщиков, с которыми мы сталкиваемся на практике, являются хотя бы асимптотически несмещёнными, то есть смещение стремится к нулю по мере увеличения числа доступных выборок до бесконечности: \(\lim_{n \rightarrow \infty} \textrm{bias}(\hat{\theta}_n) = 0\).
22.10.1.3. Дисперсия и стандартное отклонение
Во-вторых, давайте оценим случайность в оценщике. Как мы помним из Section 22.6, стандартное отклонение (или стандартная ошибка) определяется как квадратный корень из дисперсии. Степень колебаний оценщика можно измерить, вычислив его стандартное отклонение или дисперсию.
Важно сравнить (22.10.3) с (22.10.1). В этом уравнении мы сравниваем не с истинным значением генеральной совокупности \(\theta\), а с \(E(\hat{\theta}_n)\), то есть с математическим ожиданием выборочного среднего. Таким образом, мы измеряем не то, насколько далеко оценщик обычно отстоит от истинного значения, а колебания самого оценщика.
22.10.1.4. Компромисс между смещением и дисперсией
Интуитивно ясно, что эти две основные компоненты влияют на среднеквадратичную ошибку. Однако несколько удивительно то, что мы можем показать, что это на самом деле является разложением среднеквадратичной ошибки на эти две составляющие плюс третью. То есть мы можем записать среднеквадратичную ошибку как сумму квадрата смещения, дисперсии и неустранимой ошибки.
Рассмотренную выше формулу называют компромиссом между смещением и дисперсией. Среднеквадратичная ошибка может быть разложена на три составляющие: ошибку из-за высокого смещения, ошибку из-за высокой дисперсии и неустранимую ошибку. Ошибка, обусловленная смещением, характерна для простых моделей (например, линейной регрессии), которые не способны выявлять сложные зависимости между признаками и целевыми значениями. Если модель страдает от высокого смещения, говорят, что она недообучена или обладает недостаточной гибкостью, как было описано в (Section 3.6). Высокая дисперсия обычно возникает из-за слишком сложной модели, которая переобучается на обучающих данных. В результате переобученная модель чувствительна к небольшим колебаниям в данных. Если модель страдает от высокой дисперсии, говорят, что она переобучена и обладает недостаточной обобщающей способностью, как было описано в (Section 3.6). Неустранимая ошибка обусловлена наличием шума в самих данных \(\theta\).
22.10.1.5. Оценка оценщиков в коде
Поскольку стандартное отклонение оценщика вычисляется простым вызовом
a.std() для тензора a, мы пропустим его реализацию и
сосредоточимся на статистическом смещении и среднеквадратичной ошибке.
# Statistical bias
def stat_bias(true_theta, est_theta):
    return(torch.mean(est_theta) - true_theta)

# Mean squared error
def mse(data, true_theta):
    return(torch.mean(torch.square(data - true_theta)))
Чтобы проиллюстрировать уравнение компромисса между смещением и дисперсией, сымитируем нормальное распределение \(\mathcal{N}(\theta, \sigma^2)\), используя \(10,000\) выборок. Здесь мы применяем параметры \(\theta = 1\) и \(\sigma = 4\). Поскольку оценчик представляет собой функцию от заданных выборок, в качестве оценки истинного значения \(\theta\) в данном нормальном распределении \(\mathcal{N}(\theta, \sigma^2)\) мы используем выборочное среднее.
theta_true = 1
sigma = 4
sample_len = 10000
samples = torch.normal(theta_true, sigma, size=(sample_len, 1))
theta_est = torch.mean(samples)
theta_est
Давайте проверим уравнение компромисса, вычислив сумму квадратов смещения и дисперсии нашего оценщика. Сначала рассчитаем среднеквадратичную ошибку (MSE) нашего оценщика.
mse(samples, theta_true)
Далее мы вычисляем \(\textrm{Var} (\hat{\theta}_n) + [\textrm{bias} (\hat{\theta}_n)]^2\) следующим образом. Как видно, два значения совпадают с точностью до численной точности.
bias = stat_bias(theta_true, theta_est)
torch.square(samples.std(unbiased=False)) + torch.square(bias)
22.10.2. Проведение статистических проверок
Наиболее часто встречающейся темой в статистическом выводе является проверка гипотез. Хотя проверка гипотез получила широкое распространение в начале \(20^{th}\) века, её первое применение можно проследить до Джона Арбута в XVIII веке. Джон проанализировал 80-летние записи о рождении в Лондоне и пришёл к выводу, что ежегодно рождается больше мальчиков, чем девочек. Впоследствии современное тестирование значимости стало интеллектуальным наследием Карла Пирсона, который ввёл понятие \(p\)-значения и тест хи-квадрат Пирсона, Уильяма Госсета, которого называют отцом t-распределения Стьюдента, и Рональда Фишера, заложившего основы нулевой гипотезы и теста значимости.
Проверка гипотез — это способ оценки доказательств против утверждения по умолчанию о генеральной совокупности. Мы называем это утверждение по умолчанию нулевой гипотезой \(H_0\), которую пытаемся опровергнуть с помощью наблюдаемых данных. Здесь мы используем \(H_0\) в качестве отправной точки для проверки статистической значимости. Альтернативная гипотеза \(H_A\) (или \(H_1\)) — это утверждение, противоречащее нулевой гипотезе. Нулевая гипотеза часто формулируется в утвердительной форме, предполагающей наличие взаимосвязи между переменными. Она должна отражать суть максимально явно и быть проверяемой средствами статистической теории.
Представьте, что вы химик. Проведя тысячи часов в лаборатории, вы разработали новое лекарство, способное значительно улучшить способность человека понимать математику. Чтобы продемонстрировать его чудодейственную силу, необходимо провести испытание. Для этого вам понадобятся добровольцы, которые примут лекарство и позволят проверить, помогает ли оно им лучше усваивать математику. С чего начать?
Во-первых, вам потребуется тщательно и случайным образом отобрать две группы добровольцев так, чтобы между ними не было различий в способности к математическому мышлению, измеряемой с помощью определённых метрик. Эти две группы обычно называются тестовой и контрольной группами. Тестовая группа (или группа воздействия) — это группа людей, которые будут принимать лекарство, тогда как контрольная группа представляет собой группу пользователей, выделенную в качестве бенчмарка, то есть в идентичных условиях, за исключением приёма этого лекарства. Таким образом, влияние всех переменных минимизируется, за исключением воздействия независимой переменной в эксперименте.
Во-вторых, по истечении периода приёма лекарства необходимо измерить уровень понимания математики в обеих группах с помощью одних и тех же метрик, например, предложив добровольцам выполнить одинаковые тесты после изучения новой математической формулы. Затем можно собрать данные об их результатах и сравнить их. В данном случае наша нулевая гипотеза заключается в том, что между двумя группами нет различий, а альтернативная — в том, что они есть.
Это всё ещё не совсем формально. Есть много деталей, о которых нужно подумать внимательно. Например, какие метрики подходят для проверки понимания математики? Сколько добровольцев нужно для вашего теста, чтобы вы могли с уверенностью утверждать об эффективности вашего лекарства? Как долго вы должны проводить тест? Как вы решаете, есть ли разница между двумя группами? Вас интересует только средняя производительность или также диапазон вариации оценок? И так далее.
Таким образом, проверка гипотез обеспечивает фреймворк для планирования экспериментов и оценки достоверности наблюдаемых результатов. Если мы можем показать, что нулевая гипотеза крайне маловероятна, мы можем уверенно её отвергнуть.
Чтобы завершить рассказ о том, как проводить проверку гипотез, нам необходимо ввести дополнительную терминологию и формализовать некоторые из рассмотренных выше понятий.
22.10.2.1. Статистическая значимость
Статистическая значимость измеряет вероятность ошибочного отклонения нулевой гипотезы, \(H_0\), когда её не следует отклонять, то есть
Это также называется ошибкой первого рода или ложноположительным результатом. \(\alpha\) называется уровнем значимости, а его наиболее часто используемое значение равно \(5\%\), то есть \(1-\alpha = 95\%\). Уровень значимости можно объяснить как уровень риска, на который мы готовы пойти, отвергая верную нулевую гипотезу.
Fig. 22.10.1 показывает значения наблюдений и вероятность заданного нормального распределения в двухвыборочной проверке гипотез. Если пример наблюдательных данных находится вне порога \(95\%\), то при условии справедливости нулевой гипотезы такое наблюдение будет крайне маловероятным. Следовательно, возможно, нулевая гипотеза неверна, и мы её отвергаем.
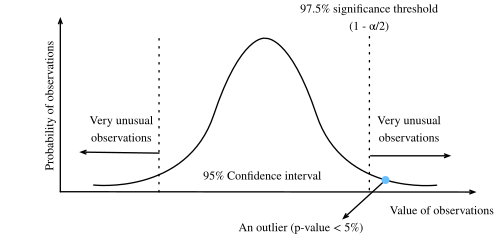
Fig. 22.10.1 Статистическая значимость.
22.10.2.2. Статистическая мощность
Статистическая мощность (или чувствительность) измеряет вероятность отклонения нулевой гипотезы \(H_0\), когда её следует отклонить, то есть
Напомним, что ошибка первого рода — это ошибка, возникающая при отклонении нулевой гипотезы, когда она верна, тогда как ошибка второго рода возникает при неспособности отвергнуть нулевую гипотезу, когда она ложна. Ошибка второго рода обычно обозначается как \(\beta\), а соответствующая статистическая мощность — как \(1-\beta\).
Интуитивно статистическую мощность можно понимать как вероятность того, что наш тест обнаружит реальное расхождение заданной минимальной величины при выбранном уровне статистической значимости. \(80\%\) — часто используемый порог статистической мощности. Чем выше статистическая мощность, тем выше вероятность обнаружения истинных различий.
Одним из наиболее распространенных применений статистической мощности является определение необходимого числа примеров. Вероятность отклонить нулевую гипотезу, когда она ложна, зависит от степени её ложности (известной как размер эффекта) и от числа имеющихся у нас примеров. Как и следовало ожидать, малые размеры эффекта потребуют очень большого числа примеров, чтобы их можно было обнаружить с высокой вероятностью. Хотя детальный вывод выходит за рамки этого краткого приложения, в качестве примера: если мы хотим иметь возможность отклонить нулевую гипотезу о том, что наш пример получен из гауссовского распределения с нулевым средним и единичной дисперсией, и мы полагаем, что истинное среднее нашего примера близко к единице, то мы можем сделать это с приёмлемыми уровнями ошибок при размере выборки всего \(8\). Однако, если мы считаем, что истинное среднее генеральной совокупности нашего примера близко к \(0.01\), то нам потребуется размер выборки, близкий к \(80000\), чтобы обнаружить это различие.
Мы можем представить мощность как фильтр воды. В этой аналогии тест гипотезы с высокой мощностью подобен высококачественной системе фильтрации воды, которая максимально снижает содержание вредных веществ. С другой стороны, малое расхождение подобно фильтру низкого качества, через который некоторые относительно мелкие частицы могут легко просачиваться сквозь щели. Аналогично, если статистическая мощность недостаточна, тест может не выявить небольшие расхождения.
22.10.2.3. Статистика критерия
Тестовая статистика \(T(x)\) — это скаляр, обобщающий определённую характеристику выборки. Цель введения такой статистики заключается в том, чтобы она позволяла нам различать различные распределения и проводить проверку гипотез. Вспоминая пример с химиком, если мы хотим показать, что одна популяция демонстрирует лучшие результаты, чем другая, в качестве тестовой статистики может быть разумно использовать среднее значение. Различные выбор тестовой статистики могут приводить к статистическим тестам с существенно разной статистической мощностью.
Часто \(T(X)\) (распределение статистики критерия при справедливости нулевой гипотезы) приблизительно следует одному из распространённых распределений вероятностей, например нормальному распределению. Если мы можем явно вывести такое распределение, а затем вычислить значение статистики критерия на нашем наборе данных, мы можем обоснованно отвергнуть нулевую гипотезу, если значение статистики значительно выходит за пределы ожидаемого диапазона. Переход к количественной оценке приводит нас к понятию \(p\)-значений.
22.10.2.4. \(p\)-значение
Значение \(p\) (или вероятностное значение) — это вероятность того, что \(T(X)\) будет как минимум столь же экстремальным, как наблюдаемое значение статистики теста \(T(x)\), при условии, что нулевая гипотеза верна, то есть
Если \(p\)-значение меньше или равно заранее заданному фиксированному уровню статистической значимости \(\alpha\), мы можем отвергнуть нулевую гипотезу. В противном случае мы делаем вывод, что у нас недостаточно доказательств для отвержения нулевой гипотезы. Для заданного распределения популяции область отвержения представляет собой интервал, содержащий все точки, для которых \(p\)-значение меньше уровня статистической значимости \(\alpha\).
22.10.2.5. Односторонний и двусторонний тесты
Обычно выделяют два вида тестов значимости: односторонний тест и двусторонний тест. Односторонний тест (или односторонний критерий) применяется, когда нулевая и альтернативная гипотезы задают только одно направление. Например, нулевая гипотеза может утверждать, что истинный параметр \(\theta\) меньше или равен значению \(c\). Альтернативная гипотеза будет заключаться в том, что \(\theta\) больше \(c\). То есть область отклонения находится только с одной стороны от выборочного распределения. В отличие от одностороннего теста, двусторонний тест (или двусторонний критерий) применяется, когда область отклонения находится с обеих сторон выборочного распределения. Примером в этом случае может служить нулевая гипотеза, утверждающая, что истинный параметр \(\theta\) равен значению \(c\). Альтернативная гипотеза будет заключаться в том, что \(\theta\) не равно \(c\).
22.10.2.6. Общие шаги проверки гипотез
После знакомства с вышеуказанными понятиями рассмотрим общие шаги проверки гипотез.
Сформулируйте вопрос и определите нулевую гипотезу \(H_0\).
Установите уровень статистической значимости \(\alpha\) и статистическую мощность \(1 - \beta\).
Получите выборки в ходе экспериментов. Необходимое количество выборок зависит от статистической мощности и ожидаемого размера эффекта.
Вычислите статистический критерий и \(p\)-значение.
Примите решение о сохранении или отклонении нулевой гипотезы на основе \(p\)-значения и уровня статистической значимости \(\alpha\).
Для проведения проверки гипотезы сначала формулируется нулевая гипотеза и уровень риска, на который мы готовы пойти. Затем вычисляется статистика критерия для примера, при этом экстремальное значение статистики критерия рассматривается как доказательство против нулевой гипотезы. Если статистика критерия попадает в область отклонения, нулевую гипотезу можно отклонить в пользу альтернативной.
Тестирование гипотез применимо в различных сценариях, таких как клинические испытания и A/B-тестирование.
22.10.3. Построение доверительных интервалов
При оценке значения параметра \(\theta\) точечные оценители, такие как \(\hat \theta\), имеют ограниченную полезность, поскольку они не отражают неопределенность. Гораздо лучше было бы, если бы мы могли получить интервал, который с высокой вероятностью содержал бы истинное значение параметра \(\theta\). Если бы вас интересовали подобные идеи сто лет назад, вы бы с воодушевлением прочитали работу «Outline of a Theory of Statistical Estimation Based on the Classical Theory of Probability» Ежи Неймана (Neyman, 1937), который впервые ввел понятие доверительного интервала в 1937 году.
Чтобы доверительный интервал был полезен, он должен быть как можно уже при заданном уровне достоверности. Рассмотрим, как его вывести.
22.10.3.1. Определение
Математически доверительный интервал для истинного параметра \(\theta\) — это интервал \(C_n\), вычисляемый по данным выборки таким образом, что
Здесь \(\alpha \in (0, 1)\), а \(1 - \alpha\) называется доверительным уровнем или покрытием интервала. Это то же самое \(\alpha\), что и уровень значимости, о котором говорилось выше.
Обратите внимание, что (22.10.8) относится к случайной величине \(C_n\), а не к фиксированному значению \(\theta\). Чтобы подчеркнуть это, мы используем обозначение \(P_{\theta} (C_n \ni \theta)\), а не \(P_{\theta} (\theta \in C_n)\).
22.10.3.2. Интерпретация
Очень соблазнительно интерпретировать доверительный интервал \(95\%\) как диапазон, в котором мы можем быть \(95\%\) уверены, что находится истинный параметр, однако, к сожалению, это не так. Истинный параметр фиксирован, а случайной величиной является интервал. Поэтому более корректная интерпретация заключается в следующем: если мы сгенерируем большое количество доверительных интервалов с помощью данной процедуры, \(95\%\) из них будут содержать истинный параметр.
Это может показаться педантичным, но это имеет реальные последствия для интерпретации результатов. В частности, мы можем удовлетворить условию (22.10.8), конструируя интервалы, в которых мы почти уверены, что истинное значение отсутствует, при условии, что делаем это достаточно редко. В завершение этого раздела мы приведем три соблазнительных, но ложных утверждения. Подробное обсуждение этих вопросов можно найти в Morey et al. (2016).
Заблуждение 1. Узкие доверительные интервалы означают, что мы можем точно оценить параметр.
** заблуждение 2. Значения внутри доверительного интервала с большей вероятностью являются истинным значением, чем значения вне этого интервала.
Ошибка 3. Вероятность того, что конкретный наблюдаемый \(95\%\) доверительный интервал содержит истинное значение, равна \(95\%\).
Достаточно сказать, что доверительные интервалы — объекты тонкие. Однако если чётко понимать их интерпретацию, они могут стать мощным инструментом.
22.10.3.3. Пример с гауссовым распределением
Рассмотрим самый классический пример — доверительный интервал для среднего значения нормального распределения с неизвестным средним и дисперсией. Предположим, мы собрали \(n\) выборок \(\{x_i\}_{i=1}^n\) из нашего нормального распределения \(\mathcal{N}(\mu, \sigma^2)\). Мы можем вычислить оценки для среднего и дисперсии, взяв
Если теперь мы рассмотрим случайную величину
мы получаем случайную величину, распределённую по хорошо известному закону, называемому студенческим t-распределением с \(n-1\) степенями свободы.
Это распределение хорошо изучено, и известно, например, что при \(n\rightarrow \infty\) оно приблизительно является стандартным гауссовским, поэтому, используя таблицу значений к.р.ф. Гаусса, мы можем заключить, что значение \(T\) попадает в интервал \([-1.96, 1.96]\) как минимум в \(95\%\) случаев. Для конечных значений \(n\) интервал должен быть несколько шире, но эти значения хорошо известны и заранее вычислены в таблицах.
Таким образом, мы можем заключить, что для больших \(n\),
Преобразовав это выражение, умножив обе части на \(\hat\sigma_n/\sqrt{n}\), а затем прибавив \(\hat\mu_n\), получим
Таким образом, мы знаем, что нашли наш \(95\%\) доверительный интервал:
Можно смело сказать, что (22.10.13) — одна из самых
часто используемых формул в статистике. Завершим наше обсуждение
статистики, реализовав её. Для простоты мы предполагаем, что находимся в
асимптотическом режиме. Малые значения \(N\) должны давать
правильное значение t_star, полученное либо программно, либо из
таблицы \(t\).
# PyTorch uses Bessel's correction by default, which means the use of ddof=1
# instead of default ddof=0 in numpy. We can use unbiased=False to imitate
# ddof=0.

# Number of samples
N = 1000

# Sample dataset
samples = torch.normal(0, 1, size=(N,))

# Lookup Students's t-distribution c.d.f.
t_star = 1.96

# Construct interval
mu_hat = torch.mean(samples)
sigma_hat = samples.std(unbiased=True)
(mu_hat - t_star*sigma_hat/torch.sqrt(torch.tensor(N, dtype=torch.float32)),\
 mu_hat + t_star*sigma_hat/torch.sqrt(torch.tensor(N, dtype=torch.float32)))
22.10.4. Итоги
Статистика фокусируется на задачах вывода, тогда как глубокое обучение делает акцент на получении точных прогнозов без явного программирования и понимания.
Существует три распространенных метода статистического вывода: оценка и сравнение оценщиков, проведение проверок гипотез и построение доверительных интервалов.
Существует три наиболее распространённых оценочные статистики: смещение, стандартное отклонение и среднеквадратичная ошибка.
Доверительный интервал — это оценочный диапазон истинного параметра генеральной совокупности, который мы можем построить по выборкам.
Проверка гипотез — это способ оценки некоторых доказательств против утверждения по умолчанию о популяции.
22.10.5. Упражнения
Пусть \(X_1, X_2, \ldots, X_n \overset{\textrm{iid}}{\sim} \textrm{Unif}(0, \theta)\), где «iid» означает независимые и одинаково распределённые. Рассмотрим следующие оценки для \(\theta\):
(22.10.14)¶\[\hat{\theta} = \max \{X_1, X_2, \ldots, X_n \};\](22.10.15)¶\[\tilde{\theta} = 2 \bar{X_n} = \frac{2}{n} \sum_{i=1}^n X_i.\]Найдите статистическое смещение, стандартное отклонение и среднеквадратичную ошибку для \(\hat{\theta}.\)
Найдите статистическое смещение, стандартное отклонение и среднеквадратичную ошибку для \(\tilde{\theta}.\)
Какой оценщик лучше?
Возьмем пример с химиком из введения. Можете ли вы вывести 5 шагов для проведения двусторонней проверки гипотезы, учитывая уровень статистической значимости \(\alpha = 0.05\) и статистическую мощность \(1 - \beta = 0.8\)?
Запустите код для вычисления доверительного интервала с \(N=2\) и \(\alpha = 0.5\) для \(100\) независимо сгенерированных наборов данных и постройте полученные интервалы (в данном случае
t_star = 1.0). Вы увидите несколько очень коротких интервалов, которые сильно отстоят от истинного среднего значения \(0\). Не противоречит ли это интерпретации доверительного интервала? Считаете ли вы приёмлемым использование коротких интервалов для указания высокой точности оценок?