
5.3. Прямое распространение, обратное распространение и вычислительные графы
До сих пор мы обучали наши модели с помощью стохастического градиентного спуска на мини-батчах. Однако при реализации алгоритма мы занимались только вычислениями, необходимыми для прямого распространения через модель. Когда же пришло время вычислять градиенты, мы просто вызывали функцию обратного распространения ошибки, предоставляемую фреймворком глубокого обучения.
Автоматическое вычисление градиентов существенно упрощает реализацию алгоритмов глубокого обучения. До появления автоматического дифференцирования даже незначительные изменения в сложных моделях требовали ручного пересчёта сложных производных. Удивительно часто в научных статьях приходилось выделять множество страниц для вывода правил обновления. Хотя нам по-прежнему приходится полагаться на автоматическое дифференцирование, чтобы сосредоточиться на наиболее интересных аспектах, вам следует понимать, как именно вычисляются эти градиенты «под капотом», если вы стремитесь к глубокому пониманию глубокого обучения.
В этом разделе мы подробно разберем детали обратного распространения ошибки (чаще называемого backpropagation). Чтобы пролить свет на суть методов и их реализацию, мы опираемся на базовую математику и вычислительные графы. Для начала мы сосредоточимся на многослойном перцептроне с одним скрытым слоем и затуханием весов (\(\ell_2\) регуляризация, которая будет описана в последующих главах).
5.3.1. Прямое распространение
Прямое распространение (или прямой проход) — это вычисление и хранение промежуточных переменных (включая выходные данные) для нейронной сети в порядке от входного слоя к выходному. Теперь мы пошагово разберем механику работы нейронной сети с одним скрытым слоем. Это может показаться утомительным, но, как говорил виртуоз фанка Джеймс Браун, «нужно заплатить цену, чтобы стать боссом».
Для простоты предположим, что входной пример равен \(\mathbf{x}\in \mathbb{R}^d\) и что наш скрытый слой не содержит смещения. В этом случае промежуточная переменная равна:
где \(\mathbf{W}^{(1)} \in \mathbb{R}^{h \times d}\) — параметр весов скрытого слоя. После прохождения промежуточной переменной \(\mathbf{z}\in \mathbb{R}^h\) через функцию активации \(\phi\) мы получаем вектор скрытой активации длины \(h\):
Выход скрытого слоя \(\mathbf{h}\) также является промежуточной переменной. Предполагая, что параметры выходного слоя содержат только вес \(\mathbf{W}^{(2)} \in \mathbb{R}^{q \times h}\), мы можем получить переменную выходного слоя — вектор длины \(q\):
Предположим, что функция потерь равна \(l\), а метка примера — \(y\). Тогда мы можем вычислить значение функции потерь для одного примера данных,
Как мы увидим при определении \(\ell_2\) регуляризации, которое будет введено позже, при заданном гиперпараметре \(\lambda\) член регуляризации равен
где норма Фробениуса матрицы — это просто \(\ell_2\)-норма, примененная после сведения матрицы к вектору. Наконец, регуляризованная функция потерь модели для данного примера данных равна:
В дальнейшем мы будем называть \(J\) целевой функцией.
5.3.2. Вычислительный график прямого распространения
Построение вычислительных графов помогает визуализировать зависимости между операторами и переменными в ходе вычислений. Fig. 5.3.1 содержит граф, соответствующий описанной выше простой сети, где квадраты обозначают переменные, а круги — операторы. Нижний левый угол соответствует входу, а верхний правый — выходу. Обратите внимание, что стрелки (иллюстрирующие поток данных) направлены преимущественно вправо и вверх.
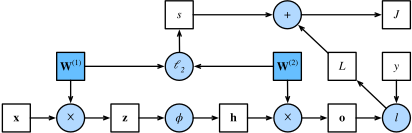
Fig. 5.3.1 Вычислительный график прямого распространения.
5.3.3. Обратное распространение ошибки
Обратное распространение ошибки — это метод вычисления градиента параметров нейронной сети. Если говорить кратко, метод проходит по сети в обратном порядке, от выходного слоя к входному, используя цепное правило из математического анализа. Алгоритм сохраняет все промежуточные переменные (частные производные), необходимые для вычисления градиента по отношению к некоторым параметрам. Предположим, у нас есть функции \(\mathsf{Y}=f(\mathsf{X})\) и \(\mathsf{Z}=g(\mathsf{Y})\), в которых входные и выходные данные \(\mathsf{X}, \mathsf{Y}, \mathsf{Z}\) являются тензорами произвольных форм. Используя цепное правило, мы можем вычислить производную \(\mathsf{Z}\) по \(\mathsf{X}\) через
Здесь мы используем оператор \(\textrm{prod}\) для умножения его аргументов после выполнения необходимых операций, таких как транспонирование и перестановка позиций входных данных. Для векторов это просто матричное умножение. Для тензоров более высокой размерности мы используем соответствующий аналог. Оператор \(\textrm{prod}\) скрывает все нотационные накладные расходы.
Напомним, что параметрами простой сети с одним скрытым слоем, граф вычислений которой показан в Fig. 5.3.1, являются \(\mathbf{W}^{(1)}\) и \(\mathbf{W}^{(2)}\). Цель обратного распространения ошибки — вычислить градиенты \(\partial J/\partial \mathbf{W}^{(1)}\) и \(\partial J/\partial \mathbf{W}^{(2)}\). Для этого мы применяем цепное правило и последовательно вычисляем градиенты каждой промежуточной переменной и параметра. Порядок вычислений обратен по сравнению с тем, что выполняется при прямом распространении, поскольку нам необходимо начать с результата графа вычислений и двигаться в сторону параметров. Первый шаг заключается в вычислении градиентов целевой функции \(J=L+s\) по члену потерь \(L\) и члену регуляризации \(s\):
Далее мы вычисляем градиент целевой функции по переменной выходного слоя \(\mathbf{o}\) в соответствии с цепным правилом:
Далее мы вычисляем градиенты члена регуляризации по обоим параметрам:
Теперь мы можем вычислить градиент \(\partial J/\partial \mathbf{W}^{(2)} \in \mathbb{R}^{q \times h}\) параметров модели, ближайших к выходному слою. Применение цепного правила даёт:
Чтобы получить градиент по \(\mathbf{W}^{(1)}\), необходимо продолжить обратное распространение ошибки от выходного слоя к скрытому слою. Градиент по выходу скрытого слоя \(\partial J/\partial \mathbf{h} \in \mathbb{R}^h\) определяется как
Поскольку функция активации \(\phi\) применяется поэлементно, вычисление градиента \(\partial J/\partial \mathbf{z} \in \mathbb{R}^h\) промежуточной переменной \(\mathbf{z}\) требует использования оператора поэлементного умножения, который мы обозначаем как \(\odot\):
Наконец, мы можем вычислить градиент \(\partial J/\partial \mathbf{W}^{(1)} \in \mathbb{R}^{h \times d}\) параметров модели, ближайших к входному слою. Согласно цепному правилу, получаем
5.3.4. Обучение нейронных сетей
При обучении нейронных сетей прямое и обратное распространение зависят друг от друга. В частности, при прямом распространении мы обходим граф вычислений в направлении зависимостей и вычисляем все переменные на этом пути. Затем эти значения используются при обратном распространении ошибки, где порядок вычислений на графе меняется на противоположный.
Рассмотрим в качестве иллюстративного примера упомянутую выше простую сеть. С одной стороны, вычисление члена регуляризации (5.3.5) при прямом распространении зависит от текущих значений параметров модели \(\mathbf{W}^{(1)}\) и \(\mathbf{W}^{(2)}\). Они задаются алгоритмом оптимизации на основе обратного распространения ошибки в последней итерации. С другой стороны, вычисление градиента для параметра (5.3.11) при обратном распространении ошибки зависит от текущего значения выхода скрытого слоя \(\mathbf{h}\), которое определяется прямым распространением.
Поэтому при обучении нейронных сетей, после инициализации параметров модели, мы чередуем прямое распространение и обратное распространение ошибки, обновляя параметры модели с помощью градиентов, вычисленных в ходе обратного распространения ошибки. Обратите внимание, что обратное распространение ошибки повторно использует сохранённые промежуточные значения из прямого распространения, чтобы избежать дублирования вычислений. Одним из следствий этого является необходимость сохранять промежуточные значения до завершения обратного распространения ошибки. Это также одна из причин, почему обучение требует значительно больше памяти, чем обычное предсказание. Кроме того, объём таких промежуточных значений примерно пропорционален количеству слоёв сети и размеру батча. Таким образом, обучение более глубоких сетей с использованием больших размеров батча чаще приводит к ошибкам нехватки памяти (out-of-memory).
5.3.5. Итог
Прямое распространение последовательно вычисляет и сохраняет промежуточные переменные в вычислительном графе, определяемом нейронной сетью. Процесс идет от входного слоя к выходному. Обратное распространение ошибки последовательно вычисляет и сохраняет градиенты промежуточных переменных и параметров нейронной сети в обратном порядке. При обучении моделей глубокого обучения прямое распространение и обратное распространение ошибки взаимозависимы, поэтому для обучения требуется значительно больше памяти, чем для предсказания.
5.3.6. Упражнения
Предположим, что входные данные \(\mathbf{X}\) некоторой скалярной функции \(f\) являются матрицами размера \(n \times m\). Какова размерность градиента \(f\) по \(\mathbf{X}\)?
Добавьте смещение в скрытый слой модели, описанной в этом разделе (не нужно включать смещение в член регуляризации).
Постройте соответствующий вычислительный граф.
Выведите уравнения прямого и обратного распространения.
Вычислите объём памяти, необходимый для обучения и предсказания в модели, описанной в этом разделе.
Предположим, вам нужно вычислить вторые производные. Что произойдет с вычислительным графом? Сколько времени, по вашему мнению, займет вычисление?
Предположим, что вычислительный граф слишком велик для вашей видеокарты.
Можно ли разделить его между несколькими GPU?
Каковы преимущества и недостатки по сравнению с обучением на меньшем мини-батче?