
16. Обработка естественного языка: приложения
В главе Section 15 мы рассмотрели, как представлять токены в текстовых последовательностях и обучать их представления. Такие предварительно обученные текстовые представления можно использовать в различных моделях для решения широкого спектра задач обработки естественного языка.
На самом деле в предыдущих главах мы уже обсуждали некоторые задачи обработки естественного языка без предобучения лишь для того, чтобы объяснить архитектуры глубокого обучения. Например, в Section 9 мы использовали рекуррентные нейронные сети для создания языковых моделей, генерирующих текст, похожий на новеллу. В Section 10 и Section 11 мы также проектировали модели на основе рекуррентных нейронных сетей и механизмов внимания для машинного перевода.
Однако эта книга не ставит целью всесторонне охватить все подобные приложения. Вместо этого мы сосредотачиваемся на том, как применять (глубокое) обучение представлений языка для решения задач обработки естественного языка. Имея предобученные текстовые представления, в этой главе мы рассмотрим два популярных и репрезентативных приложения обработки естественного языка: анализ тональности и логический вывод на основе текста, которые, соответственно, анализируют отдельные тексты и отношения между парами текстов.
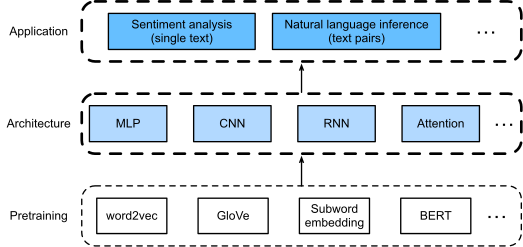
Fig. 16.1 Предобученные текстовые представления можно подавать на вход различным архитектурам глубокого обучения для решения различных задач обработки естественного языка. В этой главе рассматривается, как проектировать модели для различных задач обработки естественного языка.
Как показано на рисунке Fig. 16.1, в этой главе описываются основные идеи проектирования моделей обработки естественного языка с использованием различных архитектур глубокого обучения, таких как многослойные перцептроны (MLP), свёрточные нейронные сети (CNN), рекуррентные нейронные сети (RNN) и механизмы внимания. Хотя любые предобученные текстовые представления можно комбинировать с любой архитектурой для любого из приложений, рассмотренных в Fig. 16.1, мы выберем несколько репрезентативных комбинаций. В частности, мы исследуем популярные архитектуры на основе RNN и CNN для анализа тональности. Для естественного логического вывода мы используем механизмы внимания и MLP, чтобы продемонстрировать анализ пар текстов. В завершение мы рассмотрим, как дообучать предобученную модель BERT для широкого спектра задач обработки естественного языка, как на уровне последовательности (классификация одиночного текста и классификация пары текстов), так и на уровне токенов (тегирование текста и ответ на вопросы). В качестве конкретного эмпирического примера мы выполним дообучение BERT для естественного логического вывода.
Как мы уже упоминали в Section 15.8, BERT требует минимальных изменений архитектуры для широкого спектра задач обработки естественного языка. Однако это преимущество достигается ценой дообучения огромного числа параметров BERT для конкретных прикладных задач. В условиях ограничений по объёму памяти или времени более целесообразными оказываются специализированные модели, основанные на многослойных перцептронах (MLP), свёрточных нейронных сетях (CNN), рекуррентных нейронных сетях (RNN) и механизмах внимания. Далее мы начнем с задачи анализа тональности и рассмотрим проектирование моделей на основе RNN и CNN соответственно.
- 16.1. Анализ тональности и набор данных
- 16.2. Анализ тональности: использование рекуррентных нейронных сетей
- 16.3. Анализ тональности: использование свёрточных нейронных сетей
- 16.4. Вывод в естественном языке и набор данных
- 16.5. Вывод в естественном языке: использование внимания
- 16.6. Дообучение BERT для задач на уровне последовательностей и токенов
- 16.7. Вывод на естественном языке: дообучение BERT