
15.2. Приближённое обучение
Вспомним наши обсуждения в Section 15.1. Основная идея модели skip-gram заключается в использовании операций софтмакс для вычисления условной вероятности появления контекстного слова \(w_o\) при заданном центральном слове \(w_c\) в (15.1.4), соответствующая логарифмическая потеря определяется как величина, противоположная (15.1.7).
Из-за природы операции софтмакс, поскольку контекстное слово может быть любым из слов в словаре \(\mathcal{V}\), величина, обратная (15.1.7), содержит сумму слагаемых, количество которых равно размеру всего словаря. Следовательно, вычисление градиента для модели skip-gram в (15.1.8) и для модели continuous bag-of-words в (15.1.15) включает суммирование. К сожалению, вычислительная стоимость таких градиентов, требующих суммирования по большому словарю (часто содержащему сотни тысяч или миллионы слов), оказывается огромной!
Чтобы снизить указанную выше вычислительную сложность, в этом разделе будут рассмотрены два метода приближенного обучения: отрицательная выборка и иерархический софтмакс. Ввиду схожести модели skip-gram и модели непрерывного мешка слов (CBOW) в качестве примера для описания этих двух методов приближенного обучения мы будем использовать только модель skip-gram.
15.2.1. Отрицательная выборка
Отрицательная выборка изменяет исходную целевую функцию. Учитывая контекстное окно центрального слова \(w_c\), тот факт, что любое (контекстное) слово \(w_o\) взято из этого контекстного окна, рассматривается как событие с вероятностью, моделируемой
где \(\sigma\) использует определение функции активации сигмоиды:
Начнем с максимизации совместной вероятности всех таких событий в текстовых последовательностях для обучения векторных представлений слов. В частности, пусть дана текстовая последовательность длины \(T\), обозначим через \(w^{(t)}\) слово на шаге времени \(t\), а размер контекстного окна примем равным \(m\). Рассмотрим задачу максимизации совместной вероятности
Однако (15.2.3) учитывает только те события, которые включают положительные примеры. В результате совместная вероятность в (15.2.3) достигает максимума, равного 1, только если все векторы слов стремятся к бесконечности. Очевидно, такие результаты бессмысленны. Чтобы сделать целевую функцию более осмысленной, отрицательная выборка добавляет отрицательные примеры, выбранные из заранее определённого распределения.
Обозначим через \(S\) событие, что контекстное слово \(w_o\) взято из контекстного окна центрального слова \(w_c\). Для этого события, включающего \(w_o\), из заранее заданного распределения \(P(w)\) выберем \(K\) шумовых примеров, которые не принадлежат этому контекстному окну. Обозначим через \(N_k\) событие, что шумовой пример \(w_k\) (\(k=1, \ldots, K\)) не взят из контекстного окна слова \(w_c\). Будем считать, что эти события, включающие как положительные примеры, так и отрицательные примеры \(S, N_1, \ldots, N_K\), являются взаимно независимыми. Метод отрицательной выборки переписывает совместную вероятность (включающую только положительные примеры) из (15.2.3) следующим образом:
где условная вероятность аппроксимируется через события \(S, N_1, \ldots, N_K\):
Обозначим через \(i_t\) и \(h_k\) индексы слова \(w^{(t)}\) на шаге \(t\) в последовательности текста и шумового слова \(w_k\) соответственно. Логарифмическая функция потерь относительно условных вероятностей в (15.2.5) имеет вид
Мы видим, что теперь вычислительная стоимость вычисления градиентов на каждом шаге обучения не зависит от размера словаря, а линейно зависит от \(K\). При задании гиперпараметру \(K\) меньшего значения вычислительная стоимость вычисления градиентов на каждом шаге обучения с отрицательной выборкой снижается.
15.2.2. Иерархический софтмакс
В качестве альтернативного приближённого метода обучения иерархический софтмакс использует бинарное дерево — структуру данных, показанную на рисунке Fig. 15.2.1, где каждый листовой узел дерева представляет слово из словаря \(\mathcal{V}\).
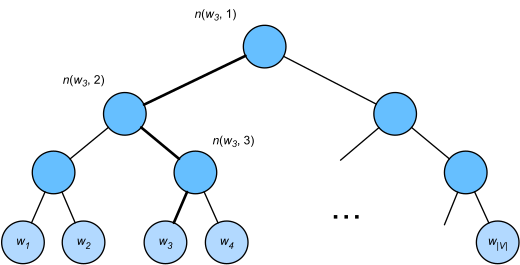
Fig. 15.2.1 Иерархический софтмакс для приближённого обучения, где каждый листовой узел дерева представляет слово из словаря.
Обозначим через \(L(w)\) количество узлов (включая оба конца) на пути от корневого узла до листового узла, представляющего слово \(w\) в бинарном дереве. Пусть \(n(w,j)\) будет \(j^\textrm{th}\) узлом на этом пути, а его вектором контекстного слова — \(\mathbf{u}_{n(w, j)}\). Например, \(L(w_3) = 4\) в Fig. 15.2.1. Иерархический софтмакс аппроксимирует условную вероятность в (15.1.4) как
где функция \(\sigma\) задана в (15.2.2), а \(\textrm{leftChild}(n)\) — левый дочерний узел узла \(n\): если \(x\) истинно, то \([\![x]\!] = 1\), иначе \([\![x]\!] = -1\).
Для наглядности рассчитаем условную вероятность генерации слова \(w_3\) при условии появления слова \(w_c\) в контексте Fig. 15.2.1. Для этого необходимо вычислить скалярные произведения между вектором слова \(\mathbf{v}_c\) для \(w_c\) и векторами внутренних узлов на пути (выделен жирным на рисунке Fig. 15.2.1) от корня до \(w_3\), который проходит влево, затем вправо и снова влево:
Поскольку \(\sigma(x)+\sigma(-x) = 1\), сумма условных вероятностей генерации всех слов из словаря \(\mathcal{V}\) по любому слову \(w_c\) равна единице:
К счастью, поскольку \(L(w_o)-1\) имеет порядок величины \(\mathcal{O}(\textrm{log}_2|\mathcal{V}|)\) благодаря структуре бинарного дерева, при огромном размере словаря \(\mathcal{V}\) вычислительные затраты на каждый шаг обучения с использованием иерархического софтмакса значительно снижаются по сравнению с подходом без приближённого обучения.
15.2.3. Итоги
Отрицательная выборка формирует функцию потерь, рассматривая взаимно независимые события, включающие как положительные, так и отрицательные примеры. Вычислительная стоимость обучения линейно зависит от количества шумовых слов на каждом шаге.
Иерархический софтмакс формирует функцию потерь, используя путь от корневого узла к листовому узлу в бинарном дереве. Вычислительная сложность при обучении зависит от логарифма размера словаря на каждом шаге.
15.2.4. Упражнения
Как мы можем выбирать примеры шумовых слов при отрицательной выборке?
Проверьте, что выполняется (15.2.9).
Как обучить модель непрерывного мешка слов с использованием отрицательной выборки и иерархического софтмакса соответственно?