
10. Современные рекуррентные нейронные сетиnavigate_next 10.8. Лучевой поиск
Quick search
code
Show Source
PyTorch MXNet Notebooks Courses GitHub
Погружение в глубокое обучение
Table Of Contents
  • Предисловие
  • Установка
  • Обозначения
  • 1. Введение
  • 2. Предварительные сведения
    • 2.1. Манипуляция данными
    • 2.2. Предобработка данных
    • 2.3. Линейная алгебра
    • 2.4. Математический анализ
    • 2.5. Автоматическое дифференцирование
    • 2.6. Вероятность и статистика
    • 2.7. Документация
  • 3. Линейные нейронные сети для регрессии
    • 3.1. Линейная регрессия
    • 3.2. Объектно-ориентированное проектирование для реализации
    • 3.3. Синтетические данные для регрессии
    • 3.4. Реализация линейной регрессии с нуля
    • 3.5. Краткая реализация линейной регрессии
    • 3.6. Обобщающая способность
    • 3.7. Затухание весов
  • 4. Линейные нейронные сети для классификации
    • 4.1. Софтмакс-регрессия
    • 4.2. Набор данных для классификации изображений
    • 4.3. Базовая модель классификации
    • 4.4. Реализация софтмакс-регрессии с нуля
    • 4.5. Краткая реализация софтмакс-регрессии
    • 4.6. Обобщающая способность в классификации
    • 4.7. Среда и сдвиг распределения
  • 5. Многослойные перцептроны
    • 5.1. Многослойные перцептроны
    • 5.2. Реализация многослойных перцептронов
    • 5.3. Прямое распространение, обратное распространение и вычислительные графы
    • 5.4. Численная устойчивость и инициализация
    • 5.5. Обобщающая способность в глубоком обучении
    • 5.6. Дропаут
    • 5.7. Прогнозирование цен на дома на Kaggle
  • 6. Руководство для разработчиков
    • 6.1. Слои и модули
    • 6.2. Управление параметрами
    • 6.3. Инициализация параметров
    • 6.4. Ленивая инициализация
    • 6.5. Пользовательские слои
    • 6.6. Ввод-вывод файлов
    • 6.7. Графические процессоры (GPU)
  • 7. Свёрточные нейронные сети
    • 7.1. От полносвязных слоёв к свёрткам
    • 7.2. Свёртки для изображений
    • 7.3. Дополнение и шаг
    • 7.4. Несколько входных и выходных каналов
    • 7.5. Пулинг
    • 7.6. Свёрточные нейронные сети (LeNet)
  • 8. Современные свёрточные нейронные сети
    • 8.1. Глубокие свёрточные нейронные сети (AlexNet)
    • 8.2. Сети, использующие блоки (VGG)
    • 8.3. Сеть в сети (NiN)
    • 8.4. Многоветвевые сети (GoogLeNet)
    • 8.5. Батч-нормализация
    • 8.6. Остаточные сети (ResNet) и ResNeXt
    • 8.7. Плотные сети (DenseNet)
    • 8.8. Проектирование архитектур свёрточных сетей
  • 9. Рекуррентные нейронные сети
    • 9.1. Работа с последовательностями
    • 9.2. Преобразование исходного текста в данные последовательности
    • 9.3. Языковые модели
    • 9.4. Рекуррентные нейронные сети
    • 9.5. Реализация рекуррентной нейронной сети с нуля
    • 9.6. Краткая реализация рекуррентных нейронных сетей
    • 9.7. Обратное распространение ошибки через время
  • 10. Современные рекуррентные нейронные сети
    • 10.1. Долгая краткосрочная память (LSTM)
    • 10.2. Блоки с управляемыми переходами (GRU)
    • 10.3. Глубокие рекуррентные нейронные сети
    • 10.4. Двухнаправленные рекуррентные нейронные сети
    • 10.5. Машинный перевод и набор данных
    • 10.6. Архитектура кодировщик–декодировщик
    • 10.7. Обучение последовательность-в-последовательность для машинного перевода
    • 10.8. Лучевой поиск
  • 11. Механизмы внимания и трансформеры
    • 11.1. Запросы, ключи и значения
    • 11.2. Агрегирование по вниманию на основе сходства
    • 11.3. Функции оценки внимания
    • 11.4. Механизм внимания Бадау
    • 11.5. Многоголовое внимание
    • 11.6. Самовнимание и позиционное кодирование
    • 11.7. Архитектура трансформера
    • 11.8. Трансформеры для компьютерного зрения
    • 11.9. Масштабное предобучение с помощью трансформеров
  • 12. Алгоритмы оптимизации
    • 12.1. Оптимизация и глубокое обучение
    • 12.2. Выпуклость
    • 12.3. Градиентный спуск
    • 12.4. Стохастический градиентный спуск
    • 12.5. Стохастический градиентный спуск на мини-батчах
    • 12.6. Импульс
    • 12.7. Adagrad
    • 12.8. RMSProp
    • 12.9. Adadelta
    • 12.10. Адам
    • 12.11. Планирование скорости обучения
  • 13. Вычислительная производительность
    • 13.1. Компиляторы и интерпретаторы
    • 13.2. Асинхронные вычисления
    • 13.3. Автоматический параллелизм
    • 13.4. Аппаратное обеспечение
    • 13.5. Обучение на нескольких GPU
    • 13.6. Краткая реализация для нескольких GPU
    • 13.7. Серверы параметров
  • 14. Компьютерное зрение
    • 14.1. Аугментация изображений
    • 14.2. Дообучение
    • 14.3. Обнаружение объектов и ограничивающие рамки
    • 14.4. Якорные рамки
    • 14.5. Обнаружение объектов на разных масштабах
    • 14.6. Набор данных для обнаружения объектов
    • 14.7. Однопроходное обнаружение с несколькими боксами
    • 14.8. Региональные свёрточные нейронные сети (R-CNN)
    • 14.9. Семантическая сегментация и набор данных
    • 14.10. Свёртка с транспонированием
    • 14.11. Полностью свёрточные сети
    • 14.12. Перенос нейронного стиля
    • 14.13. Классификация изображений (CIFAR-10) на Kaggle
    • 14.14. Идентификация породы собак (ImageNet Dogs) на Kaggle
  • 15. Обработка естественного языка: Предобучение
    • 15.1. Эмбеддинг слов (word2vec)
    • 15.2. Приближённое обучение
    • 15.3. Раздел учебника: Набор данных для предобучения словесных вложений
    • 15.4. Предобучение word2vec
    • 15.5. Эмбеддинг слов с помощью глобальных векторов (GloVe)
    • 15.6. Эмбеддинг подслов
    • 15.7. Сходство и аналогия слов
    • 15.8. Двухсторонние представления кодировщика на основе трансформеров (BERT)
    • 15.9. Набор данных для предобучения BERT
    • 15.10. Предобучение BERT
  • 16. Обработка естественного языка: приложения
    • 16.1. Анализ тональности и набор данных
    • 16.2. Анализ тональности: использование рекуррентных нейронных сетей
    • 16.3. Анализ тональности: использование свёрточных нейронных сетей
    • 16.4. Вывод в естественном языке и набор данных
    • 16.5. Вывод в естественном языке: использование внимания
    • 16.6. Дообучение BERT для задач на уровне последовательностей и токенов
    • 16.7. Вывод на естественном языке: дообучение BERT
  • 17. Обучение с подкреплением
    • 17.1. Марковский процесс принятия решений (MDP)
    • 17.2. Итерация значений
    • 17.3. Q-обучение
  • 18. Гауссовские процессы
    • 18.1. Введение в гауссовские процессы
    • 18.2. Априорные распределения гаусовских процессов
    • 18.3. Вывод гауссовского процесса
  • 19. Оптимизация гиперпараметров
    • 19.1. Что такое оптимизация гиперпараметров?
    • 19.2. API оптимизации гиперпараметров
    • 19.3. Асинхронный случайный поиск
    • 19.4. Многоуровневая оптимизация гиперпараметров
    • 19.5. Асинхронное последовательное отсечение
  • 20. Генеративно-состязательные сети
    • 20.1. Генеративно-состязательные сети
    • 20.2. Глубокие свёрточные генеративно-состязательные сети
  • 21. Системы рекомендаций
    • 21.1. Обзор систем рекомендаций
  • 22. Приложение: Математика для глубокого обучения
    • 22.1. Геометрия и линейно-алгебраические операции
    • 22.2. Собственные разложения
    • 22.3. Дифференциальное исчисление одной переменной
    • 22.4. Многомерное исчисление
    • 22.5. Интегральное исчисление
    • 22.6. Случайные величины
    • 22.7. Максимальное правдоподобие
    • 22.8. Распределения
    • 22.9. Наивный байесовский классификатор
    • 22.10. Статистика
    • 22.11. Теория информации
  • 23. Приложение: Инструменты для глубокого обучения
    • 23.1. Использование Jupyter Notebook
    • 23.2. Использование Amazon SageMaker
    • 23.3. Использование экземпляров AWS EC2
    • 23.4. Использование Google Colab
    • 23.5. Выбор серверов и графических процессоров
    • 23.6. Вклад в эту книгу
    • 23.7. Вспомогательные функции и классы
    • 23.8. Документация по API d2l
  • References

10.8. Лучевой поиск

В разделе Section 10.7 мы познакомились с архитектурой кодировщик–декодировщик и стандартными методами её сквозного обучения. Однако при обсуждении предсказаний на этапе тестирования мы упомянули лишь жадную стратегию, при которой на каждом временном шаге выбирается токен с наибольшей предсказанной вероятностью появления следующим, пока на каком-то шаге не будет сгенерирован специальный токен конца последовательности «<eos>». В этом разделе мы сначала формализуем стратегию жадного поиска и укажем на некоторые проблемы, с которыми часто сталкиваются практикующие специалисты. Затем мы сравним эту стратегию с двумя альтернативами: полным перебором (иллюстративным, но непрактичным) и лучевым поиском (стандартным методом, применяемым на практике).

Начнем с введения математических обозначений, заимствуя соглашения из Section 10.7. На любом шаге времени \(t'\) декодировщик выдает предсказания, представляющие вероятность каждого токена в словаре быть следующим в последовательности (вероятное значение \(y_{t'+1}\)), при условии предыдущих токенов \(y_1, \ldots, y_{t'}\) и переменной контекста \(\mathbf{c}\), сгенерированной кодировщиком для представления входной последовательности. Для количественной оценки вычислительных затрат обозначим через \(\mathcal{Y}\) выходной словарь (включая специальный токен конца последовательности “<eos>”). Также определим максимальное количество токенов в выходной последовательности как \(T'\). Наша цель — найти оптимальный выход из всех \(\mathcal{O}(\left|\mathcal{Y}\right|^{T'})\) возможных выходных последовательностей. Обратите внимание, что это немного завышает количество различных выходов, поскольку после появления токена “<eos>” последующие токены отсутствуют. Однако для наших целей это число примерно отражает размер пространства поиска.

10.8.1. Жадный поиск

Рассмотрим простую стратегию жадного поиска из Section 10.7. На каждом временном шаге \(t'\) мы просто выбираем токен с наибольшей условной вероятностью из \(\mathcal{Y}\), то есть

(10.8.1)¶\[y_{t'} = \operatorname*{argmax}_{y \in \mathcal{Y}} P(y \mid y_1, \ldots, y_{t'-1}, \mathbf{c}).\]

Как только наша модель выводит <eos> (или мы достигаем максимальной длины \(T'\)), выходная последовательность завершается.

Эта стратегия может показаться разумной, и на самом деле она не так уж плоха! Учитывая её низкие вычислительные затраты, трудно найти более выгодное решение. Однако, если отложить в сторону вопросы эффективности, более разумным может показаться поиск наиболее вероятной последовательности, а не последовательности из (жадно выбранных) наиболее вероятных токенов. Оказывается, эти два объекта могут существенно различаться. Наиболее вероятная последовательность — это та, которая максимизирует выражение \(\prod_{t'=1}^{T'} P(y_{t'} \mid y_1, \ldots, y_{t'-1}, \mathbf{c})\). В нашем примере машинного перевода, если бы декодировщик действительно восстанавливал вероятности лежащего в основе процесса генерации, это дало бы нам наиболее вероятный перевод. К сожалению, нет никаких гарантий, что жадный поиск даст нам именно эту последовательность.

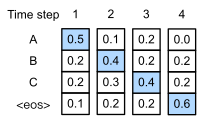
Проиллюстрируем это на примере. Предположим, что в выходном словаре содержатся четыре токена: «A», «B», «C» и «<eos>». На рисунке Fig. 10.8.1 четыре числа под каждым временным шагом обозначают условные вероятности генерации токенов «A», «B», «C» и «<eos>» соответственно в этот момент времени.
../_images/s2s-prob1.svg

Fig. 10.8.1 На каждом временном шаге жадный поиск выбирает токен с наибольшей условной вероятностью.

На каждом временном шаге жадный поиск выбирает токен с наибольшей условной вероятностью. Следовательно, будет предсказана выходная последовательность «A», «B», «C» и «<eos>» (Fig. 10.8.1). Условная вероятность этой выходной последовательности составляет \(0.5\times0.4\times0.4\times0.6 = 0.048\).

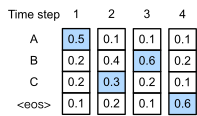
Далее рассмотрим другой пример в Fig. 10.8.2. В отличие от Fig. 10.8.1, на шаге 2 мы выбираем токен «C», имеющий вторую по величине условную вероятность.
../_images/s2s-prob2.svg

Fig. 10.8.2 Четыре числа под каждым временным шагом представляют условные вероятности генерации токенов «A», «B», «C» и «<eos>» на данном временном шаге. На втором временном шаге выбирается токен «C», имеющий вторую по величине условную вероятность.

Поскольку выходные подпоследовательности на шагах 1 и 2, на которых основывается шаг 3, изменились с «A» и «B» в Fig. 10.8.1 на «A» и «C» в Fig. 10.8.2, условная вероятность каждого токена на шаге 3 также изменилась в Fig. 10.8.2. Предположим, что на шаге 3 мы выбираем токен «B». Теперь шаг 4 зависит от выходной подпоследовательности за первые три шага — «A», «C» и «B», которая изменилась по сравнению с «A», «B» и «C» в Fig. 10.8.1. Следовательно, условная вероятность генерации каждого токена на шаге 4 в Fig. 10.8.2 также отличается от той, что в Fig. 10.8.1. В результате условная вероятность выходной последовательности «A», «C», «B» и «<eos>» в Fig. 10.8.2 равна \(0.5\times0.3 \times0.6\times0.6=0.054\), что больше, чем вероятность при жадном поиске в Fig. 10.8.1. В этом примере выходная последовательность «A», «B», «C» и «<eos>», полученная с помощью жадного поиска, не является оптимальной.

10.8.2. Полный перебор

Если цель состоит в том, чтобы получить наиболее вероятную последовательность, можно рассмотреть возможность использования полного перебора: перебрать все возможные выходные последовательности вместе с их условными вероятностями, а затем выбрать ту, которая имеет наибольшую предсказанную вероятность.

Хотя такой подход, безусловно, даст нам желаемый результат, он потребует непомерно высоких вычислительных затрат, равных \(\mathcal{O}(\left|\mathcal{Y}\right|^{T'})\), экспоненциально растущих от длины последовательности и имеющих огромный базис, определяемый размером словаря. Например, когда \(|\mathcal{Y}|=10000\) и \(T'=10\), оба значения невелики по сравнению с теми, что встречаются в реальных приложениях, нам придётся оценить \(10000^{10} = 10^{40}\) последовательностей, что уже выходит за рамки возможностей любых предсказуемых компьютеров. С другой стороны, вычислительная стоимость жадного поиска составляет \(\mathcal{O}(\left|\mathcal{Y}\right|T')\): удивительно дешево, но далеко не оптимально. Например, когда \(|\mathcal{Y}|=10000\) и \(T'=10\), нам нужно оценить лишь \(10000\times10=10^5\) последовательностей.

10.8.3. Лучевой поиск

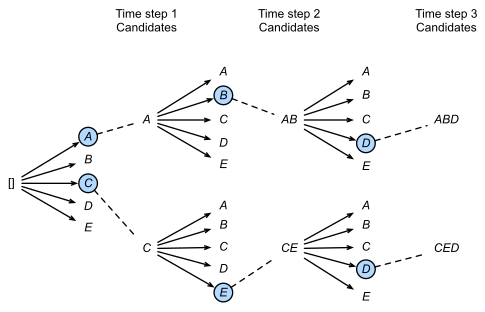
Стратегии декодирования последовательностей можно рассматривать как находящиеся на одном спектре, где лучевой поиск представляет собой компромисс между эффективностью жадного поиска и оптимальностью полного перебора. Наиболее простая версия лучевого поиска характеризуется одним гиперпараметром — размером луча, \(k\). Рассмотрим эту терминологию. На шаге 1 мы выбираем \(k\) токенов с наибольшими предсказанными вероятностями. Каждый из них станет первым токеном для \(k\) кандидатных выходных последовательностей соответственно. На каждом последующем шаге, опираясь на \(k\) кандидатных выходных последовательностей с предыдущего шага, мы продолжаем выбирать \(k\) кандидатных выходных последовательностей с наибольшими предсказанными вероятностями из \(k\left|\mathcal{Y}\right|\) возможных вариантов.
../_images/beam-search.svg

Fig. 10.8.3 Процесс лучевого поиска (размер луча \(=2\); максимальная длина выходной последовательности \(=3\)). Кандидатные выходные последовательности — это \(\mathit{A}\), \(\mathit{C}\), \(\mathit{AB}\), \(\mathit{CE}\), \(\mathit{ABD}\) и \(\mathit{CED}\).

Fig. 10.8.3 демонстрирует процесс лучевого поиска на примере. Предположим, что выходной словарь содержит всего пять элементов: \(\mathcal{Y} = \{A, B, C, D, E\}\), среди которых есть «<eos>». Пусть размер луча равен двум, а максимальная длина выходной последовательности — трём. На шаге 1 предположим, что токены с наибольшими условными вероятностями \(P(y_1 \mid \mathbf{c})\) — это \(A\) и \(C\). На шаге 2 для всех \(y_2 \in \mathcal{Y},\) мы вычисляем

(10.8.2)¶\[\begin{split}\begin{aligned}P(A, y_2 \mid \mathbf{c}) = P(A \mid \mathbf{c})P(y_2 \mid A, \mathbf{c}),\\ P(C, y_2 \mid \mathbf{c}) = P(C \mid \mathbf{c})P(y_2 \mid C, \mathbf{c}),\end{aligned}\end{split}\]

и выберем два наибольших значения из этих десяти, например \(P(A, B \mid \mathbf{c})\) и \(P(C, E \mid \mathbf{c})\). Затем на шаге 3 для всех \(y_3 \in \mathcal{Y}\) вычислим

(10.8.3)¶\[\begin{split}\begin{aligned}P(A, B, y_3 \mid \mathbf{c}) = P(A, B \mid \mathbf{c})P(y_3 \mid A, B, \mathbf{c}),\\P(C, E, y_3 \mid \mathbf{c}) = P(C, E \mid \mathbf{c})P(y_3 \mid C, E, \mathbf{c}),\end{aligned}\end{split}\]

и выбрать два наибольших среди этих десяти значений, скажем \(P(A, B, D \mid \mathbf{c})\) и \(P(C, E, D \mid \mathbf{c}).\). В результате мы получим шесть кандидатов в выходные последовательности: (i) \(A\); (ii) \(C\); (iii) \(A\), \(B\); (iv) \(C\), \(E\); (v) \(A\), \(B\), \(D\); и (vi) \(C\), \(E\), \(D\).

В итоге мы получаем множество финальных кандидатов на выходную последовательность на основе этих шести последовательностей (например, отбрасываем фрагменты, включая и после «<eos>»). Затем мы выбираем выходную последовательность, которая максимизирует следующий показатель:

(10.8.4)¶\[\frac{1}{L^\alpha} \log P(y_1, \ldots, y_{L}\mid \mathbf{c}) = \frac{1}{L^\alpha} \sum_{t'=1}^L \log P(y_{t'} \mid y_1, \ldots, y_{t'-1}, \mathbf{c});\]

где \(L\) — длина итоговой кандидатской последовательности, а \(\alpha\) обычно принимается равным 0,75. Поскольку в сумме (10.8.4) более длинная последовательность содержит больше логарифмических слагаемых, член \(L^\alpha\) в знаменателе штрафует за длинные последовательности.

Вычислительная сложность лучевого поиска составляет \(\mathcal{O}(k\left|\mathcal{Y}\right|T')\). Этот результат находится между сложностью жадного поиска и полным перебором. Жадный поиск можно рассматривать как частный случай лучевого поиска, возникающий при размере луча, равном 1.

10.8.4. Итоги

Стратегии поиска последовательностей включают жадный поиск, полный перебор и лучевой поиск. Лучевой поиск обеспечивает баланс между точностью и вычислительными затратами за счёт гибкого выбора размера луча.

10.8.5. Упражнения

  1. Можно ли рассматривать полный перебор как частный случай лучевого поиска? Почему да или почему нет?

  2. Примените лучевой поиск к задаче машинного перевода в Section 10.7. Как размер луча влияет на результаты перевода и скорость предсказания?

  3. В разделе Section 9.5 мы использовали языковое моделирование для генерации текста по заданным пользователем префиксам. Какую стратегию поиска она использует? Можно ли её улучшить?

Обсуждения

Table Of Contents

  • 10.8. Лучевой поиск
    • 10.8.1. Жадный поиск
    • 10.8.2. Полный перебор
    • 10.8.3. Лучевой поиск
    • 10.8.4. Итоги
    • 10.8.5. Упражнения
Previous
10.7. Обучение последовательность-в-последовательность для машинного перевода
Next
11. Механизмы внимания и трансформеры