
11.3. Функции оценки внимания
В Section 11.2 мы использовали ряд различных ядер, основанных на расстоянии, включая гауссово ядро для моделирования взаимодействий между запросами и ключами. Как выяснилось, функции расстояния вычисляются несколько дороже, чем скалярные произведения. Поэтому, учитывая операцию софтмакс, обеспечивающую неотрицательность весов внимания, значительная часть усилий была направлена на разработку функций оценки внимания \(a\) в (11.1.3) и Fig. 11.3.1, которые проще вычислять.
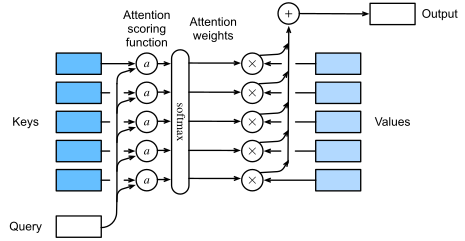
Fig. 11.3.1 Вычисление результата агрегирования по вниманию как взвешенного среднего значений, где веса вычисляются с помощью функции оценки внимания \(\mathit{a}\) и операции софтмакс.
import math
import torch
from torch import nn
from d2l import torch as d2l
11.3.1. Внимание на основе скалярного произведения
Давайте на мгновение рассмотрим функцию внимания (без экспоненцирования) из гауссова ядра:
Прежде всего отметим, что последний член зависит только от \(\mathbf{q}\). Следовательно, он одинаков для всех пар \((\mathbf{q}, \mathbf{k}_i)\). Нормализация весов внимания до \(1\), как это делается в (11.1.3), гарантирует, что этот член полностью исчезает. Во-вторых, отметим, что как пакетная, так и нормализация слоя (о которых речь пойдет позже) приводят к активациям с хорошо ограниченными и часто постоянными нормами \(\|\mathbf{k}_i\|\). Это имеет место, например, когда ключи \(\mathbf{k}_i\) были получены с помощью нормализации слоя. Таким образом, мы можем опустить его из определения \(a\) без существенного изменения результата.
Наконец, необходимо контролировать порядок величины аргументов экспоненциальной функции. Предположим, что все элементы запроса \(\mathbf{q} \in \mathbb{R}^d\) и ключа \(\mathbf{k}_i \in \mathbb{R}^d\) являются независимыми и одинаково распределенными случайными величинами с нулевым средним и единичной дисперсией. Скалярное произведение этих векторов имеет нулевое среднее и дисперсию \(d\). Чтобы дисперсия скалярного произведения оставалась равной \(1\) независимо от длины вектора, мы используем функцию оценки масштабированного скалярного произведения внимания (scaled dot product attention). То есть мы нормируем скалярное произведение на \(1/\sqrt{d}\). Таким образом, мы получаем первую широко используемую функцию внимания, которая применяется, например, в трансформерах (Vaswani et al., 2017):
Обратите внимание, что веса внимания \(\alpha\) всё ещё требуют нормализации. Мы можем упростить это ещё больше, используя операцию софтмакс (11.1.3):
Как выясняется, все популярные механизмы внимания используют софтмакс, поэтому в оставшейся части этой главы мы ограничимся именно им.
11.3.2. Вспомогательные функции
Для эффективного развертывания механизма внимания нам потребуется несколько вспомогательных функций. В их число входят инструменты для работы со строками переменной длины (что типично для обработки естественного языка) и средства эффективного вычисления на мини-пакетах (пакетное матричное умножение).
11.3.2.1. Маскированная операция софтмакс
Одним из наиболее популярных применений механизма внимания являются модели последовательностей. Следовательно, нам необходимо уметь обрабатывать последовательности разной длины. В некоторых случаях такие последовательности могут оказаться в одном мини-батче, что потребует дополнения более коротких последовательностей фиктивными токенами (см. Section 10.5 для примера). Эти специальные токены не несут смысловой нагрузки. Например, предположим, что у нас есть следующие три предложения:
Dive  into  Deep    Learning
Learn to    code    <blank>
Hello world <blank> <blank>
Поскольку мы не хотим, чтобы в нашей модели внимания присутствовали пустые места, нам просто нужно ограничить \(\sum_{i=1}^n \alpha(\mathbf{q}, \mathbf{k}_i) \mathbf{v}_i\) до \(\sum_{i=1}^l \alpha(\mathbf{q}, \mathbf{k}_i) \mathbf{v}_i\) на протяжении всей длины \(l \leq n\), равной длине самого предложения. Поскольку это очень распространённая проблема, у неё есть своё название: маскированная операция софтмакс.
Давайте реализуем это. На самом деле реализация немного «хитрит», устанавливая значения \(\mathbf{v}_i\) при \(i > l\) равными нулю. Кроме того, она присваивает весам внимания большое отрицательное число, например \(-10^{6}\), чтобы на практике их вклад в градиенты и значения становился пренебрежимо малым. Это делается потому, что ядра и операторы линейной алгебры сильно оптимизированы для графических процессоров, и вычислительно выгоднее допустить небольшую расточительность, чем использовать код с условными операторами (if-then-else).
def masked_softmax(X, valid_lens):  #@save
    """Perform softmax operation by masking elements on the last axis."""
    # X: 3D tensor, valid_lens: 1D or 2D tensor
    def _sequence_mask(X, valid_len, value=0):
        maxlen = X.size(1)
        mask = torch.arange((maxlen), dtype=torch.float32,
                            device=X.device)[None, :] < valid_len[:, None]
        X[~mask] = value
        return X

    if valid_lens is None:
        return nn.functional.softmax(X, dim=-1)
    else:
        shape = X.shape
        if valid_lens.dim() == 1:
            valid_lens = torch.repeat_interleave(valid_lens, shape[1])
        else:
            valid_lens = valid_lens.reshape(-1)
        # On the last axis, replace masked elements with a very large negative
        # value, whose exponentiation outputs 0
        X = _sequence_mask(X.reshape(-1, shape[-1]), valid_lens, value=-1e6)
        return nn.functional.softmax(X.reshape(shape), dim=-1)
Чтобы проиллюстрировать, как работает эта функция, рассмотрим мини-батч из двух примеров размера \(2 \times 4\), у которых допустимые длины равны \(2\) и \(3\) соответственно. В результате применения операции маскированного софтмакса значения, выходящие за пределы допустимых длин для каждой пары векторов, заменяются нулями.
masked_softmax(torch.rand(2, 2, 4), torch.tensor([2, 3]))
Если нам требуется более тонкий контроль для указания допустимой длины каждого из двух векторов в каждом примере, мы просто используем двумерный тензор допустимых длин. Это даёт:
masked_softmax(torch.rand(2, 2, 4), torch.tensor([[1, 3], [2, 4]]))
11.3.2.2. Пакетное матричное умножение
Другой часто используемой операцией является поэлементное умножение батчей матриц. Это удобно, когда у нас есть мини-батчи запросов, ключей и значений. Более конкретно, предположим, что
Тогда пакетное матричное умножение (BMM) вычисляет поэлементное произведение
Давайте посмотрим, как это работает в фреймворке глубокого обучения.
Q = torch.ones((2, 3, 4))
K = torch.ones((2, 4, 6))
d2l.check_shape(torch.bmm(Q, K), (2, 3, 6))
11.3.3. Внимание с масштабированным скалярным произведением
Вернёмся к механизму внимания на основе скалярного произведения, описанному в (11.3.2). Как правило, он требует, чтобы векторы запроса и ключа имели одинаковую длину, обозначим её как \(d\). Хотя эту проблему можно легко решить, заменив \(\mathbf{q}^\top \mathbf{k}\) на \(\mathbf{q}^\top \mathbf{M} \mathbf{k}\), где \(\mathbf{M}\) — это матрица, специально подобранная для преобразования между обоими пространствами. Пока будем считать, что размерности совпадают.
На практике для повышения эффективности мы часто работаем с мини-пакетами, например, вычисляя внимание для \(n\) запросов и \(m\) пар ключ-значение, где запросы и ключи имеют длину \(d\), а значения — длину \(v\). Масштабированное внимание на основе скалярного произведения для запросов \(\mathbf Q\in\mathbb R^{n\times d}\), ключей \(\mathbf K\in\mathbb R^{m\times d}\) и значений \(\mathbf V\in\mathbb R^{m\times v}\) можно записать как
Обратите внимание, что при применении этого к мини-батчу необходимо использовать матричное умножение для батчей, введенное в (11.3.5). В следующей реализации взвешенного скалярного произведения для внимания мы используем дропаут для регуляризации модели.
class DotProductAttention(nn.Module):  #@save
    """Scaled dot product attention."""
    def __init__(self, dropout):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

    # Shape of queries: (batch_size, no. of queries, d)
    # Shape of keys: (batch_size, no. of key-value pairs, d)
    # Shape of values: (batch_size, no. of key-value pairs, value dimension)
    # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
    def forward(self, queries, keys, values, valid_lens=None):
        d = queries.shape[-1]
        # Swap the last two dimensions of keys with keys.transpose(1, 2)
        scores = torch.bmm(queries, keys.transpose(1, 2)) / math.sqrt(d)
        self.attention_weights = masked_softmax(scores, valid_lens)
        return torch.bmm(self.dropout(self.attention_weights), values)
Чтобы проиллюстрировать работу класса DotProductAttention , мы
используем те же ключи, значения и допустимые длины, что и в предыдущем
примере с аддитивным вниманием. В рамках нашего примера предположим, что
размер мини-батча равен \(2\), общее количество ключей и значений
равно \(10\), а размерность значений составляет \(4\). Кроме
того, предположим, что допустимая длина для каждого наблюдения равна
\(2\) и \(6\) соответственно. Таким образом, мы ожидаем, что
выходной тензор будет иметь размерность \(2 \times 1 \times 4\), то
есть по одной строке на пример в мини-батче.
queries = torch.normal(0, 1, (2, 1, 2))
keys = torch.normal(0, 1, (2, 10, 2))
values = torch.normal(0, 1, (2, 10, 4))
valid_lens = torch.tensor([2, 6])

attention = DotProductAttention(dropout=0.5)
attention.eval()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
Проверим, действительно ли веса внимания обращаются в ноль для всех элементов, кроме второго и шестого столбцов соответственно (поскольку допустимая длина установлена равной \(2\) и \(6\)).
d2l.show_heatmaps(attention.attention_weights.reshape((1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
11.3.4. Аддитивное внимание
Когда запросы \(\mathbf{q}\) и ключи \(\mathbf{k}\) имеют различную размерность, мы можем либо использовать матрицу для устранения несоответствия через \(\mathbf{q}^\top \mathbf{M} \mathbf{k}\), либо применить аддитивное внимание в качестве функции оценки. Ещё одно преимущество заключается в том, что, как следует из названия, внимание является аддитивным. Это может привести к некоторым незначительным вычислительным экономиям. Для заданных запроса \(\mathbf{q} \in \mathbb{R}^q\) и ключа \(\mathbf{k} \in \mathbb{R}^k\) функция оценки аддитивного внимания (Bahdanau et al., 2014) задаётся следующим образом:
где \(\mathbf W_q\in\mathbb R^{h\times q}\), \(\mathbf W_k\in\mathbb R^{h\times k}\) и \(\mathbf w_v\in\mathbb R^{h}\) — обучаемые параметры. Затем этот результат подается на софтмакс, чтобы обеспечить неотрицательность и нормировку. Эквивалентная интерпретация (11.3.7) заключается в том, что запрос и ключ объединяются и подаются на многослойный перцептрон с одним скрытым слоем. Используя \(\tanh\) в качестве функции активации и отключив смещения, мы реализуем аддитивное внимание следующим образом:
class AdditiveAttention(nn.Module):  #@save
    """Additive attention."""
    def __init__(self, num_hiddens, dropout, **kwargs):
        super(AdditiveAttention, self).__init__(**kwargs)
        self.W_k = nn.LazyLinear(num_hiddens, bias=False)
        self.W_q = nn.LazyLinear(num_hiddens, bias=False)
        self.w_v = nn.LazyLinear(1, bias=False)
        self.dropout = nn.Dropout(dropout)

    def forward(self, queries, keys, values, valid_lens):
        queries, keys = self.W_q(queries), self.W_k(keys)
        # After dimension expansion, shape of queries: (batch_size, no. of
        # queries, 1, num_hiddens) and shape of keys: (batch_size, 1, no. of
        # key-value pairs, num_hiddens). Sum them up with broadcasting
        features = queries.unsqueeze(2) + keys.unsqueeze(1)
        features = torch.tanh(features)
        # There is only one output of self.w_v, so we remove the last
        # one-dimensional entry from the shape. Shape of scores: (batch_size,
        # no. of queries, no. of key-value pairs)
        scores = self.w_v(features).squeeze(-1)
        self.attention_weights = masked_softmax(scores, valid_lens)
        # Shape of values: (batch_size, no. of key-value pairs, value
        # dimension)
        return torch.bmm(self.dropout(self.attention_weights), values)
Давайте посмотрим, как работает AdditiveAttention . В нашем учебном
примере мы выбираем запросы, ключи и значения размерностей
\((2, 1, 20)\), \((2, 10, 2)\) и \((2, 10, 4)\)
соответственно. Это совпадает с нашим выбором для
DotProductAttention, за исключением того, что теперь запросы имеют
размерность \(20\). Аналогично, мы выбираем \((2, 6)\) в
качестве допустимых длин последовательностей в мини-батче.
queries = torch.normal(0, 1, (2, 1, 20))

attention = AdditiveAttention(num_hiddens=8, dropout=0.1)
attention.eval()
d2l.check_shape(attention(queries, keys, values, valid_lens), (2, 1, 4))
При рассмотрении функции внимания мы наблюдаем поведение, которое
качественно весьма похоже на поведение DotProductAttention. То есть
ненулевыми являются только те элементы, которые находятся в пределах
выбранной допустимой длины \((2, 6)\).
d2l.show_heatmaps(attention.attention_weights.reshape((1, 1, 2, 10)),
                  xlabel='Keys', ylabel='Queries')
11.3.5. Итоги
В этом разделе мы рассмотрели две основные функции оценки внимания: на основе скалярного произведения и аддитивное. Они являются эффективными инструментами для агрегации данных в последовательностях переменной длины. В частности, внимание на основе скалярного произведения составляет основу современных архитектур трансформеров. Когда запросы и ключи имеют разную длину, можно использовать функцию оценки на основе аддитивного внимания. Оптимизация этих слоёв является одним из ключевых направлений прогресса в последние годы. Например, библиотека Transformer от NVIDIA и Megatron (Shoeybi et al., 2019) критически зависят от эффективных вариантов механизма внимания. Мы подробно рассмотрим этот вопрос при изучении трансформеров в последующих разделах.
11.3.6. Упражнения
Реализуйте внимание на основе расстояний, изменив код
DotProductAttention. Обратите внимание, что для эффективной реализации достаточно знать только квадратные нормы ключей \(\|\mathbf{k}_i\|^2\).Модифицируйте внимание на основе скалярного произведения, чтобы разрешить использование запросов и ключей разной размерности, применяя матрицу для приведения размерностей.
Как вычислительная стоимость зависит от размерности ключей, запросов и значений, а также от их количества? Как обстоят дела с требованиями к пропускной способности памяти?