
19.1. Что такое оптимизация гиперпараметров?
Как мы видели в предыдущих главах, глубокие нейронные сети содержат большое количество параметров или весов, которые обучаются в процессе обучения. Помимо них, каждая нейронная сеть имеет дополнительные гиперпараметры, которые необходимо настраивать пользователю. Например, чтобы обеспечить сходимость стохастического градиентного спуска к локальному оптимуму функции потерь на обучающих данных (см. Section 12), нам нужно настроить скорость обучения и размер батча. Чтобы избежать переобучения на обучающих данных, возможно, потребуется задать параметры регуляризации, такие как затухание весов (см. Section 3.7) или дропаут (см. Section 5.6). Мы можем определить емкость и индуктивное смещение модели, задав количество слоёв и количество нейронов или фильтров в каждом слое (т. е. эффективное количество весов).
К сожалению, мы не можем просто настраивать эти гиперпараметры, минимизируя функцию потерь на обучающих данных, поскольку это приведёт к переобучению на обучающих данных. Например, установка параметров регуляризации, таких как дропаут или затухание весов, равными нулю, приводит к малому значению функции потерь на обучающих данных, но может ухудшить обобщающую способность.
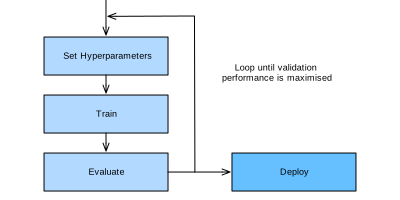
Fig. 19.1.1 Типичный рабочий процесс в машинном обучении, состоящий из многократного обучения модели с различными гиперпараметрами.
Без применения иных форм автоматизации гиперпараметры приходится
настраивать вручную методом проб и ошибок, что делает этот процесс
трудоёмкой и сложной частью рабочих процессов машинного обучения.
Например, рассмотрим обучение модели ResNet (см. Section 8.6)
на наборе данных CIFAR-10, что занимает более двух часов на экземпляре
Amazon Elastic Cloud Compute (EC2) g4dn.xlarge. Даже если просто
последовательно проверить десять конфигураций гиперпараметров, это
займёт примерно один день. Ситуацию усугубляет то, что гиперпараметры
обычно не переносятся напрямую между различными архитектурами и наборами
данных (Bardenet et al., 2013, Feurer et al., 2022, Wistuba et al., 2018), и их
необходимо заново оптимизировать для каждой новой задачи. Кроме того,
для большинства гиперпараметров не существует универсальных правил, и
для поиска разумных значений требуются экспертные знания.
Алгоритмы оптимизации гиперпараметров (HPO) предназначены для решения этой задачи систематическим и автоматизированным способом (Feurer and Hutter, 2018), сводя её к задаче глобальной оптимизации. Целевой функцией по умолчанию является ошибка на отложенном валидационном наборе данных, но в принципе это может быть любой другой бизнес-показатель. Её можно комбинировать с дополнительными целями или ограничивать ими, такими как время обучения, время вывода или сложность модели.
В последнее время оптимизация гиперпараметров была расширена до поиска нейронной архитектуры (NAS) (Elsken et al., 2018, Wistuba et al., 2019), где цель заключается в поиске совершенно новых архитектур нейронных сетей. По сравнению с классической оптимизацией гиперпараметров, NAS требует ещё больших вычислительных затрат и дополнительных усилий, чтобы оставаться практически применимой. И оптимизация гиперпараметров, и поиск нейронной архитектуры можно рассматривать как подразделы AutoML (Hutter et al., 2019), который стремится автоматизировать весь конвейер машинного обучения.
В этом разделе мы представим оптимизацию гиперпараметров (HPO) и покажем, как автоматически найти наилучшие гиперпараметры для примера логистической регрессии, представленного в Section 4.5.
19.1.1. Задача оптимизации
Рассмотрим простую учебную задачу: поиск оптимальной скорости обучения
для модели многоклассовой логистической регрессии SoftmaxRegression
в диапазоне от Section 4.5, который минимизирует
ошибку валидации на наборе данных Fashion MNIST. Хотя настройке подлежат
и другие гиперпараметры, такие как размер батча или количество эпох, для
простоты мы сосредоточимся исключительно на скорости обучения.
import numpy as np
import torch
from scipy import stats
from torch import nn
from d2l import torch as d2l
Прежде чем запускать HPO, необходимо определить два компонента: целевую функцию и пространство конфигураций.
19.1.1.1. Целевая функция
Производительность алгоритма машинного обучения можно рассматривать как функцию \(f: \mathcal{X} \rightarrow \mathbb{R}\), отображающую пространство гиперпараметров \(\mathbf{x} \in \mathcal{X}\) в значение функции потерь на валидационной выборке. Для каждой оценки \(f(\mathbf{x})\) нам необходимо обучать и проверять нашу модель машинного обучения, что может быть ресурсоемким процессом с точки зрения времени и вычислений, особенно для глубоких нейронных сетей, обучаемых на больших наборах данных. При заданном критерии \(f(\mathbf{x})\) наша цель — найти \(\mathbf{x}_{\star} \in \mathrm{argmin}_{\mathbf{x} \in \mathcal{X}} f(\mathbf{x})\).
Не существует простого способа вычислить градиенты \(f\) по \(\mathbf{x}\), поскольку это потребовало бы распространения градиента через весь процесс обучения. Хотя в недавних работах (Franceschi et al., 2017, Maclaurin et al., 2015) предпринимались попытки оптимизации гиперпараметров с помощью приближённых «гиперградиентов», ни один из существующих подходов пока не конкурирует с передовыми методами, поэтому мы не будем их обсуждать. Кроме того, вычислительная нагрузка при оценке \(f\) требует, чтобы алгоритмы оптимизации гиперпараметров приближались к глобальному оптимуму, используя как можно меньше выборок.
Обучение нейронных сетей является стохастическим (например, веса инициализируются случайным образом, мини-выборки выбираются случайным образом), поэтому наши наблюдения будут зашумленными: \(y \sim f(\mathbf{x}) + \epsilon\), где мы обычно предполагаем, что шум наблюдения \(\epsilon \sim N(0, \sigma)\) имеет гауссовское распределение.
Столкнувшись со всеми этими проблемами, мы обычно стараемся быстро найти небольшой набор конфигураций гиперпараметров, обеспечивающих высокую производительность, вместо того чтобы точно достигать глобального оптимума. Однако из-за высоких вычислительных затрат, необходимых для большинства моделей нейронных сетей, даже эта задача может занять дни или недели вычислений. В Section 19.4 мы рассмотрим, как можно ускорить процесс оптимизации, либо распределяя поиск, либо используя более дешёвые аппроксимации целевой функции.
Начнем с метода вычисления ошибки валидации модели.
class HPOTrainer(d2l.Trainer):  #@save
    def validation_error(self):
        self.model.eval()
        accuracy = 0
        val_batch_idx = 0
        for batch in self.val_dataloader:
            with torch.no_grad():
                x, y = self.prepare_batch(batch)
                y_hat = self.model(x)
                accuracy += self.model.accuracy(y_hat, y)
            val_batch_idx += 1
        return 1 -  accuracy / val_batch_idx
Мы оптимизируем ошибку валидации по конфигурации гиперпараметров
config, состоящей из learning_rate. Для каждой оценки мы обучаем
модель в течение max_epochs эпох, затем вычисляем и возвращаем её
ошибку валидации:
def hpo_objective_softmax_classification(config, max_epochs=8):
    learning_rate = config["learning_rate"]
    trainer = d2l.HPOTrainer(max_epochs=max_epochs)
    data = d2l.FashionMNIST(batch_size=16)
    model = d2l.SoftmaxRegression(num_outputs=10, lr=learning_rate)
    trainer.fit(model=model, data=data)
    return trainer.validation_error().detach().numpy()
19.1.1.2. Пространство конфигураций
Наряду с целевой функцией \(f(\mathbf{x})\), нам также необходимо определить допустимое множество \(\mathbf{x} \in \mathcal{X}\), по которому производится оптимизация, известное как пространство конфигураций или пространство поиска. Для нашего примера логистической регрессии мы будем использовать:
config_space = {"learning_rate": stats.loguniform(1e-4, 1)}
Здесь мы используем объект loguniform из SciPy, который представляет
равномерное распределение в логарифмическом пространстве на интервале от
-4 до -1. Этот объект позволяет нам брать примеры случайных величин из
этого распределения.
Каждый гиперпараметр имеет тип данных, например float для
learning_rate, а также замкнутый ограниченный диапазон (то есть
нижнюю и верхнюю границы). Обычно мы задаём априорное распределение
(например, равномерное или логарифмически равномерное) для каждого
гиперпараметра, чтобы делать из него выборку. Некоторые положительные
параметры, такие как learning_rate, лучше представлять в
логарифмическом масштабе, поскольку оптимальные значения могут
отличаться на несколько порядков, тогда как другие, такие как импульс,
имеют линейный масштаб.
- Ниже приведен простой пример пространства конфигураций, состоящего из типичных гиперпараметров многослойного перцептрона, включая их типы и стандартные диапазоны.
Пример пространства конфигураций многослойного перцептрона
Имя |
Тип |
Диапазоны гиперпараметров |
логарифмический масштаб |
|---|---|---|---|
скорость обучения |
float |
\([10^{-6},10^{-1}]\) |
да |
размер батча |
целое число |
\([8,256]\) |
да |
импульс |
float |
\([0,0.99]\) |
нет |
функция активации |
категориальный |
\(\{\textrm{tanh}, \textrm{relu}\}\) |
|
количество единиц |
целое число |
\([32, 1024]\) |
да |
количество слоёв |
целое число |
\([1, 6]\) |
нет |
В общем случае структура пространства конфигураций \(\mathcal{X}\) может быть сложной и существенно отличаться от \(\mathbb{R}^d\). На практике некоторые гиперпараметры могут зависеть от значений других. Например, предположим, что мы пытаемся подобрать количество слоёв для многослойного перцептрона и количество нейронов в каждом слое. Количество нейронов в \(l\textrm{-th}\) слое имеет смысл только в том случае, если сеть имеет как минимум \(l+1\) слоёв. Эти сложные задачи оптимизации гиперпараметров выходят за рамки данной главы. Заинтересованных читателей отсылаем к (Baptista and Poloczek, 2018, Hutter et al., 2011, Jenatton et al., 2017).
Пространство конфигураций играет важную роль в оптимизации гиперпараметров, поскольку ни один алгоритм не может найти то, что не входит в пространство конфигураций. С другой стороны, если диапазоны слишком велики, вычислительные затраты на поиск хорошо работающих конфигураций могут стать нереалистичными.
19.1.2. Случайный поиск
Случайный поиск — это первый алгоритм оптимизации гиперпараметров, который мы рассмотрим. Основная идея случайного поиска заключается в независимой выборке из пространства конфигураций до тех пор, пока не будет исчерпан заранее заданный бюджет (например, максимальное число итераций), после чего возвращается лучшая из наблюдаемых конфигураций. Все оценки могут выполняться независимо и параллельно (см. Section 19.3), но здесь для простоты мы используем последовательный цикл.
errors, values = [], []
num_iterations = 5

for i in range(num_iterations):
    learning_rate = config_space["learning_rate"].rvs()
    print(f"Trial {i}: learning_rate = {learning_rate}")
    y = hpo_objective_softmax_classification({"learning_rate": learning_rate})
    print(f"    validation_error = {y}")
    values.append(learning_rate)
    errors.append(y)
Наилучшей скоростью обучения считается та, которая обеспечивает наименьшую ошибку на валидационной выборке.
best_idx = np.argmin(errors)
print(f"optimal learning rate = {values[best_idx]}")
Благодаря простоте и общности, случайный поиск является одним из наиболее часто используемых алгоритмов настройки гиперпараметров (HPO). Он не требует сложной реализации и может применяться к любому пространству конфигураций, если для каждого гиперпараметра можно задать распределение вероятностей.
К сожалению, случайный поиск также имеет ряд недостатков. Во-первых, он не адаптирует распределение выборки на основе предыдущих наблюдений, собранных на данный момент. Следовательно, вероятность выбрать пример конфигурации с низкой производительностью такая же, как и пример конфигурации с высокой производительностью. Во-вторых, на все конфигурации тратится одинаковый объём ресурсов, даже если некоторые из них демонстрируют низкую начальную производительность и имеют меньшую вероятность превзойти ранее встречавшиеся конфигурации.
В следующих разделах мы рассмотрим алгоритмы оптимизации гиперпараметров, более эффективные с точки зрения использования примеров, которые преодолевают недостатки случайного поиска за счёт использования модели для направления поиска. Мы также рассмотрим алгоритмы, которые автоматически останавливают процесс оценки конфигураций с низкой производительностью, чтобы ускорить процесс оптимизации.
19.1.3. Резюме
В этом разделе мы ввели понятие оптимизации гиперпараметров (HPO) и показали, как её можно сформулировать как задачу глобальной оптимизации, определив пространство конфигураций и целевую функцию. Мы также реализовали наш первый алгоритм HPO — случайный поиск — и применили его к простой задаче классификации с использованием софтмакс.
Хотя случайный поиск очень прост, он является лучшей альтернативой сеточному поиску, который просто оценивает фиксированный набор гиперпараметров. Случайный поиск несколько смягчает проклятие размерности (Bellman, 1966) и может быть гораздо более эффективным, чем сеточный поиск, если критерий в наибольшей степени зависит от небольшого подмножества гиперпараметров.
19.1.4. Упражнения
В этой главе мы оптимизируем ошибку валидации модели после обучения на отдельной обучающей выборке. Для простоты наш код использует
Trainer.val_dataloader, который отображается на загрузчик дляFashionMNIST.val.Убедитесь (посмотрев на код), что это означает использование оригинальной обучающей выборки FashionMNIST (60000 примеров) для обучения, а оригинальной тестовой выборки (10000 примеров) — для валидации.
Почему такая практика может быть проблематичной? Подсказка: перечитайте Section 3.6, особенно раздел о выборе модели.
Что нам следовало сделать вместо этого?
Мы указали выше, что оптимизация гиперпараметров с помощью градиентного спуска является очень сложной задачей. Рассмотрим небольшую задачу, например, обучение двухслойного перцептрона на наборе данных FashionMNIST (Section 5.2) с размером батча 256. Мы хотим подобрать скорость обучения для SGD таким образом, чтобы минимизировать метрику валидации после одной эпохи обучения.
Почему мы не можем использовать ошибку на валидационной выборке для этой цели? Какую метрику на валидационной выборке вы бы использовали?
Набросайте (примерно) вычислительный граф метрики валидации после одной эпохи обучения. Можно считать, что начальные веса и гиперпараметры (например, скорость обучения) являются входными узлами этого графа. Подсказка: перечитайте раздел о вычислительных графах в Section 5.3.
Дайте приблизительную оценку количества чисел с плавающей запятой, которые необходимо хранить во время прямого прохода по этому графу. Подсказка: в наборе данных FashionMNIST содержится 60 000 примеров. Предположите, что требуемая память определяется преимущественно активациями после каждого слоя, и найдите ширину слоёв в Section 5.2.
Помимо огромных вычислительных ресурсов и требований к объёму хранилища, с какими другими проблемами может столкнуться оптимизация гиперпараметров на основе градиентов? Подсказка: перечитайте раздел о затухании и взрыве градиентов в Section 5.4.
Продвинутый: Прочитайте (Maclaurin et al., 2015), чтобы ознакомиться с элегантным (хотя и всё ещё несколько непрактичным) подходом к градиентной оптимизации гиперпараметров (HPO).
Поиск по сетке — это ещё одно базовое решение для HPO, при котором для каждого гиперпараметра задаётся равноотстоящая сетка, а затем перебирается (комбинаторное) декартово произведение, чтобы предложить конфигурации.
Мы указали выше, что случайный поиск может быть гораздо более эффективным, чем поиск по сетке, для настройки гиперпараметров при их большом количестве, если целевая функция наиболее сильно зависит от небольшого подмножества гиперпараметров. Почему это так? Подсказка: см. (Bergstra et al., 2011).