
22.3. Дифференциальное исчисление одной переменной
В Section 2.4 мы рассмотрели основные элементы дифференциального исчисления. В этом разделе мы подробнее разберем фундаментальные основы исчисления и то, как мы можем понимать и применять их в контексте машинного обучения.
22.3.1. Дифференциальное исчисление
Дифференциальное исчисление — это, по сути, изучение поведения функций при малых изменениях. Чтобы понять, почему это так важно для глубокого обучения, рассмотрим пример.
Предположим, что у нас есть глубокая нейронная сеть, веса которой для удобства объединены в один вектор \(\mathbf{w} = (w_1, \ldots, w_n)\). Имея набор данных для обучения, мы рассматриваем потери нашей нейронной сети на этом наборе данных, которые будем обозначать как \(\mathcal{L}(\mathbf{w})\).
Эта функция обладает чрезвычайной сложностью, так как она кодирует производительность всех возможных моделей заданной архитектуры на этом наборе данных, поэтому практически невозможно определить, какой именно набор весов \(\mathbf{w}\) минимизирует функцию потерь. Таким образом, на практике мы часто начинаем с случайной инициализации весов, а затем итеративно делаем небольшие шаги в направлении, обеспечивающем наиболее быстрое уменьшение функции потерь.
Вопрос сводится к не менее сложной задаче: как найти направление, в котором веса уменьшаются максимально быстро? Чтобы разобраться в этом, сначала рассмотрим случай с одним единственным весом: \(L(\mathbf{w}) = L(x)\) для одного действительного значения \(x\).
Рассмотрим \(x\) и попробуем понять, что происходит, когда мы изменяем его на небольшую величину, получая \(x + \epsilon\). Для наглядности можно взять конкретное число, например \(\epsilon = 0.0000001\). Чтобы лучше представить происходящее, построим график примера функции \(f(x) = \sin(x^x)\) на отрезке \([0, 3]\).
%matplotlib inline
import torch
from IPython import display
from d2l import torch as d2l

torch.pi = torch.acos(torch.zeros(1)).item() * 2  # Define pi in torch

# Plot a function in a normal range
x_big = torch.arange(0.01, 3.01, 0.01)
ys = torch.sin(x_big**x_big)
d2l.plot(x_big, ys, 'x', 'f(x)')
На таком крупном масштабе поведение функции не является простым. Однако, если мы уменьшим диапазон до чего-то меньшего, например, \([1.75,2.25]\), мы увидим, что график становится гораздо проще.
# Plot a the same function in a tiny range
x_med = torch.arange(1.75, 2.25, 0.001)
ys = torch.sin(x_med**x_med)
d2l.plot(x_med, ys, 'x', 'f(x)')
Доведя это до крайности, если мы увеличим масштаб до крошечного отрезка, поведение становится гораздо проще: это просто прямая линия.
# Plot a the same function in a tiny range
x_small = torch.arange(2.0, 2.01, 0.0001)
ys = torch.sin(x_small**x_small)
d2l.plot(x_small, ys, 'x', 'f(x)')
Это ключевое наблюдение дифференциального исчисления одной переменной: поведение привычных функций может быть аппроксимировано прямой на достаточно малом промежутке. Это означает, что для большинства функций разумно ожидать, что при небольшом сдвиге значения \(x\) функции её выходное значение \(f(x)\) также изменится незначительно. Единственный вопрос, на который нам нужно ответить: «Насколько велико изменение выходного значения по сравнению с изменением входного? Оно в два раза меньше? В два раза больше?»
Таким образом, мы можем рассмотреть отношение изменения выходного значения функции к малому изменению её входного значения. Формально это записывается как
Этого уже достаточно, чтобы начать экспериментировать с этим в коде. Например, предположим, что мы знаем, что \(L(x) = x^{2} + 1701(x-4)^3\), тогда мы можем увидеть, каково это значение в точке \(x = 4\), следующим образом.
# Define our function
def L(x):
    return x**2 + 1701*(x-4)**3

# Print the difference divided by epsilon for several epsilon
for epsilon in [0.1, 0.001, 0.0001, 0.00001]:
    print(f'epsilon = {epsilon:.5f} -> {(L(4+epsilon) - L(4)) / epsilon:.5f}')
Теперь, если мы внимательны, то заметим, что выходное значение подозрительно близко к \(8\). Действительно, если мы уменьшим \(\epsilon\), то увидим, что значение становится всё ближе к \(8\). Таким образом, мы можем правильно заключить, что искомое значение (степень, с которой изменение входа влияет на выход) должно быть равно \(8\) в точке \(x=4\). Математики кодируют этот факт следующим образом
В качестве небольшого исторического отступления: в первые десятилетия исследований нейронных сетей учёные использовали этот алгоритм (метод конечных разностей) для оценки того, как меняется функция потерь при небольших возмущениях: достаточно было изменить веса и посмотреть, как изменились потери. Этот подход вычислительно неэффективен, так как требует двух вычислений функции потерь, чтобы понять, как одно изменение одной переменной повлияло на потери. Если бы мы попытались применить это к модели хотя бы с несколькими тысячами параметров, потребовалось бы несколько тысяч вычислений сети по всему набору данных! Проблема была решена лишь в 1986 году, когда алгоритм обратного распространения ошибки, описанный в Rumelhart et al. (1988), предложил способ вычисления того, как любое изменение весов совместно влияет на потери, за то же время, которое требуется для одного прямого прохода сети по набору данных.
Вернёмся к нашему примеру: это значение \(8\) различается в зависимости от значений \(x\), поэтому логично определить его как функцию от \(x\). Более строго, эта зависящая от значения скорость изменения называется производной, которая обозначается как
В разных текстах используются различные обозначения для производной. Например, все приведённые ниже обозначения указывают на одно и то же:
Большинство авторов выбирают одну нотацию и придерживаются её, однако даже это не гарантировано. Лучше всего быть знакомым со всеми этими вариантами. В этом тексте мы будем использовать нотацию \(\frac{df}{dx}\), за исключением случаев, когда нужно вычислить производную сложного выражения; в таких случаях мы будем использовать \(\frac{d}{dx}f\) для записи выражений вида
Зачастую интуитивно полезно вернуться к определению производной (22.3.3), чтобы понять, как изменяется функция при небольшом изменении \(x\):
Последнее уравнение заслуживает отдельного упоминания. Оно показывает, что если взять любую функцию и изменить её входное значение на малую величину, то выходное значение изменится на эту малую величину, умноженную на производную.
Таким образом, мы можем понимать производную как масштабный коэффициент, который показывает, насколько сильно изменится выходное значение при изменении входного.
22.3.2. Правила дифференцирования
Теперь мы переходим к задаче вычисления производной явной функции. Полное формальное изложение математического анализа выводило бы все результаты из первых принципов. Мы не будем поддаваться этому искушению, а вместо этого рассмотрим основные правила, с которыми мы сталкиваемся.
22.3.2.1. Распространенные производные
Как было показано в Section 2.4, при вычислении производных часто можно использовать набор правил, позволяющих свести вычисления к нескольким базовым функциям. Мы приводим их здесь для удобства справки.
Производная константы. \(\frac{d}{dx}c = 0\).
Производная линейных функций. \(\frac{d}{dx}(ax) = a\).
Правило степени. \(\frac{d}{dx}x^n = nx^{n-1}\).
Производная экспоненты. \(\frac{d}{dx}e^x = e^x\).
Производная логарифма. \(\frac{d}{dx}\log(x) = \frac{1}{x}\).
22.3.2.2. Правила вычисления производных
Если бы каждую производную приходилось вычислять отдельно и хранить в таблице, дифференциальное исчисление было бы практически невозможным. Математика дарует нам возможность обобщить приведённые выше производные и вычислять более сложные, например, производную от \(f(x) = \log\left(1+(x-1)^{10}\right)\). Как упоминалось в Section 2.4, ключ к этому заключается в формализации правил поведения при комбинировании функций различными способами, наиболее важными из которых являются сложение, умножение и композиция.
Правило суммы. \(\frac{d}{dx}\left(g(x) + h(x)\right) = \frac{dg}{dx}(x) + \frac{dh}{dx}(x)\).
Правило произведения. \(\frac{d}{dx}\left(g(x)\cdot h(x)\right) = g(x)\frac{dh}{dx}(x) + \frac{dg}{dx}(x)h(x)\).
Цепное правило. \(\frac{d}{dx}g(h(x)) = \frac{dg}{dh}(h(x))\cdot \frac{dh}{dx}(x)\).
Давайте посмотрим, как мы можем использовать (22.3.6) для понимания этих правил. Для правила суммы рассмотрим следующую цепочку рассуждений:
Сравнивая этот результат с тем, что \(f(x+\epsilon) \approx f(x) + \epsilon \frac{df}{dx}(x)\), мы видим, что \(\frac{df}{dx}(x) = \frac{dg}{dx}(x) + \frac{dh}{dx}(x)\), как и требовалось. Интуитивно это означает: при изменении входа \(x\), величины \(g\) и \(h\) совместно определяют изменение выхода на \(\frac{dg}{dx}(x)\) и \(\frac{dh}{dx}(x)\).
Произведение более тонкое, и потребует нового замечания о том, как работать с этими выражениями. Мы начнем, как и раньше, используя (22.3.6):
Это напоминает вычисления, приведённые выше, и действительно, мы видим наш ответ (\(\frac{df}{dx}(x) = g(x)\frac{dh}{dx}(x) + \frac{dg}{dx}(x)h(x)\)) рядом с \(\epsilon\), но возникает вопрос относительно члена порядка \(\epsilon^{2}\). Мы будем называть его членом высшего порядка, поскольку степень \(\epsilon^2\) выше, чем степень \(\epsilon^1\). В более позднем разделе мы увидим, что иногда нам нужно отслеживать такие члены, однако сейчас заметим, что если \(\epsilon = 0.0000001\), то \(\epsilon^{2}= 0.0000000000001\), что значительно меньше. При стремлении \(\epsilon \rightarrow 0\) мы можем безопасно игнорировать члены высшего порядка. В качестве общего соглашения в этом приложении мы будем использовать «\(\approx\)» для обозначения того, что два члена равны с точностью до членов высшего порядка. Однако, если мы хотим быть более строгими, мы можем рассмотреть разностное отношение
и увидим, что при стремлении \(\epsilon \rightarrow 0\) правая часть также стремится к нулю.
Наконец, используя цепное правило, мы можем снова двигаться вперёд, как и раньше, применяя (22.3.6), и видим, что
где во второй строке мы рассматриваем функцию \(g\) так, что её аргумент (\(h(x)\)) сдвинут на малую величину \(\epsilon \frac{dh}{dx}(x)\).
Эти правила предоставляют нам гибкий набор инструментов для вычисления практически любого требуемого выражения. Например,
Где каждая строка использует следующие правила:
Цепное правило и производная логарифма.
Правило суммы.
Производные констант, цепное правило и правило степени.
Правило суммы, производная линейных функций, производная констант.
Два момента должны быть ясны после выполнения этого примера:
Производную любой функции, которую можно записать с помощью сумм, произведений, констант, степеней, экспонент и логарифмов, можно вычислить механически, следуя этим правилам.
Следовать этим правилам вручную может быть утомительно и чревато ошибками!
К счастью, эти два факта вместе указывают на путь вперед: это идеальный кандидат для автоматизации! Действительно, обратное распространение ошибки, которое мы рассмотрим позже в этом разделе, является именно тем, что нужно.
22.3.2.3. Линейное приближение
При работе с производными часто полезно геометрически интерпретировать приближение, использованное выше. В частности, отметим, что уравнение
приближает значение \(f\) прямой, проходящей через точку \((x, f(x))\) и имеющей угловой коэффициент \(\frac{df}{dx}(x)\). Таким образом, мы говорим, что производная даёт линейное приближение функции \(f\), как показано ниже:
# Compute sin
xs = torch.arange(-torch.pi, torch.pi, 0.01)
plots = [torch.sin(xs)]

# Compute some linear approximations. Use d(sin(x))/dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(torch.sin(torch.tensor(x0)) + (xs - x0) *
                 torch.cos(torch.tensor(x0)))

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
22.3.2.4. Производные высших порядков
Давайте теперь сделаем то, что на первый взгляд может показаться странным. Возьмем функцию \(f\) и вычислим производную \(\frac{df}{dx}\). Это даст нам скорость изменения \(f\) в любой точке.
Однако производная, \(\frac{df}{dx}\), сама по себе является функцией, поэтому ничто не мешает нам вычислить производную от \(\frac{df}{dx}\), чтобы получить \(\frac{d^2f}{dx^2} = \frac{df}{dx}\left(\frac{df}{dx}\right)\). Мы будем называть это второй производной от \(f\). Эта функция показывает, как изменяется скорость изменения от \(f\), или, иными словами, как меняется сама скорость изменения. Мы можем применять дифференцирование любое число раз, чтобы получить так называемую \(n\)-ю производную. Чтобы сохранить запись лаконичной, будем обозначать \(n\)-ю производную как
Давайте разберемся, почему это полезное понятие. Ниже мы визуализируем \(f^{(2)}(x)\), \(f^{(1)}(x)\) и \(f(x)\).
Сначала рассмотрим случай, когда вторая производная \(f^{(2)}(x)\) является положительной константой. Это означает, что наклон первой производной положителен. В результате первая производная \(f^{(1)}(x)\) может начинаться с отрицательного значения, становиться равной нулю в некоторой точке, а затем становиться положительной. Это говорит нам о том, что наклон нашей исходной функции \(f\), а следовательно, и сама функция \(f\), сначала убывает, затем выравнивается, а после начинает возрастать. Иными словами, функция \(f\) выпукла вниз и имеет единственную точку минимума, как показано на рисунке Fig. 22.3.1.
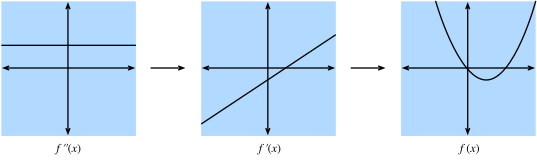
Fig. 22.3.1 Если предположить, что вторая производная является положительной константой, то первая производная возрастает, что означает наличие у самой функции минимума.
Во-вторых, если вторая производная является отрицательной константой, это означает, что первая производная убывает. Это подразумевает, что первая производная может начинаться с положительного значения, стать равной нулю в некоторой точке, а затем стать отрицательной. Следовательно, функция \(f\) сначала возрастает, затем выполаживается, а после убывает. Иными словами, функция \(f\) вогнута вниз и имеет единственный максимум, как показано на рисунке Fig. 22.3.2.
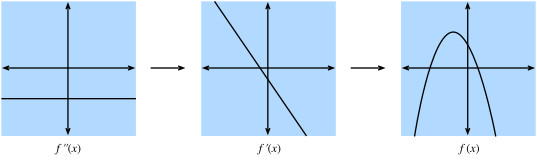
Fig. 22.3.2 Если предположить, что вторая производная является отрицательной константой, то первая производная убывает, что означает наличие у самой функции максимума.
В-третьих, если вторая производная всегда равна нулю, то первая производная никогда не изменяется — она постоянна! Это означает, что \(f\) увеличивается (или уменьшается) с постоянной скоростью, а \(f\) является прямой линией, как показано на рисунке Fig. 22.3.3.
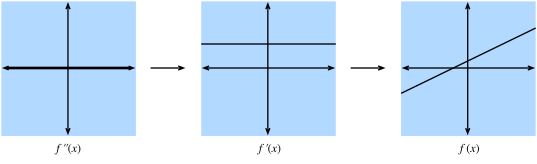
Fig. 22.3.3 Если предположить, что вторая производная равна нулю, то первая производная постоянна, что означает, что сама функция является прямой линией.
Подводя итог, вторую производную можно интерпретировать как описывающую способ, которым функция \(f\) искривляется. Положительная вторая производная приводит к искривлению вверх, тогда как отрицательная вторая производная означает, что \(f\) искривляется вниз, а нулевая вторая производная означает, что \(f\) вообще не искривляется.
Давайте сделаем ещё один шаг. Рассмотрим функцию \(g(x) = ax^{2}+ bx + c\). Тогда мы можем вычислить
Если мы рассматриваем некоторую исходную функцию \(f(x)\), то можем вычислить первые две производные и найти значения для \(a, b\) и \(c\), которые обеспечат совпадение с этим вычислением. Аналогично тому, как в предыдущем разделе мы видели, что первая производная даёт наилучшее приближение прямой линией, данная конструкция обеспечивает наилучшее приближение квадратичной функцией. Давайте визуализируем это для \(f(x) = \sin(x)\).
# Compute sin
xs = torch.arange(-torch.pi, torch.pi, 0.01)
plots = [torch.sin(xs)]

# Compute some quadratic approximations. Use d(sin(x)) / dx = cos(x)
for x0 in [-1.5, 0.0, 2.0]:
    plots.append(torch.sin(torch.tensor(x0)) + (xs - x0) *
                 torch.cos(torch.tensor(x0)) - (xs - x0)**2 *
                 torch.sin(torch.tensor(x0)) / 2)

d2l.plot(xs, plots, 'x', 'f(x)', ylim=[-1.5, 1.5])
В следующем разделе мы расширим эту идею до понятия ряда Тейлора.
22.3.2.5. Ряд Тейлора
Ряд Тейлора позволяет аппроксимировать функцию \(f(x)\), если известны значения первых \(n\) производных в точке \(x_0\), то есть \(\left\{ f(x_0), f^{(1)}(x_0), f^{(2)}(x_0), \ldots, f^{(n)}(x_0) \right\}\). Идея состоит в том, чтобы найти многочлен степени \(n\), совпадающий со всеми заданными производными в точке \(x_0\).
Мы рассмотрели случай \(n=2\) в предыдущем разделе, и несложные алгебраические преобразования показывают, что это
Как видно выше, знаменатель \(2\) нужен, чтобы сократить \(2\), который получается при взятии двух производных от \(x^2\), тогда как остальные члены равны нулю. Та же логика применима к первой производной и самому значению.
Если мы продолжим эту логику до \(n=3\), то придем к выводу, что
где \(6 = 3 \times 2 = 3!\) получается из константы, стоящей перед нами, если взять три производные от \(x^3\).
Кроме того, мы можем получить многочлен степени \(n\), используя
где обозначение
Действительно, \(P_n(x)\) можно рассматривать как наилучшее приближение функции \(f(x)\) многочленом степени \(n\).
Хотя мы не будем подробно разбирать погрешность приведённых выше приближений, стоит упомянуть предельный случай бесконечного числа членов. В этом случае для хорошо ведущих себя функций (так называемых вещественно-аналитических функций), таких как \(\cos(x)\) или \(e^{x}\), мы можем записать бесконечное число членов и точно аппроксимировать исходную функцию.
Возьмем \(f(x) = e^{x}\) в качестве примера. Поскольку \(e^{x}\) является своей собственной производной, мы знаем, что \(f^{(n)}(x) = e^{x}\). Следовательно, \(e^{x}\) можно восстановить с помощью ряда Тейлора в точке \(x_0 = 0\), т. е.
Давайте посмотрим, как это работает в коде, и убедимся, что увеличение степени аппроксимации Тейлора позволяет нам всё ближе подбираться к целевой функции \(e^x\).
# Compute the exponential function
xs = torch.arange(0, 3, 0.01)
ys = torch.exp(xs)

# Compute a few Taylor series approximations
P1 = 1 + xs
P2 = 1 + xs + xs**2 / 2
P5 = 1 + xs + xs**2 / 2 + xs**3 / 6 + xs**4 / 24 + xs**5 / 120

d2l.plot(xs, [ys, P1, P2, P5], 'x', 'f(x)', legend=[
    "Exponential", "Degree 1 Taylor Series", "Degree 2 Taylor Series",
    "Degree 5 Taylor Series"])
Ряды Тейлора имеют два основных применения:
Теоретические применения: Часто, когда мы пытаемся понять слишком сложную функцию, использование ряда Тейлора позволяет свести её к многочлену, с которым мы можем работать напрямую.
Численные приложения: Некоторые функции, такие как \(e^{x}\) или \(\cos(x)\), сложно вычислять с помощью ЭВМ. Можно хранить таблицы значений с фиксированной точностью (что часто и делается), но это не отвечает на вопросы вроде «Какова 1000-я цифра числа \(\cos(1)\)?». Ряды Тейлора часто помогают ответить на подобные вопросы.
22.3.3. Итоги
Производные позволяют выразить, как функции изменяются при малом изменении их аргумента.
Элементарные производные можно комбинировать с помощью правил дифференцирования, чтобы получить производные произвольной сложности.
Производные можно дифференцировать повторно, чтобы получить производные второго или более высоких порядков. Каждое повышение порядка дает более детальную информацию о поведении функции.
Используя информацию из производных одного примера данных, мы можем аппроксимировать гладкие функции многочленами, полученными из ряда Тейлора.
22.3.4. Упражнения
Чему равна производная \(x^3-4x+1\)?
Чему равна производная \(\log(\frac{1}{x})\)?
Верно или неверно: если \(f'(x) = 0\), то \(f\) имеет максимум или минимум в точке \(x\)?
Где находится минимум \(f(x) = x\log(x)\) для \(x\ge0\) (где мы предполагаем, что \(f\) принимает предельное значение \(0\) при \(f(0)\))?