
10.4. Двухнаправленные рекуррентные нейронные сети
До сих пор в качестве рабочего примера задачи обучения на последовательностях мы рассматривали языковое моделирование, где цель заключается в предсказании следующего токена на основе всех предыдущих токенов в последовательности. В этом сценарии мы хотим опираться только на контекст, расположенный слева, поэтому односторонняя цепочка связей в стандартной рекуррентной нейронной сети кажется уместной. Однако существует множество других задач обучения на последовательностях, в которых вполне допустимо учитывать при предсказании на каждом временном шаге как контекст слева, так и контекст справа. Рассмотрим, например, задачу определения части речи. Почему бы нам не учитывать контекст в обоих направлениях при оценке части речи, соответствующей данному слову?
Ещё одной распространённой задачей, часто используемой в качестве этапа предобучения перед дообучением модели на конкретной целевой задаче, является маскирование случайных токенов в текстовом документе и последующее обучение последовательной модели предсказывать значения пропущенных токенов. Обратите внимание, что в зависимости от того, что следует после пропуска, вероятное значение пропущенного токена может существенно меняться:
Я
___.Я
___голоден.Я
___голоден, и я могу съесть половину свиньи.
В первом предложении слово «happy» кажется наиболее вероятным вариантом. Слова «not» и «very» выглядят правдоподобно во втором предложении, но «not» кажется несовместимым с третьим предложением.
К счастью, простой приём позволяет преобразовать любой однонаправленный RNN в двунаправленный (Schuster and Paliwal, 1997). Мы просто реализуем два однонаправленных слоя RNN, соединённых последовательно в противоположных направлениях и обрабатывающих одни и те же входные данные (Fig. 10.4.1). Для первого слоя RNN первым входом является \(\mathbf{x}_1\), а последним — \(\mathbf{x}_T\), тогда как для второго слоя RNN первым входом является \(\mathbf{x}_T\), а последним — \(\mathbf{x}_1\). Чтобы получить выходной сигнал этого двунаправленного слоя RNN, мы просто объединяем соответствующие выходные сигналы двух базовых однонаправленных слоёв RNN.
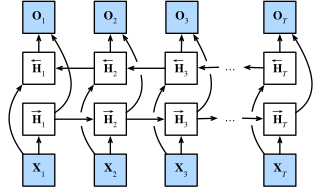
Fig. 10.4.1 Архитектура двунаправленной рекуррентной нейронной сети.
Формально для любого шага времени \(t\) рассмотрим входной мини-батч \(\mathbf{X}_t \in \mathbb{R}^{n \times d}\) (число примеров \(=n\); число входов в каждом примере \(=d\)) и обозначим функцию активации скрытого слоя как \(\phi\). В двунаправленной архитектуре прямое и обратное скрытые состояния для этого шага времени равны \(\overrightarrow{\mathbf{H}}_t \in \mathbb{R}^{n \times h}\) и \(\overleftarrow{\mathbf{H}}_t \in \mathbb{R}^{n \times h}\) соответственно, где \(h\) — число скрытых единиц. Обновление прямого и обратного скрытых состояний задается следующим образом:
где веса \(\mathbf{W}_{\textrm{xh}}^{(f)} \in \mathbb{R}^{d \times h}, \mathbf{W}_{\textrm{hh}}^{(f)} \in \mathbb{R}^{h \times h}, \mathbf{W}_{\textrm{xh}}^{(b)} \in \mathbb{R}^{d \times h}, \textrm{ and } \mathbf{W}_{\textrm{hh}}^{(b)} \in \mathbb{R}^{h \times h}\), а смещения \(\mathbf{b}_\textrm{h}^{(f)} \in \mathbb{R}^{1 \times h}\) и \(\mathbf{b}_\textrm{h}^{(b)} \in \mathbb{R}^{1 \times h}\) являются параметрами модели.
Далее мы объединяем прямые и обратные скрытые состояния \(\overrightarrow{\mathbf{H}}_t\) и \(\overleftarrow{\mathbf{H}}_t\), чтобы получить скрытое состояние \(\mathbf{H}_t \in \mathbb{R}^{n \times 2h}\) для передачи в выходной слой. В глубоких двунаправленных рекуррентных нейронных сетях с несколькими скрытыми слоями такая информация передаётся в качестве входа в следующий двунаправленный слой. Наконец, выходной слой вычисляет выход \(\mathbf{O}_t \in \mathbb{R}^{n \times q}\) (число выходов \(=q\)):
Здесь матрица весов \(\mathbf{W}_{\textrm{hq}} \in \mathbb{R}^{2h \times q}\) и смещение \(\mathbf{b}_\textrm{q} \in \mathbb{R}^{1 \times q}\) являются параметрами модели выходного слоя. Хотя технически два направления могут иметь разное количество скрытых единиц, на практике такой подход применяется редко. Теперь мы продемонстрируем простую реализацию двунаправленной рекуррентной нейронной сети.
import torch
from torch import nn
from d2l import torch as d2l
10.4.1. Реализация с нуля
Если мы хотим реализовать двунаправленный RNN с нуля, мы можем
использовать два однонаправленных RNNScratch экземпляра с отдельными
обучаемыми параметрами.
class BiRNNScratch(d2l.Module):
    def __init__(self, num_inputs, num_hiddens, sigma=0.01):
        super().__init__()
        self.save_hyperparameters()
        self.f_rnn = d2l.RNNScratch(num_inputs, num_hiddens, sigma)
        self.b_rnn = d2l.RNNScratch(num_inputs, num_hiddens, sigma)
        self.num_hiddens *= 2  # The output dimension will be doubled
Состояния прямого и обратного RNN обновляются отдельно, а их выходные данные объединяются.
@d2l.add_to_class(BiRNNScratch)
def forward(self, inputs, Hs=None):
    f_H, b_H = Hs if Hs is not None else (None, None)
    f_outputs, f_H = self.f_rnn(inputs, f_H)
    b_outputs, b_H = self.b_rnn(reversed(inputs), b_H)
    outputs = [torch.cat((f, b), -1) for f, b in zip(
        f_outputs, reversed(b_outputs))]
    return outputs, (f_H, b_H)
10.4.2. Краткая реализация
Используя высокоуровневые API, мы можем реализовать двунаправленные RNN более лаконично. В качестве примера рассмотрим модель GRU.
class BiGRU(d2l.RNN):
    def __init__(self, num_inputs, num_hiddens):
        d2l.Module.__init__(self)
        self.save_hyperparameters()
        self.rnn = nn.GRU(num_inputs, num_hiddens, bidirectional=True)
        self.num_hiddens *= 2
10.4.3. Резюме
В двунаправленных рекуррентных нейронных сетях скрытое состояние для каждого временного шага одновременно определяется данными до и после текущего шага. Двунаправленные рекуррентные нейронные сети наиболее полезны для кодирования последовательностей и оценки наблюдений при наличии двунаправленного контекста. Обучение двунаправленных рекуррентных нейронных сетей требует значительных вычислительных затрат из-за длинных цепей градиентов.
10.4.4. Упражнения
Если различные направления используют разное количество скрытых единиц, как изменится форма \(\mathbf{H}_t\)?
Разработайте двунаправленную рекуррентную нейронную сеть с несколькими скрытыми слоями.
Многозначность распространена в естественных языках. Например, слово «bank» имеет разные значения в контекстах «I went to the bank to deposit cash» и «I went to the bank to sit down». Как спроектировать модель нейронной сети, чтобы при заданной контекстной последовательности и слове возвращалось векторное представление слова в соответствующем контексте? Какие типы нейронных архитектур предпочтительнее для обработки многозначности?