
7.3. Дополнение и шаг
Вспомним пример свёртки из Fig. 7.2.1. Входные данные имели высоту и ширину, равные 3, а свёрточное ядро — высоту и ширину, равные 2, что дало выходное представление размерности \(2\times2\). Если предположить, что форма входа \(n_\textrm{h}\times n_\textrm{w}\), а форма свёрточного ядра \(k_\textrm{h}\times k_\textrm{w}\), то форма выхода будет \((n_\textrm{h}-k_\textrm{h}+1) \times (n_\textrm{w}-k_\textrm{w}+1)\): мы можем сдвигать свёрточное ядро лишь до определённого предела, пока не закончатся пиксели, к которым можно применить свёртку.
В дальнейшем мы рассмотрим ряд методов, включая дополнение и свёртки с шагом, которые позволяют более точно контролировать размер выходных данных. В качестве мотивации отметим, что поскольку ядра, как правило, имеют высоту и ширину, большие чем \(1\), после применения множества последовательных свёрток мы часто получаем выходные данные, значительно меньшие по размеру, чем входные. Если мы начнем с изображения размером \(240 \times 240\) пикселей, то десять слоёв свёрток с шагом \(5 \times 5\) уменьшат изображение до размера \(200 \times 200\) пикселей, отбрасывая \(30 \%\) пикселей изображения и тем самым уничтожая любую интересную информацию на границах исходного изображения. Дополнение является наиболее популярным инструментом для решения этой проблемы. В других случаях мы можем захотеть существенно уменьшить размерность, например, если исходное разрешение входных данных оказывается слишком громоздким. Свёртки с шагом — это популярный метод, который может помочь в таких случаях.
import torch
from torch import nn
7.3.1. Дополнение
Как описано выше, одна из сложных проблем при использовании свёрточных слоёв заключается в том, что мы обычно теряем пиксели на периферии изображения. Рассмотрим Fig. 7.3.1, который показывает использование пикселей в зависимости от размера ядра свёртки и позиции внутри изображения. Пиксели в углах практически не используются.
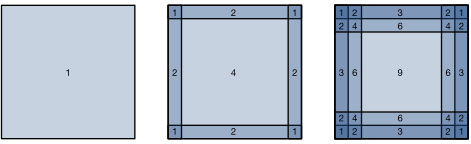
Fig. 7.3.1 Использование пикселей для свёрток размером \(1 \times 1\), \(2 \times 2\) и \(3 \times 3\) соответственно.
Поскольку мы обычно используем небольшие ядра, при каждой свёртке мы можем терять лишь несколько пикселей, но при применении множества последовательных слоёв свёртки эти потери накапливаются. Одним из простых решений этой проблемы является добавление дополнительных пикселей-заполнителей вокруг границы входного изображения, что увеличивает его эффективный размер. Обычно значения дополнительных пикселей устанавливаются равными нулю. На рисунке Fig. 7.3.2 показано заполнение входного тензора \(3 \times 3\), в результате чего его размер увеличивается до \(5 \times 5\). Соответствующий выходной тензор также увеличивается до матрицы размера \(4 \times 4\). Заштрихованные области обозначают первый выходной элемент, а также элементы входного тензора и тензора ядра, использованные для вычисления этого выхода: \(0\times0+0\times1+0\times2+0\times3=0\).
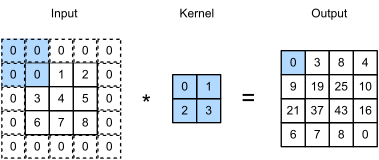
Fig. 7.3.2 Двумерная кросс-корреляция с дополнением.
В общем случае, если добавить в общей сложности \(p_\textrm{h}\) строк дополнения (примерно по половине сверху и снизу) и \(p_\textrm{w}\) столбцов дополнения (примерно по половине слева и справа), форма выходных данных будет
Это означает, что высота и ширина выхода увеличатся на \(p_\textrm{h}\) и \(p_\textrm{w}\) соответственно.
Во многих случаях мы хотим задать \(p_\textrm{h}=k_\textrm{h}-1\) и \(p_\textrm{w}=k_\textrm{w}-1\) так, чтобы высота и ширина входных и выходных данных совпадали. Это упростит предсказание формы выхода каждого слоя при построении сети. Предполагая, что \(k_\textrm{h}\) нечетно, мы добавим \(p_\textrm{h}/2\) строк с обеих сторон по высоте. Если \(k_\textrm{h}\) четно, одним из вариантов является добавление \(\lceil p_\textrm{h}/2\rceil\) строк сверху и \(\lfloor p_\textrm{h}/2\rfloor\) строк снизу. С шириной мы поступим аналогичным образом.
В свёрточных нейронных сетях обычно используются свёрточные ядра с нечётными значениями высоты и ширины, например 1, 3, 5 или 7. Выбор нечётных размеров ядра даёт преимущество: мы можем сохранять размерность данных, добавляя дополнение одинаковым количеством строк сверху и снизу, а также одинаковым количеством столбцов слева и справа.
Более того, такая практика использования нечётных ядер и дополнения для
точного сохранения размерности предоставляет административное
преимущество. Для любого двумерного тензора X, когда размер ядра
нечётный и количество строк и столбцов дополнения со всех сторон
одинаково, что приводит к получению выхода с той же высотой и шириной,
что и у входа, мы знаем, что выход Y[i, j] вычисляется путём
перекрёстной корреляции входа и ядра свёртки с окном, центрированным на
X[i, j].
В следующем примере мы создадим двумерный свёрточный слой с высотой и шириной 3 и применим дополнение в 1 пиксель со всех сторон. При входе с высотой и шириной 8 мы видим, что высота и ширина выхода также равны 8.
# We define a helper function to calculate convolutions. It initializes the
# convolutional layer weights and performs corresponding dimensionality
# elevations and reductions on the input and output
def comp_conv2d(conv2d, X):
    # (1, 1) indicates that batch size and the number of channels are both 1
    X = X.reshape((1, 1) + X.shape)
    Y = conv2d(X)
    # Strip the first two dimensions: examples and channels
    return Y.reshape(Y.shape[2:])

# 1 row and column is padded on either side, so a total of 2 rows or columns
# are added
conv2d = nn.LazyConv2d(1, kernel_size=3, padding=1)
X = torch.rand(size=(8, 8))
comp_conv2d(conv2d, X).shape
Когда высота и ширина ядра свёртки различаются, мы можем сделать выходные и входные данные одинаковыми по высоте и ширине, задав разные значения дополнения для высоты и ширины.
# We use a convolution kernel with height 5 and width 3. The padding on either
# side of the height and width are 2 and 1, respectively
conv2d = nn.LazyConv2d(1, kernel_size=(5, 3), padding=(2, 1))
comp_conv2d(conv2d, X).shape
7.3.2. Шаг
При вычислении кросс-корреляции мы начинаем с того, что размещаем окно свёртки в верхнем левом углу входного тензора, а затем перемещаем его по всем позициям вниз и вправо. В предыдущих примерах мы по умолчанию перемещали окно на один элемент за раз. Однако иногда, либо для повышения вычислительной эффективности, либо потому, что мы хотим уменьшить размерность данных, мы перемещаем окно сразу на несколько элементов, пропуская промежуточные позиции. Это особенно полезно, если ядро свёртки велико, поскольку оно захватывает большую область исходного изображения.
Количество строк и столбцов, проходимых за один сдвиг, называют шагом (stride). До сих пор мы использовали шаг, равный 1, как по высоте, так и по ширине. Иногда может потребоваться использовать больший шаг. Fig. 7.3.3 показывает двумерную операцию поперечной корреляции с шагом 3 по вертикали и 2 по горизонтали. Заштрихованные области обозначают выходные элементы, а также элементы входного тензора и тензора ядра, использованные для вычисления этих выходных значений: \(0\times0+0\times1+1\times2+2\times3=8\), \(0\times0+6\times1+0\times2+0\times3=6\). Мы видим, что при формировании второго элемента первого столбца окно свёртки сдвигается вниз на три строки. Окно свёртки сдвигается на два столбца вправо при формировании второго элемента первой строки. При дальнейшем сдвиге окна свёртки на два столбца вправо по входному тензору выход не формируется, поскольку элементы входа не заполняют окно (если только не добавить ещё один столбец дополнения).
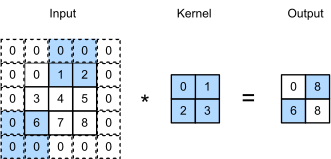
Fig. 7.3.3 Кросс-корреляция с шагом 3 по высоте и 2 по ширине соответственно.
В общем случае, когда шаг по высоте равен \(s_\textrm{h}\), а шаг по ширине равен \(s_\textrm{w}\), форма выходных данных
Если мы установим \(p_\textrm{h}=k_\textrm{h}-1\) и \(p_\textrm{w}=k_\textrm{w}-1\), то форму выходных данных можно упростить до \(\lfloor(n_\textrm{h}+s_\textrm{h}-1)/s_\textrm{h}\rfloor \times \lfloor(n_\textrm{w}+s_\textrm{w}-1)/s_\textrm{w}\rfloor\). Если высота и ширина входных данных делятся на соответствующие шаги по высоте и ширине, то форма выходных данных будет равна \((n_\textrm{h}/s_\textrm{h}) \times (n_\textrm{w}/s_\textrm{w})\).
Ниже мы зададим шаг по высоте и ширине равным 2, тем самым уменьшив высоту и ширину входных данных вдвое.
conv2d = nn.LazyConv2d(1, kernel_size=3, padding=1, stride=2)
comp_conv2d(conv2d, X).shape
Рассмотрим более сложный пример.
conv2d = nn.LazyConv2d(1, kernel_size=(3, 5), padding=(0, 1), stride=(3, 4))
comp_conv2d(conv2d, X).shape
7.3.3. Итоги и обсуждение
Дополнение может увеличивать высоту и ширину выходных данных. Это часто используется для того, чтобы выходные размеры совпадали с входными, избегая нежелательного уменьшения выходных данных. Кроме того, это гарантирует, что все пиксели используются с одинаковой частотой. Обычно мы выбираем симметричное дополнение с обеих сторон по высоте и ширине входных данных. В этом случае мы говорим о \((p_\textrm{h}, p_\textrm{w})\) дополнении. Чаще всего мы устанавливаем \(p_\textrm{h} = p_\textrm{w}\), в этом случае мы просто говорим, что выбираем дополнение \(p\).
Аналогичное соглашение применяется к шагам. Когда горизонтальный шаг \(s_\textrm{h}\) и вертикальный шаг \(s_\textrm{w}\) совпадают, мы просто говорим о шаге \(s\). Шаг может уменьшить разрешение выходных данных, например, сокращая высоту и ширину выхода до \(1/n\) от высоты и ширины входа при шаге \(n > 1\). По умолчанию дополнение равно 0, а шаг равен 1.
До сих пор мы обсуждали лишь дополнение нулями. Это дает значительные вычислительные преимущества, поскольку реализовать это крайне просто. Кроме того, операторы можно спроектировать так, чтобы они неявно использовали такое дополнение, не требуя выделения дополнительной памяти. В то же время это позволяет свёрточным нейронным сетям кодировать неявную информацию о положении внутри изображения, просто обучаясь определять, где находится «пустое пространство». Существует множество альтернатив дополнению нулями. Alsallakh et al. (2020) предоставило подробный обзор этих методов (хотя и без чёткого обоснования, когда следует использовать ненулевое дополнение, за исключением случаев возникновения артефактов).
7.3.4. Упражнения
Рассмотрим окончательный пример кода в этом разделе с размером ядра \((3, 5)\), дополнением \((0, 1)\) и шагом \((3, 4)\). Вычислите форму выходных данных, чтобы проверить, согласуется ли она с экспериментальным результатом.
Для аудиосигналов чему соответствует шаг (stride) равный 2?
Реализуйте зеркальное дополнение, т. е. дополнение, при котором граничные значения просто отражаются для расширения тензоров.
Каковы вычислительные преимущества шага, превышающего 1?
Какие статистические преимущества может дать шаг больше 1?
Как бы вы реализовали шаг \(\frac{1}{2}\)? Что это означает? Когда это может быть полезно?