
15. Обработка естественного языка: Предобучение
Люди нуждаются в общении. Из этой базовой потребности человеческого существования ежедневно генерируется огромное количество текстовой информации. Учитывая обилие текстов в социальных сетях, мессенджерах, электронной почте, отзывах на товары, новостных статьях, научных публикациях и книгах, становится жизненно важным научить компьютеры понимать их, чтобы оказывать помощь или принимать решения на основе человеческого языка.
Обработка естественного языка изучает взаимодействие между компьютерами и людьми с использованием естественных языков. На практике очень распространено применение методов обработки естественного языка для обработки и анализа текстовых данных (естественного языка человека), таких как языковые модели в Section 9.3 и модели машинного перевода в Section 10.5.
Чтобы понять текст, можно начать с изучения его представлений. Используя существующие текстовые последовательности из больших корпусов, самообучение широко применяется для предварительного обучения текстовых представлений, например, путем предсказания скрытой части текста на основе окружающего контекста. Таким образом, модели обучаются на основе огромных объёмов текстовых данных без дорогостоящих усилий по разметке!
Как мы увидим в этой главе, при рассмотрении каждого слова или подслова в качестве отдельного токена представление каждого токена может быть предобучено с помощью word2vec, GloVe или моделей эмбеддингов подслов на больших корпусах. После предобучения представление каждого токена может быть вектором, однако оно остается неизменным независимо от контекста. Например, векторное представление слова «bank» одинаково как в фразе «go to the bank to deposit some money», так и в фразе «go to the bank to sit down». Таким образом, многие более современные модели предобучения адаптируют представление одного и того же токена к различным контекстам. Среди них — BERT, гораздо более глубокая модель самообучения, основанная на кодировщике трансформера. В этой главе мы сосредоточимся на том, как предобучать такие представления для текста, как показано на рисунке Fig. 15.1.
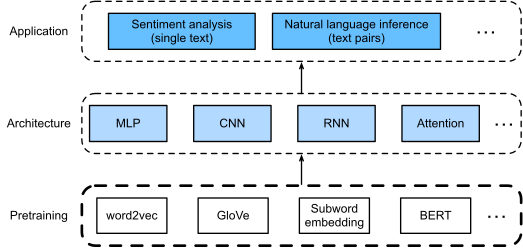
Fig. 15.1 Предобученные текстовые представления можно подавать на вход различным архитектурам глубокого обучения для решения разных задач обработки естественного языка. В этой главе основное внимание уделяется предобучению текстовых представлений на этапе upstream.
Чтобы увидеть общую картину, Fig. 15.1 показывает, что предварительно обученные текстовые представления можно подавать в различные архитектуры глубокого обучения для различных задач обработки естественного языка. Мы рассмотрим их в Section 16.
- 15.1. Эмбеддинг слов (word2vec)
- 15.2. Приближённое обучение
- 15.3. Раздел учебника: Набор данных для предобучения словесных вложений
- 15.4. Предобучение word2vec
- 15.5. Эмбеддинг слов с помощью глобальных векторов (GloVe)
- 15.6. Эмбеддинг подслов
- 15.7. Сходство и аналогия слов
- 15.8. Двухсторонние представления кодировщика на основе трансформеров (BERT)
- 15.9. Набор данных для предобучения BERT
- 15.10. Предобучение BERT