
4.7. Среда и сдвиг распределения
В предыдущих разделах мы рассмотрели ряд практических задач машинного обучения, подобрав модели для различных наборов данных. Однако мы ни разу не задумывались о том, откуда изначально берутся данные и что мы в конечном итоге планируем делать с результатами работы наших моделей. Слишком часто разработчики машинного обучения, обладающие данными, спешат создавать модели, не останавливаясь, чтобы обдумать эти фундаментальные вопросы.
Многие неудачные внедрения систем машинного обучения можно связать с этой проблемой. Иногда модели демонстрируют отличные результаты, если оценивать их по точности на тестовой выборке, но терпят катастрофический провал при развертывании, когда распределение данных внезапно меняется. Более коварно то, что само развертывание модели может стать катализатором, возмущающим распределение данных. Предположим, например, что мы обучили модель предсказывать, кто погасит кредит, а кто допустит дефолт, и обнаружили, что выбор обуви заявителем связан с риском дефолта (оксфорды указывают на погашение, кроссовки — на дефолт). Впоследствии мы можем быть склонны выдавать кредит любому заявителю в оксфордах и отказывать всем, кто носит кроссовки.
В данном случае наш необдуманный переход от распознавания образов к принятию решений и неспособность критически оценить окружающую среду могут привести к катастрофическим последствиям. Прежде всего, как только мы начнем принимать решения на основе типа обуви, клиенты это заметят и изменят свое поведение. Вскоре все соискатели будут носить оксфорды, при этом их кредитоспособность не улучшится. Уделите минуту, чтобы осмыслить это, поскольку подобные проблемы повсеместно встречаются во многих приложениях машинного обучения: внедряя в среду решения, основанные на нашей модели, мы можем разрушить саму модель.
Хотя мы не можем дать исчерпывающий обзор этих тем в одном разделе, наша цель здесь — осветить некоторые общие проблемы и стимулировать критическое мышление, необходимое для раннего выявления подобных ситуаций, смягчения последствий и ответственного использования машинного обучения. Некоторые решения просты (например, запросить «правильные» данные), другие технически сложны (например, реализация системы обучения с подкреплением), а третьи требуют выхода за рамки статистического прогнозирования и решения сложных философских вопросов, касающихся этичного применения алгоритмов.
4.7.1. Виды сдвига распределения
Для начала мы остаемся в рамках пассивной постановки задачи предсказания, рассматривая различные способы изменения распределения данных и возможные меры для сохранения качества модели. В одном из классических подходов предполагается, что обучающие данные были выбраны из некоторого распределения \(p_S(\mathbf{x},y)\), тогда как тестовые данные будут состоять из неразмеченных примеров, взятых из другого распределения \(p_T(\mathbf{x},y)\). Уже здесь мы сталкиваемся с неутешительным фактом: без каких-либо предположений о взаимосвязи между \(p_S\) и \(p_T\) невозможно научиться строить устойчивый классификатор.
Рассмотрим задачу бинарной классификации, в которой мы хотим различать собак и кошек. Если распределение может меняться произвольным образом, то наша постановка допускает патологический случай, при котором распределение входных данных остаётся неизменным: \(p_S(\mathbf{x}) = p_T(\mathbf{x})\), но все метки инвертируются: \(p_S(y \mid \mathbf{x}) = 1 - p_T(y \mid \mathbf{x})\). Иными словами, если Бог внезапно решит, что в будущем все «кошки» теперь являются собаками, а то, что мы ранее называли «собаками», теперь называется «кошками» — без каких-либо изменений в распределении входных данных \(p(\mathbf{x})\), — то мы не сможем отличить эту ситуацию от той, в которой распределение вообще не изменилось.
К счастью, при некоторых ограниченных предположениях о том, как данные могут измениться в будущем, обоснованные алгоритмы способны обнаруживать сдвиги и иногда даже адаптироваться на лету, повышая точность исходного классификатора.
4.7.1.1. Сдвиг распределения признаков
Среди категорий сдвига распределения сдвиг ковариат, возможно, является наиболее изученным. В этом случае мы предполагаем, что, хотя распределение входных данных может меняться со временем, функция разметки, то есть условное распределение \(P(y \mid \mathbf{x})\), остается неизменной. Статистики называют это сдвигом ковариат, поскольку проблема возникает из-за изменения распределения ковариат (признаков). Хотя иногда можно рассуждать о сдвиге распределения, не прибегая к причинности, отметим, что сдвиг ковариат является естественным предположением в тех случаях, когда мы считаем, что \(\mathbf{x}\) вызывает \(y\).
Рассмотрим задачу различения кошек и собак. Наши обучающие данные могут состоять из изображений, подобных тем, что представлены в Fig. 4.7.1.
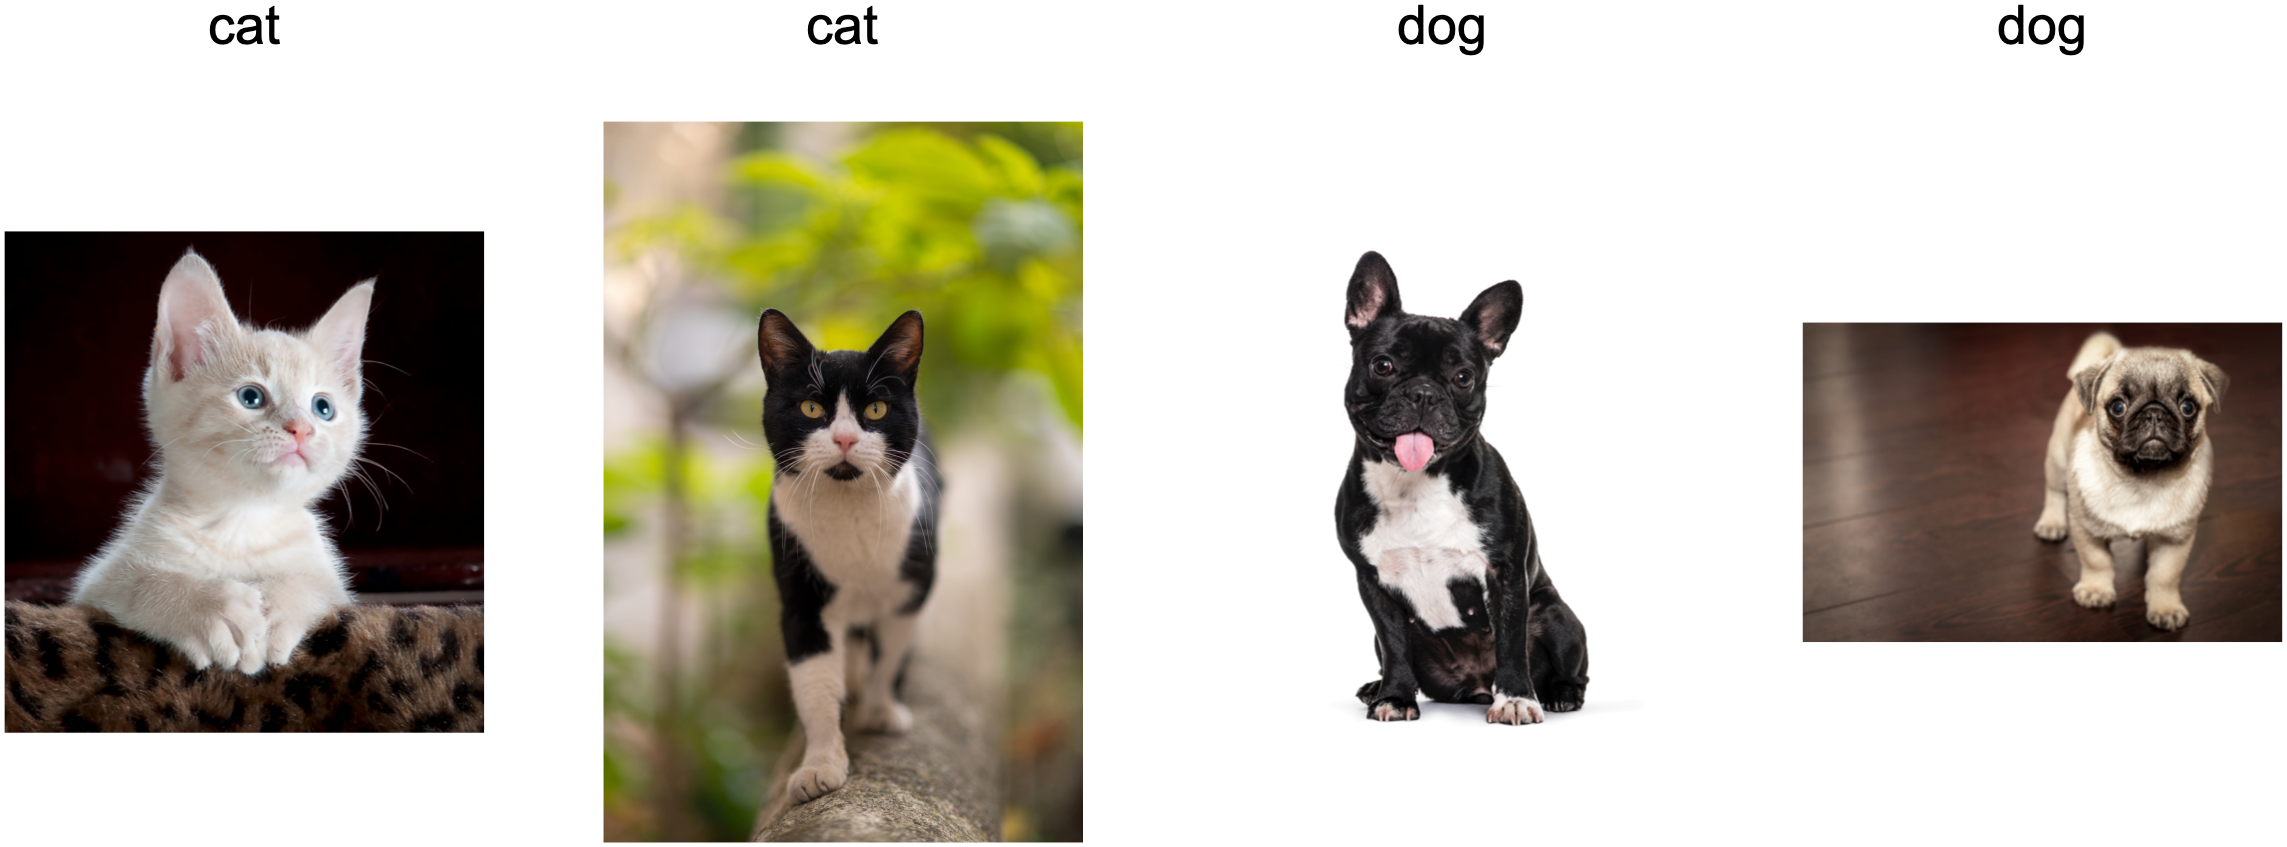
Fig. 4.7.1 Training data for distinguishing cats and dogs (illustrations: Lafeez Hossain / 500px / Getty Images; ilkermetinkursova / iStock / Getty Images Plus; GlobalP / iStock / Getty Images Plus; Musthafa Aboobakuru / 500px / Getty Images).
На этапе тестирования нас просят классифицировать изображения в Fig. 4.7.2.
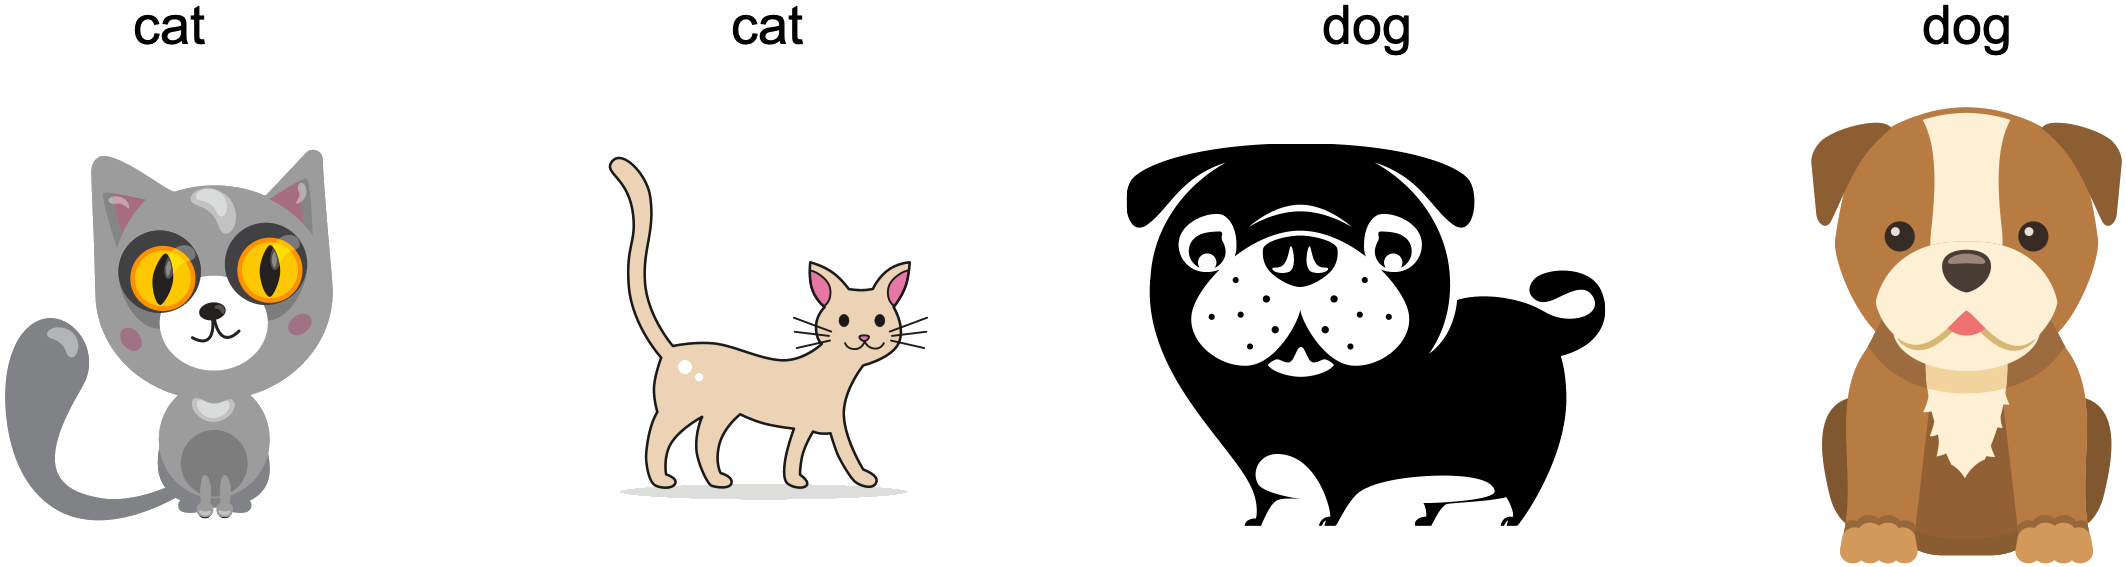
Fig. 4.7.2 Test data for distinguishing cats and dogs (illustrations: SIBAS_minich / iStock / Getty Images Plus; Ghrzuzudu / iStock / Getty Images Plus; id-work / DigitalVision Vectors / Getty Images; Yime / iStock / Getty Images Plus).
Обучающая выборка состоит из фотографий, тогда как тестовая выборка содержит только мультфильмы. Обучение на наборе данных, существенно отличающемся по характеристикам от тестовой выборки, может привести к проблемам, если отсутствует продуманный план адаптации к новой области.
4.7.1.2. Сдвиг меток
Сдвиг меток описывает обратную задачу. Здесь мы предполагаем, что маргинальное распределение меток \(P(y)\) может меняться, но условное распределение при заданной метке \(P(\mathbf{x} \mid y)\) остается неизменным между доменами. Предположение о сдвиге меток обосновано, когда мы считаем, что \(y\) вызывает \(\mathbf{x}\). Например, мы можем хотеть предсказывать диагнозы по их симптомам (или другим проявлениям), даже если относительная распространенность диагнозов со временем меняется. Сдвиг меток — это подходящее предположение в данном случае, поскольку заболевания вызывают симптомы. В некоторых вырожденных случаях предположения о сдвиге меток и сдвиге ковариат могут выполняться одновременно. Например, когда метка детерминирована, предположение о сдвиге ковариат будет выполнено, даже если \(y\) вызывает \(\mathbf{x}\). Интересно, что в таких случаях часто выгодно использовать методы, основанные на предположении о сдвиге меток. Это связано с тем, что такие методы обычно предполагают работу с объектами, похожими на метки (часто низкоразмерными), в отличие от объектов, похожих на входные данные, которые в глубоком обучении, как правило, имеют высокую размерность.
4.7.1.3. Сдвиг концепции
Мы также можем столкнуться со смежной проблемой сдвига концепции, которая возникает, когда меняются сами определения меток. Это звучит странно: кот — это кот, верно? Однако другие категории подвержены изменениям в употреблении с течением времени. Диагностические критерии психических заболеваний, то, что считается модным, и названия профессий — всё это подвержено значительному сдвигу концепции. Оказывается, если мы путешествуем по Соединённым Штатам, изменяя источник наших данных в зависимости от географического положения, мы обнаружим существенный сдвиг концепции в распределении названий газированных напитков, как показано в Fig. 4.7.3.
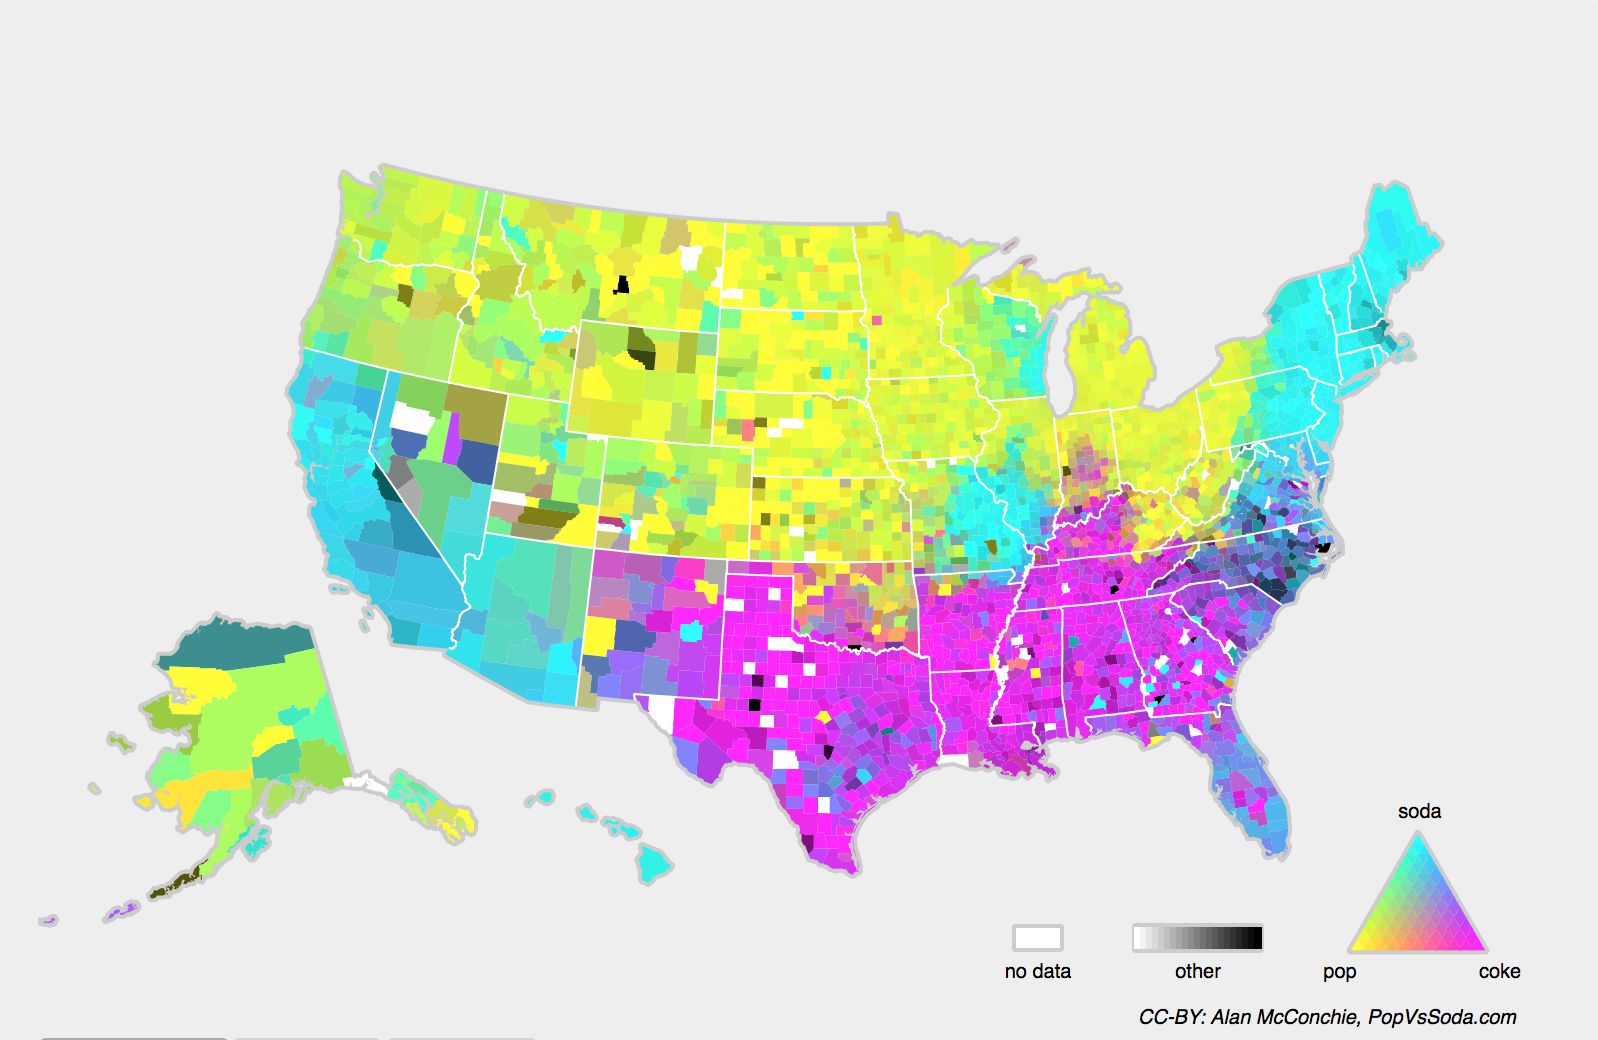
Fig. 4.7.3 Сдвиг концепции в названиях безалкогольных напитков в США (CC-BY: Alan McConchie, PopVsSoda.com).
Если бы мы создавали систему машинного перевода, распределение \(P(y \mid \mathbf{x})\) могло бы отличаться в зависимости от нашего местоположения. Эту проблему бывает трудно обнаружить. Мы можем надеяться использовать знание о том, что сдвиг происходит постепенно, либо во времени, либо в географическом плане.
4.7.2. Примеры сдвига распределения
Прежде чем переходить к формализму и алгоритмам, рассмотрим несколько конкретных ситуаций, в которых ковариатный или концептуальный сдвиг может быть неочевидным.
4.7.2.1. Медицинская диагностика
Представьте, что вы хотите разработать алгоритм для обнаружения рака. Вы собираете данные от здоровых и больных людей и обучаете свой алгоритм. Он работает хорошо, обеспечивая высокую точность, и вы решаете, что готовы к успешной карьере в области медицинской диагностики. Не торопитесь.
Распределения, из которых были получены обучающие данные, и те, с которыми вы столкнетесь в реальных условиях, могут существенно различаться. Это произошло с одной неудачливой стартап-компанией, с которой некоторые из нас, авторов, работали несколько лет назад. Они разрабатывали анализ крови для заболевания, которое преимущественно поражает пожилых мужчин, и надеялись изучить его, используя образцы крови, собранные у пациентов. Однако получить образцы крови от здоровых мужчин значительно сложнее, чем от больных пациентов, уже находящихся в системе. Чтобы компенсировать это, стартап привлекал студентов университетского кампуса для сдачи крови, чтобы использовать их в качестве здоровой контрольной группы при разработке теста. Затем они попросили нас помочь им построить классификатор для выявления заболевания.
Как мы им объяснили, различить здоровую и больную группы с почти идеальной точностью действительно было бы легко. Однако это было связано с тем, что испытуемые различались по возрасту, уровню гормонов, физической активности, рациону, употреблению алкоголя и многим другим факторам, не имеющим отношения к заболеванию. В случае с реальными пациентами такое вряд ли было бы верно. Из-за процедуры отбора выборки мы могли ожидать сильного сдвига ковариат. Более того, в данном случае проблему вряд ли можно было бы решить с помощью обычных методов. Короче говоря, они потратили значительную сумму денег впустую.
4.7.2.2. Автономные автомобили
Предположим, компания хочет использовать машинное обучение для разработки беспилотных автомобилей. Одним из ключевых компонентов здесь является детектор обочины. Поскольку получение реальных размеченных данных обходится дорого, у них возникла (смелая и спорная) идея использовать синтетические данные из игрового движка рендеринга в качестве дополнительных обучающих данных. Это действительно хорошо сработало на «тестовых данных», полученных из движка рендеринга. Однако внутри реального автомобиля всё оказалось катастрофой. Как выяснилось, обочина была отрисована с использованием очень простой текстуры. Что ещё важнее, все обочины были отрисованы с одной и той же текстурой, и детектор обочины очень быстро выучил этот «признак».
С похожим случаем столкнулась армия США, когда она впервые попыталась обнаруживать танки в лесу. Они сделали аэрофотоснимки леса без танков, затем въехали на танках в лес и сделали ещё один набор снимков. Классификатор, казалось, работал идеально. К сожалению, он просто научился отличать деревья с тенями от деревьев без теней: первый набор снимков был сделан рано утром, а второй — в полдень.
4.7.2.3. Нестационарные распределения
Более тонкая ситуация возникает, когда распределение меняется медленно (так называемое нестационарное распределение), а модель не обновляется должным образом. Ниже приведены несколько типичных случаев.
Мы обучаем модель для вычислительной рекламы, а затем перестаем обновлять её достаточно часто (например, забываем учесть, что только что вышел новый, пусть и малоизвестный, тип устройства — iPad).
Мы создаём фильтр спама. Он хорошо справляется с обнаружением всего спама, который мы видели до сих пор. Но затем спамеры понимают, что нужно действовать хитрее, и начинают создавать новые сообщения, которые ничем не похожи на то, что мы видели раньше.
Мы разрабатываем систему рекомендаций товаров. Она хорошо работает в течение зимы, но затем продолжает рекомендовать шапки Санты даже после Рождества.
4.7.2.4. Ещё несколько примеров
Мы создаём детектор лиц. Он хорошо работает на всех бенчмарках. К сожалению, он даёт сбои на тестовых данных — проблемными примерами оказались крупные планы, где лицо занимает всё изображение (таких данных не было в обучающей выборке).
Мы создаем поисковую систему для рынка США и хотим развернуть её в Великобритании.
Мы обучаем классификатор изображений, формируя большой набор данных, в котором каждый из множества классов представлен равномерно, например, 1000 категорий, по 1000 изображений в каждой. Затем мы разворачиваем систему в реальных условиях, где фактическое распределение меток фотографий явно неравномерно.
4.7.3. Коррекция сдвига распределения
Как мы уже обсуждали, во многих случаях обучающее и тестовое распределения \(P(\mathbf{x}, y)\) различаются. В некоторых случаях нам везёт, и модели работают, несмотря на сдвиг ковариат, меток или концепций. В других случаях мы можем добиться лучших результатов, применяя обоснованные стратегии для борьбы со сдвигом. Оставшаяся часть этого раздела становится значительно более технической. Нетерпеливые читатели могут перейти к следующему разделу, поскольку данный материал не является обязательным для понимания последующих понятий.
4.7.3.1. Эмпирический риск и риск
Давайте сначала разберемся, что именно происходит во время обучения модели: мы проходим по признакам и соответствующим меткам обучающих данных \(\{(\mathbf{x}_1, y_1), \ldots, (\mathbf{x}_n, y_n)\}\) и обновляем параметры модели \(f\) после каждого мини-батча. Для простоты мы не будем рассматривать регуляризацию, поэтому в основном минимизируем функцию потерь на обучающих данных:
где \(l\) — функция потерь, оценивающая «качество» предсказания \(f(\mathbf{x}_i)\) при заданной метке \(y_i\). Статистики называют выражение в (4.7.1) эмпирическим риском. Эмпирический риск — это среднее значение функции потерь по обучающим данным, используемое для аппроксимации риска, который представляет собой математическое ожидание функции потерь по всей совокупности данных, порожденной их истинным распределением \(p(\mathbf{x},y)\):
Однако на практике мы обычно не можем получить всю генеральную совокупность данных. Поэтому минимизация эмпирического риска, заключающаяся в минимизации эмпирического риска в (4.7.1), является практической стратегией машинного обучения, направленной на приближенную минимизацию риска.
4.7.3.2. Коррекция ковариатного сдвига
Предположим, что мы хотим оценить некоторую зависимость \(P(y \mid \mathbf{x})\), для которой у нас есть размеченные данные \((\mathbf{x}_i, y_i)\). К сожалению, наблюдения \(\mathbf{x}_i\) выбираются из некоторого распределения источника \(q(\mathbf{x})\), а не из целевого распределения \(p(\mathbf{x})\). К счастью, предположение о независимости означает, что условное распределение не меняется: \(p(y \mid \mathbf{x}) = q(y \mid \mathbf{x})\). Если распределение источника \(q(\mathbf{x})\) «неверно», мы можем скорректировать это, используя следующее простое тождество в функции риска:
Другими словами, нам нужно взвесить каждый пример данных, умножив его на отношение вероятности того, что он был бы взят из правильного распределения, к вероятности того, что он был бы взят из неправильного:
Подставляя вес \(\beta_i\) для каждого примера данных \((\mathbf{x}_i, y_i)\), мы можем обучать модель с помощью взвешенной минимизации эмпирического риска:
К сожалению, мы не знаем это отношение, поэтому прежде чем мы сможем предпринять какие-либо полезные действия, нам нужно его оценить. Существует множество методов, включая некоторые сложные подходы, основанные на теории операторов, которые пытаются перенастроить оператор математического ожидания непосредственно, используя принцип минимальной нормы или максимальной энтропии. Обратите внимание, что для любого такого подхода нам нужны выборки, полученные из обоих распределений: «истинного» \(p\), например, путем доступа к тестовым данным, и того, которое использовалось для формирования обучающей выборки \(q\) (последнее доступно тривиально). Однако отметим, что нам нужны только признаки \(\mathbf{x} \sim p(\mathbf{x})\); нам не нужно обращаться к меткам \(y \sim p(y)\).
В данном случае существует очень эффективный подход, дающий результаты, практически не уступающие оригинальным, — а именно логистическая регрессия, являющаяся частным случаем софтмакс-регрессии (см. Section 4.1) для бинарной классификации. Этого достаточно для вычисления оцененных отношений вероятностей. Мы обучаем классификатор, различающий данные, выбранные из распределения \(p(\mathbf{x})\), и данные, выбранные из распределения \(q(\mathbf{x})\). Если различить эти два распределения невозможно, это означает, что соответствующие экземпляры с одинаковой вероятностью могут происходить из любого из них. С другой стороны, экземпляры, которые хорошо поддаются разделению, следует значительно переоценить или недооценить в соответствии с этим.
Для простоты предположим, что у нас равное количество примеров из обоих распределений \(p(\mathbf{x})\) и \(q(\mathbf{x})\) соответственно. Обозначим через \(z\) вероятности меток, которые соответствуют \(1\) для данных, взятых из \(p\), и \(-1\) для данных, взятых из \(q\). Тогда вероятность в смешанном наборе данных определяется как
Таким образом, если мы используем подход логистической регрессии, где \(P(z=1 \mid \mathbf{x})=\frac{1}{1+\exp(-h(\mathbf{x}))}\) (\(h\) — параметризованная функция), то следует, что
Таким образом, нам необходимо решить две задачи: первую — различать данные, взятые из обоих распределений, а затем — задачу минимизации взвешенной эмпирической ошибки в (4.7.5), где мы взвешиваем слагаемые с помощью \(\beta_i\).
Теперь мы готовы описать алгоритм коррекции. Предположим, у нас есть обучающая выборка \(\{(\mathbf{x}_1, y_1), \ldots, (\mathbf{x}_n, y_n)\}\) и тестовая выборка без меток \(\{\mathbf{u}_1, \ldots, \mathbf{u}_m\}\). В случае ковариатного сдвига мы предполагаем, что \(\mathbf{x}_i\) для всех \(1 \leq i \leq n\) взяты из некоторого исходного распределения, а \(\mathbf{u}_i\) для всех \(1 \leq i \leq m\) взяты из целевого распределения. Ниже приведён типичный алгоритм коррекции ковариатного сдвига:
Создайте обучающую выборку для задачи бинарной классификации: \(\{(\mathbf{x}_1, -1), \ldots, (\mathbf{x}_n, -1), (\mathbf{u}_1, 1), \ldots, (\mathbf{u}_m, 1)\}\).
Обучите бинарный классификатор с помощью логистической регрессии, чтобы получить функцию \(h\).
Взвешиваем обучающие данные с помощью \(\beta_i = \exp(h(\mathbf{x}_i))\) или, что лучше, \(\beta_i = \min(\exp(h(\mathbf{x}_i)), c)\) для некоторой константы \(c\).
Используйте веса \(\beta_i\) для обучения на \(\{(\mathbf{x}_1, y_1), \ldots, (\mathbf{x}_n, y_n)\}\) в (4.7.5).
Обратите внимание, что приведённый выше алгоритм опирается на важное предположение. Для того чтобы эта схема работала, необходимо, чтобы каждый пример данных в целевом (например, тестовом) распределении имел ненулевую вероятность появления в момент обучения. Если мы обнаружим точку, где \(p(\mathbf{x}) > 0\), но \(q(\mathbf{x}) = 0\), то соответствующий вес должен быть бесконечным.
4.7.3.3. Коррекция смещения меток
Предположим, что мы имеем дело с задачей классификации \(k\) категорий. Используя ту же нотацию, что и в Section 4.7.3.2, \(q\) и \(p\), обозначим исходное распределение (например, на этапе обучения) и целевое распределение (например, на этапе тестирования) соответственно. Предположим, что распределение меток со временем меняется: \(q(y) \neq p(y)\), но условное распределение классов остаётся неизменным: \(q(\mathbf{x} \mid y)=p(\mathbf{x} \mid y)\). Если исходное распределение \(q(y)\) «неверно», мы можем скорректировать это, используя следующее тождество для риска, определённого в (4.7.2):
Здесь наши веса важности будут соответствовать отношениям правдоподобия меток:
Одним из преимуществ смещения меток является то, что при наличии достаточно хорошей модели на исходном распределении мы можем получить согласованные оценки этих весов, не прибегая к работе с размерностью пространства. В глубоком обучении входные данные обычно представляют собой объекты высокой размерности, такие как изображения, тогда как метки часто являются более простыми объектами, например, категориями.
Чтобы оценить распределение целевых меток, мы сначала берем достаточно хороший готовый классификатор (обычно обученный на обучающих данных) и вычисляем его «матрицу ошибок» с использованием валидационной выборки (также из распределения обучающих данных). Матрица ошибок, \(\mathbf{C}\), — это просто \(k \times k\) матрица, где каждый столбец соответствует категории метки (истинному значению), а каждая строка — предсказанной нашей моделью категории. Значение \(c_{ij}\) каждой ячейки представляет собой долю всех предсказаний на валидационной выборке, при которых истинная метка была \(j\), а наша модель предсказала \(i\).
Теперь мы не можем напрямую вычислить матрицу ошибок на целевых данных, поскольку не видим меток для примеров, с которыми сталкиваемся в реальных условиях, если только не потратимся на сложный конвейер аннотирования в реальном времени. Однако мы можем усреднить все предсказания нашей модели во время тестирования, получив средние выходные значения модели \(\mu(\hat{\mathbf{y}}) \in \mathbb{R}^k\), где элемент \(i^\textrm{th}\) \(\mu(\hat{y}_i)\) представляет собой долю от общего числа предсказаний на тестовой выборке, для которых наша модель предсказала метку \(i\).
Оказывается, что при некоторых мягких условиях — если наш классификатор изначально был достаточно точным, если целевые данные содержат только категории, которые мы уже встречали ранее, и если выполняется предположение о сдвиге меток (самое сильное из этих предположений) — мы можем оценить распределение меток на тестовой выборке, решив простую линейную систему
поскольку оценка \(\sum_{j=1}^k c_{ij} p(y_j) = \mu(\hat{y}_i)\) выполняется для всех \(1 \leq i \leq k\), где \(p(y_j)\) — это \(j^\textrm{th}\)-й элемент вектора распределения метк размерности \(k\) \(p(\mathbf{y})\). Если наш классификатор изначально достаточно точен, то матрица ошибок \(\mathbf{C}\) будет обратимой, и мы получим решение \(p(\mathbf{y}) = \mathbf{C}^{-1} \mu(\hat{\mathbf{y}})\).
Поскольку мы наблюдаем метки на исходных данных, легко оценить распределение \(q(y)\). Затем для любого обучающего примера \(i\) с меткой \(y_i\) мы можем взять отношение нашей оценки \(p(y_i)/q(y_i)\), чтобы вычислить вес \(\beta_i\), и подставить его в минимизацию взвешенной эмпирической ошибки в (4.7.5).
4.7.3.4. Коррекция концептуального сдвига
Исправление концептуального сдвига гораздо сложнее осуществить принципиально корректным образом. Например, если задача внезапно изменится с различения кошек и собак на различение белых и чёрных животных, было бы неразумно предполагать, что можно добиться значительных улучшений, кроме как собрав новые метки и обучив модель с нуля. К счастью, на практике такие экстремальные сдвиги встречаются редко. Обычно же задача меняется постепенно. Чтобы проиллюстрировать это более конкретно, приведём несколько примеров:
В контексте вычислительной рекламы появляются новые продукты, а старые теряют популярность. Это означает, что распределение рекламных объявлений и их популярности постепенно меняется, и любой предиктор CTR должен постепенно адаптироваться к этим изменениям.
Объективы камер видеонаблюдения постепенно изнашиваются под воздействием окружающей среды, что приводит к постепенному ухудшению качества изображения.
Содержание новостей изменяется постепенно (то есть большинство новостей остаётся неизменным, но появляются новые материалы).
В таких случаях мы можем использовать тот же подход, что и при обучении сетей, чтобы адаптировать их к изменениям в данных. Иными словами, мы используем существующие веса сети и просто выполняем несколько шагов обновления на новых данных, вместо того чтобы обучать с нуля.
4.7.4. Классификация задач обучения
Оборудованные знаниями о том, как справляться с изменениями распределений, мы можем теперь рассмотреть некоторые другие аспекты формулировки задач машинного обучения.
4.7.4.1. Пакетное обучение
В пакетном обучении у нас есть доступ к обучающим признакам и меткам \(\{(\mathbf{x}_1, y_1), \ldots, (\mathbf{x}_n, y_n)\}\), которые мы используем для обучения модели \(f(\mathbf{x})\). Позже мы развертываем эту модель для оценки новых данных \((\mathbf{x}, y)\), выбранных из того же распределения. Это предположение по умолчанию для всех задач, которые мы здесь рассматриваем. Например, мы можем обучить детектор кошек на большом количестве изображений кошек и собак. После обучения мы поставляем его в составе интеллектуальной системы компьютерного зрения для кошачьей двери, которая пропускает только кошек. Затем система устанавливается в доме клиента и больше не обновляется (за исключением экстремальных обстоятельств).
4.7.4.2. Обучение в режиме онлайн
Теперь представим, что данные \((\mathbf{x}_i, y_i)\) поступают по одному примеру за раз. Более конкретно, предположим, что сначала мы наблюдаем \(\mathbf{x}_i\), после чего нам необходимо получить оценку \(f(\mathbf{x}_i)\). Только после этого мы наблюдаем \(y_i\) и, исходя из нашего решения, получаем вознаграждение или несём убыток. Многие реальные задачи попадают в эту категорию. Например, нам нужно предсказать цену акций на завтра, что позволит нам торговать на основе этой оценки, а в конце дня мы узнаем, принесла ли наша оценка прибыль. Иными словами, в онлайн-обучении мы имеем следующий цикл, в котором постоянно улучшаем нашу модель на основе новых наблюдений:
4.7.4.3. Задачи о банкоматах
Бандиты (bandits) являются частным случаем рассмотренной выше проблемы. В большинстве задач обучения мы имеем дело с функцией \(f\), параметры которой хотим научиться оценивать (например, с глубокой нейронной сетью), тогда как в задаче с бандитами у нас есть лишь конечное число рычагов, которые можно дернуть, то есть конечное число действий, которые мы можем совершить. Неудивительно, что для этой более простой задачи можно получить более сильные теоретические гарантии оптимальности. Мы рассматриваем её здесь главным образом потому, что эту задачу часто (и сбивающе с толку) трактуют как отдельный режим обучения.
4.7.4.4. Управление
Во многих случаях среда запоминает, что мы делали. Не обязательно в антагонистическом смысле, но она просто запоминает, и её реакция зависит от того, что происходило ранее. Например, контроллер кофеварки будет фиксировать разные температуры в зависимости от того, нагревался ли бойлер ранее. В таких случаях популярным выбором являются алгоритмы ПИД-регуляторов (пропорционально-интегрально-производных). Аналогичным образом поведение пользователя на новостном сайте зависит от того, что мы ему ранее показали (например, большинство новостей они читают только один раз). Многие подобные алгоритмы строят модель среды, в которой они действуют, чтобы их решения казались менее случайными. В последнее время теория управления (например, варианты ПИД-регуляторов) также используется для автоматической настройки гиперпараметров с целью достижения лучшего разделения скрытых представлений и качества реконструкции, а также для повышения разнообразия генерируемого текста и качества реконструкции сгенерированных изображений (Shao et al., 2020).
4.7.4.5. Обучение с подкреплением
В более общем случае среды с памятью могут возникать ситуации, когда среда пытается сотрудничать с нами (кооперативные игры, в частности, в играх с ненулевой суммой), или ситуации, когда среда стремится к победе. Шахматы, Го, нарды или StarCraft — лишь некоторые примеры задач в обучении с подкреплением. Аналогично, мы можем захотеть создать эффективный контроллер для автономных автомобилей. Другие автомобили, вероятно, будут реагировать на стиль вождения автономного автомобиля нетривиальным образом, например, пытаясь избежать его, спровоцировать аварию или сотрудничать с ним.
4.7.4.6. Учёт окружения
Одно из ключевых различий между рассмотренными выше ситуациями заключается в том, что стратегия, которая могла бы сработать в стационарной среде, может оказаться неэффективной в среде, способной адаптироваться. Например, арбитражная возможность, обнаруженная трейдером, скорее всего, исчезнет, как только ею воспользуются. Скорость и характер изменений среды в значительной степени определяют тип алгоритмов, которые мы можем применить. Например, если мы знаем, что изменения происходят медленно, мы можем заставить любые оценки изменяться также медленно. Если мы знаем, что среда может изменяться мгновенно, но крайне редко, мы можем учесть это. Такие знания имеют решающее значение для начинающего специалиста по данным при работе со сдвигом концепции, то есть когда решаемая задача может меняться со временем.
4.7.5. Справедливость, подотчетность и прозрачность в машинном обучении
Наконец, важно помнить, что при развертывании систем машинного обучения мы не просто оптимизируем предсказательную модель — мы обычно предоставляем инструмент, который будет использоваться для (частичной или полной) автоматизации принятия решений. Эти технические системы могут влиять на жизнь людей, в отношении которых принимаются соответствующие решения. Переход от рассмотрения прогнозов к принятию решений порождает не только новые технические вопросы, но и множество этических вопросов, которые необходимо тщательно учитывать. Если мы разворачиваем систему медицинской диагностики, нам нужно знать, для каких групп населения она может работать, а для каких — нет. Игнорирование предсказуемых рисков для благополучия субпопуляции может привести к оказанию менее качественной помощи. Более того, как только мы начинаем рассматривать системы принятия решений, нам следует отступить и пересмотреть то, как мы оцениваем наши технологии. Среди прочих последствий такого расширения масштаба мы обнаружим, что точность редко является правильной мерой. Например, при преобразовании прогнозов в действия мы часто хотим учитывать потенциальную чувствительность к различным видам ошибок. Если одна ошибка классификации изображения может восприниматься как расовая дискриминация, а ошибка в другую категорию будет безвредной, то мы можем захотеть соответствующим образом скорректировать наши пороги, учитывая общественные ценности при проектировании протокола принятия решений. Мы также должны быть осторожны в отношении того, как системы прогнозирования могут приводить к петлям обратной связи. Например, рассмотрим системы предиктивного полицейского контроля, которые распределяют патрульных по районам с высоким прогнозируемым уровнем преступности. Легко увидеть, как может возникнуть тревожная закономерность:
В районах с более высоким уровнем преступности увеличивается число патрулей.
В результате в этих районах выявляется больше преступлений, которые попадают в обучающие данные, доступные для будущих итераций.
Получая больше положительных примеров, модель предсказывает ещё больше преступлений в этих районах.
На следующей итерации обновленная модель будет ещё сильнее фокусироваться на том же районе, что приведет к обнаружению ещё большего числа преступлений и так далее.
Часто в процессе моделирования не учитываются различные механизмы, посредством которых прогнозы модели оказываются связанными с её обучающими данными. Это может привести к тому, что исследователи называют неконтролируемыми петлями обратной связи. Кроме того, нам следует внимательно относиться к тому, решаем ли мы вообще правильную проблему. Предиктивные алгоритмы теперь играют непропорционально большую роль в распространении информации. Должны ли новости, с которыми сталкивается человек, определяться набором страниц Facebook, которые он отметил как понравившиеся? Это лишь некоторые из множества острых этических дилемм, с которыми вы можете столкнуться в своей карьере в области машинного обучения.
4.7.6. Итог
Во многих случаях обучающие и тестовые выборки имеют разные распределения. Это явление называется сдвигом распределения. Риск — это математическое ожидание функции потерь по всему генеральному множеству данных, порожденному их истинным распределением. Однако это полное множество данных обычно недоступно. Эмпирический риск представляет собой среднее значение функции потерь по обучающим данным, используемое для аппроксимации риска. На практике мы выполняем минимизацию эмпирического риска.
При соблюдении соответствующих допущений ковариатный сдвиг и сдвиг меток можно обнаружить и скорректировать на этапе тестирования. Игнорирование этого смещения может стать проблемой при тестировании. В некоторых случаях среда может запоминать автоматические действия и реагировать неожиданным образом. Мы должны учитывать эту возможность при построении моделей и продолжать мониторинг работающих систем, учитывая риск того, что наши модели и среда могут переплестись непредвиденным образом.
4.7.7. Упражнения
Что может произойти, если изменить поведение поисковой системы? Как отреагируют пользователи? А как отреагируют рекламодатели?
Реализуйте детектор ковариативного сдвига. Подсказка: постройте классификатор.
Реализуйте корректор ковариатного сдвига.
Помимо сдвига распределения, что ещё может влиять на то, как эмпирический риск аппроксимирует истинный риск?