
15.8. Двухсторонние представления кодировщика на основе трансформеров (BERT)
Мы рассмотрели несколько моделей эмбеддингов слов для задач понимания естественного языка. После предобучения результат можно рассматривать как матрицу, в которой каждая строка — это вектор, представляющий слово из заранее определённого словаря. На самом деле, все эти модели эмбеддингов слов являются независимыми от контекста. Давайте начнём с иллюстрации этого свойства.
15.8.1. От контекстно-независимых к контекстно-зависимым
Вспомним эксперименты, описанные в Section 15.4 и Section 15.7. Например, word2vec и GloVe присваивают один и тот же предобученный вектор одному и тому же слову независимо от контекста (если он есть). Формально контекстно-независимое представление любого токена \(x\) — это функция \(f(x)\), которая в качестве единственного аргумента принимает только \(x\). Учитывая обилие многозначности и сложность семантики в естественных языках, контекстно-независимые представления имеют очевидные ограничения. Например, слово «crane» в контекстах «a crane is flying» и «a crane driver came» имеет совершенно разные значения; следовательно, одному и тому же слову могут быть присвоены разные представления в зависимости от контекста.
Это стимулирует разработку контекстно-зависимых представлений слов, в которых представления слов зависят от их контекста. Следовательно, контекстно-зависимое представление токена \(x\) — это функция \(f(x, c(x))\), зависящая как от \(x\), так и от его контекста \(c(x)\). К популярным контекстно-зависимым представлениям относятся TagLM (теггер последовательностей, дополненный языковой моделью) (Peters et al., 2017), CoVe (Контекстные векторы) (McCann et al., 2017) и ELMo (Вложения из языковых моделей) (Peters et al., 2018).
Например, принимая всю последовательность в качестве входа, ELMo представляет собой функцию, которая назначает представление каждому слову из входной последовательности. Конкретнее, ELMo объединяет все промежуточные представления слоёв предобученной двунаправленной LSTM в качестве выходного представления. Затем представление ELMo добавляется к существующей модели обучения с учителем для последующей задачи в качестве дополнительных признаков, например, путём конкатенации представления ELMo и исходного представления (например, GloVe) токенов в существующей модели. С одной стороны, все веса в предобученной двунаправленной LSTM-модели фиксируются после добавления представлений ELMo. С другой стороны, существующая модель обучения с учителем специально адаптируется для конкретной задачи. Используя лучшие модели для разных задач того времени, добавление ELMo улучшило состояние искусства в шести задачах обработки естественного языка: анализ тональности, логический вывод, маркирование семантических ролей, разрешение кореференции, распознавание именованных сущностей и ответ на вопросы.
15.8.2. От специфичных для задачи к универсальным
Хотя ELMo значительно улучшил решения широкого спектра задач обработки естественного языка, каждое из них по-прежнему опирается на специфичную для задачи архитектуру. Однако создание отдельной архитектуры для каждой задачи обработки естественного языка практически нетривиально. Модель GPT (Generative Pre-Training) представляет собой попытку разработать общую независимую от задачи модель для контекстно-зависимых представлений (Radford et al., 2018). Построенная на базе декодировщика трансформера, GPT предварительно обучает языковую модель, которая используется для представления текстовых последовательностей. При применении GPT к последующей задаче выходные данные языковой модели подаются на добавленный линейный выходной слой для предсказания метки задачи. В отличие от ELMo, который фиксирует параметры предварительно обученной модели, GPT дообучает все параметры предварительно обученного декодировщика трансформера в процессе обучения с учителем для последующей задачи. GPT была оценена на двенадцати задачах естественного языкового вывода, ответа на вопросы, оценки сходства предложений и классификации, улучшив состояние искусства в девяти из них при минимальных изменениях архитектуры модели.
Однако из-за авторегрессионной природы языковых моделей GPT учитывает только контекст, следующий слева направо. В контекстах «я пошел в банк, чтобы внести наличные» и «я пошел в банк, чтобы присесть», поскольку слово «банк» чувствительно к контексту слева, GPT вернет одинаковое представление для слова «банк», хотя его значения различаются.
15.8.3. BERT: Объединяя лучшее из обоих миров
Как мы уже видели, ELMo кодирует контекст двунаправленно, но использует архитектуры, специфичные для задачи; в то же время GPT не привязан к конкретной задаче, но кодирует контекст слева направо. Объединяя лучшие черты обоих подходов, BERT (Bidirectional Encoder Representations from Transformers) кодирует контекст двунаправленно и требует минимальных изменений в архитектуре для широкого спектра задач обработки естественного языка (Devlin et al., 2018). Используя предварительно обученный трансформер-кодировщик, BERT способен представлять любой токен на основе его двунаправленного контекста. При обучении с учителем для последующих задач BERT похож на GPT в двух аспектах. Во-первых, представления BERT подаются на добавленный выходной слой, при этом архитектура модели изменяется минимально в зависимости от природы задачи, например, предсказание для каждого токена или предсказание для всей последовательности. Во-вторых, все параметры предварительно обученного трансформер-кодировщика дообучаются, тогда как дополнительный выходной слой обучается с нуля. Fig. 15.8.1 иллюстрирует различия между ELMo, GPT и BERT.
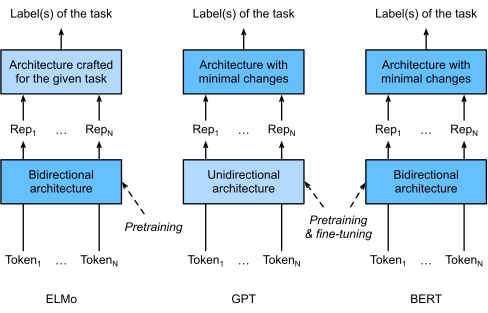
Fig. 15.8.1 Сравнение ELMo, GPT и BERT.
BERT дополнительно улучшил показатели в одиннадцати задачах обработки естественного языка по широким категориям: (i) классификация одиночного текста (например, анализ тональности), (ii) классификация пар текста (например, естественный языковой вывод), (iii) ответ на вопросы, (iv) разметка текста (например, распознавание именованных сущностей). Все эти подходы были предложены в 2018 году: от контекстно-зависимого ELMo до GPT и BERT, не зависящих от конкретной задачи. Концептуально простое, но эффективное на практике предобучение глубоких представлений для естественных языков произвело революцию в решении различных задач обработки естественного языка.
В оставшейся части этой главы мы подробно рассмотрим предобучение BERT. При рассмотрении приложений обработки естественного языка в Section 16 мы продемонстрируем дообучение BERT для решения прикладных задач.
import torch
from torch import nn
from d2l import torch as d2l
15.8.4. Представление входных данных
В обработке естественного языка некоторые задачи (например, анализ тональности) принимают в качестве входа один текст, тогда как в других задачах (например, логический вывод на естественном языке) входом является пара текстовых последовательностей. Последовательность входа BERT однозначно представляет как одиночный текст, так и пары текстов. В первом случае последовательность входа BERT представляет собой конкатенацию специального токена классификации «<cls>», токенов текстовой последовательности и специального токена разделения «<sep>». Во втором случае последовательность входа BERT представляет собой конкатенацию «<cls>», токенов первой текстовой последовательности, «<sep>», токенов второй текстовой последовательности и «<sep>». Мы будем последовательно различать термины «последовательность входа BERT» и другие типы «последовательностей». Например, одна последовательность входа BERT может включать либо одну текстовую последовательность, либо две текстовые последовательности.
Чтобы различать пары текстов, к эмбеддингам токенов первой последовательности и второй последовательности соответственно добавляются выученные эмбеддинги сегментов \(\mathbf{e}_A\) и \(\mathbf{e}_B\). Для одиночных текстовых входных данных используется только \(\mathbf{e}_A\).
Следующий фрагмент get_tokens_and_segments принимает на вход одно
или два предложения, а затем возвращает токены входной
последовательности BERT и соответствующие им идентификаторы сегментов.
#@save
def get_tokens_and_segments(tokens_a, tokens_b=None):
    """Get tokens of the BERT input sequence and their segment IDs."""
    tokens = ['<cls>'] + tokens_a + ['<sep>']
    # 0 and 1 are marking segment A and B, respectively
    segments = [0] * (len(tokens_a) + 2)
    if tokens_b is not None:
        tokens += tokens_b + ['<sep>']
        segments += [1] * (len(tokens_b) + 1)
    return tokens, segments
BERT в качестве двунаправленной архитектуры выбирает трансформер-кодировщик. В трансформер-кодировщике широко используются позиционные вложения, которые добавляются к каждой позиции входной последовательности BERT. Однако, в отличие от исходного трансформер-кодировщика, BERT использует обучаемые позиционные вложения. Иными словами, Fig. 15.8.2 показывает, что вложения входной последовательности BERT представляют собой сумму вложений токенов, вложений сегментов и позиционных вложений.
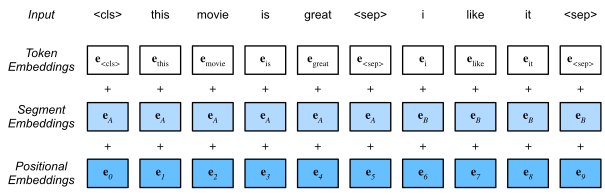
Fig. 15.8.2 Векторные представления входной последовательности BERT представляют собой сумму векторных представлений токенов, сегментов и позиций.
Следующий BERTEncoder класс аналогичен классу
TransformerEncoder, реализованному в Section 11.7. В
отличие от TransformerEncoder, BERTEncoder использует эмбеддинги
сегментов и обучаемые позиционные эмбеддинги.
#@save
class BERTEncoder(nn.Module):
    """BERT encoder."""
    def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
                 num_blks, dropout, max_len=1000, **kwargs):
        super(BERTEncoder, self).__init__(**kwargs)
        self.token_embedding = nn.Embedding(vocab_size, num_hiddens)
        self.segment_embedding = nn.Embedding(2, num_hiddens)
        self.blks = nn.Sequential()
        for i in range(num_blks):
            self.blks.add_module(f"{i}", d2l.TransformerEncoderBlock(
                num_hiddens, ffn_num_hiddens, num_heads, dropout, True))
        # In BERT, positional embeddings are learnable, thus we create a
        # parameter of positional embeddings that are long enough
        self.pos_embedding = nn.Parameter(torch.randn(1, max_len,
                                                      num_hiddens))

    def forward(self, tokens, segments, valid_lens):
        # Shape of `X` remains unchanged in the following code snippet:
        # (batch size, max sequence length, `num_hiddens`)
        X = self.token_embedding(tokens) + self.segment_embedding(segments)
        X = X + self.pos_embedding[:, :X.shape[1], :]
        for blk in self.blks:
            X = blk(X, valid_lens)
        return X
Предположим, что размер словаря равен 10000. Чтобы продемонстрировать прямой вывод ``BERTEncoder``, создадим объект и инициализируем его параметры.
vocab_size, num_hiddens, ffn_num_hiddens, num_heads = 10000, 768, 1024, 4
ffn_num_input, num_blks, dropout = 768, 2, 0.2
encoder = BERTEncoder(vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
                      num_blks, dropout)
Определим tokens как две входные последовательности BERT длины 8,
где каждый токен является индексом из словаря. Прямой вывод
BERTEncoder при входных данных tokens возвращает закодированный
результат, в котором каждый токен представлен вектором, длина которого
предопределена гиперпараметром num_hiddens. Этот гиперпараметр
обычно называют скрытым размером (числом скрытых единиц) кодировщика
трансформера.
tokens = torch.randint(0, vocab_size, (2, 8))
segments = torch.tensor([[0, 0, 0, 0, 1, 1, 1, 1], [0, 0, 0, 1, 1, 1, 1, 1]])
encoded_X = encoder(tokens, segments, None)
encoded_X.shape
15.8.5. Задачи предобучения
Прямой вывод BERTEncoder дает представление BERT для каждого токена
входного текста, а также для вставленных специальных токенов «<cls>» и
«<seq>». Далее мы будем использовать эти представления для вычисления
функции потерь при предобучении BERT. Предобучение состоит из следующих
двух задач: маскированного языкового моделирования и предсказания
следующего предложения.
15.8.5.1. Маскированное языковое моделирование
Как показано на рисунке Section 9.3, языковая модель предсказывает токен на основе контекста слева от него. Для двунаправленного кодирования контекста при представлении каждого токена BERT случайным образом маскирует токены и использует контекст с обеих сторон для предсказания замаскированных токенов в самообучающемся режиме. Эта задача называется маскированной языковой моделью.
В рамках этой задачи предобучения 15% токенов выбираются случайным образом в качестве маскированных токенов для предсказания. Чтобы предсказать маскированный токен, не используя его метку, один из простых подходов — всегда заменять его специальным токеном «<mask>» во входной последовательности BERT. Однако этот искусственный специальный токен «<mask>» никогда не появляется при дообучении. Чтобы избежать такого несоответствия между предобучением и дообучением, если токен маскируется для предсказания (например, слово «great» выбирается для маскирования и предсказания во фразе «this movie is great»), во входной последовательности он будет заменён на:
a special “<mask>” token for 80% of the time (e.g., “this movie is great” becomes “this movie is <mask>”);
случайный токен в 10% случаев (например, «this movie is great» превращается в «this movie is drink»);
неизменную метку-токен в 10% случаев (например, «this movie is great» остается «this movie is great»).
Обратите внимание, что в 10% случаев из 15% вставляется случайный токен. Этот случайный шум помогает BERT быть менее предвзятым к замаскированному токену (особенно когда метка остаётся неизменной) при кодировании двунаправленного контекста.
Мы реализуем следующий MaskLM класс для предсказания замаскированных
токенов в задаче языкового моделирования с маскированием при
предобучении BERT. Предсказание выполняется с помощью многослойного
перцептрона (MLP) с одним скрытым слоем (self.mlp). При прямом
выводе он принимает два входа: закодированный результат BERTEncoder
и позиции токенов для предсказания. На выходе получаются результаты
предсказания для этих позиций.
#@save
class MaskLM(nn.Module):
    """The masked language model task of BERT."""
    def __init__(self, vocab_size, num_hiddens, **kwargs):
        super(MaskLM, self).__init__(**kwargs)
        self.mlp = nn.Sequential(nn.LazyLinear(num_hiddens),
                                 nn.ReLU(),
                                 nn.LayerNorm(num_hiddens),
                                 nn.LazyLinear(vocab_size))

    def forward(self, X, pred_positions):
        num_pred_positions = pred_positions.shape[1]
        pred_positions = pred_positions.reshape(-1)
        batch_size = X.shape[0]
        batch_idx = torch.arange(0, batch_size)
        # Suppose that `batch_size` = 2, `num_pred_positions` = 3, then
        # `batch_idx` is `torch.tensor([0, 0, 0, 1, 1, 1])`
        batch_idx = torch.repeat_interleave(batch_idx, num_pred_positions)
        masked_X = X[batch_idx, pred_positions]
        masked_X = masked_X.reshape((batch_size, num_pred_positions, -1))
        mlm_Y_hat = self.mlp(masked_X)
        return mlm_Y_hat
Чтобы продемонстрировать прямой вывод MaskLM, создадим его объект
mlm и инициализируем его. Напомним, что encoded_X из прямого
вывода BERTEncoder представляет собой две входные последовательности
BERT. Определим mlm_positions как три индекса, которые необходимо
предсказать в любой из входных последовательностей BERT из
encoded_X. Прямой вывод mlm возвращает результаты предсказания
mlm_Y_hat во всех замаскированных позициях mlm_positions в
encoded_X. Для каждого предсказания размер результата равен размеру
словаря.
mlm = MaskLM(vocab_size, num_hiddens)
mlm_positions = torch.tensor([[1, 5, 2], [6, 1, 5]])
mlm_Y_hat = mlm(encoded_X, mlm_positions)
mlm_Y_hat.shape
Имея истинные метки mlm_Y для токенов mlm_Y_hat, скрытых
масками, мы можем вычислить перекрёстную энтропию для задачи языкового
моделирования с масками при предобучении BERT.
mlm_Y = torch.tensor([[7, 8, 9], [10, 20, 30]])
loss = nn.CrossEntropyLoss(reduction='none')
mlm_l = loss(mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y.reshape(-1))
mlm_l.shape
15.8.5.2. Предсказание следующего предложения
Хотя маскированное языковое моделирование способно кодировать двунаправленный контекст для представления слов, оно не моделирует явным образом логические связи между парами текстов. Чтобы лучше понять взаимосвязь между двумя текстовыми последовательностями, BERT в процессе предобучения решает задачу бинарной классификации — предсказания следующего предложения. При генерации пар предложений для предобучения в половине случаев это действительно последовательные предложения с меткой «True», а в другой половине второе предложение случайно выбирается из корпуса с меткой «False».
В следующем NextSentencePred классе используется многослойный
перцептрон с одним скрытым слоем для предсказания того, является ли
второе предложение следующим за первым в последовательности ввода BERT.
Благодаря самовниманию в кодировщике трансформера представление BERT
специального токена «<cls>» кодирует оба предложения из входных данных.
Следовательно, выходной слой (self.output) классификатора MLP
принимает на вход X, где X — это выход скрытого слоя MLP, входом
которого является закодированный токен «<cls>».
#@save
class NextSentencePred(nn.Module):
    """The next sentence prediction task of BERT."""
    def __init__(self, **kwargs):
        super(NextSentencePred, self).__init__(**kwargs)
        self.output = nn.LazyLinear(2)

    def forward(self, X):
        # `X` shape: (batch size, `num_hiddens`)
        return self.output(X)
Мы видим, что прямой вывод объекта ``NextSentencePred`` возвращает бинарные предсказания для каждой входной последовательности BERT.
# PyTorch by default will not flatten the tensor as seen in mxnet where, if
# flatten=True, all but the first axis of input data are collapsed together
encoded_X = torch.flatten(encoded_X, start_dim=1)
# input_shape for NSP: (batch size, `num_hiddens`)
nsp = NextSentencePred()
nsp_Y_hat = nsp(encoded_X)
nsp_Y_hat.shape
Можно также вычислить перекрёстную энтропию для двух задач бинарной классификации.
nsp_y = torch.tensor([0, 1])
nsp_l = loss(nsp_Y_hat, nsp_y)
nsp_l.shape
Примечательно, что все метки в обеих вышеупомянутых задачах предобучения могут быть тривиально получены из корпуса предобучения без усилий по ручной разметке. Оригинальная модель BERT была предобучена на конкатенации BookCorpus (Zhu et al., 2015) и английской версии Wikipedia. Эти два текстовых корпуса огромны: они содержат 800 миллионов и 2,5 миллиарда слов соответственно.
15.8.6. Собираем всё вместе
При предобучении BERT итоговая функция потерь представляет собой
линейную комбинацию функций потерь для маскированного языкового
моделирования и предсказания следующего предложения. Теперь мы можем
определить класс BERTModel, создав экземпляры трёх классов
BERTEncoder, MaskLM и NextSentencePred. При выводе
возвращаются закодированные представления BERT encoded_X,
предсказания для маскированного языкового моделирования mlm_Y_hat и
предсказания следующего предложения nsp_Y_hat.
#@save
class BERTModel(nn.Module):
    """The BERT model."""
    def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens,
                 num_heads, num_blks, dropout, max_len=1000):
        super(BERTModel, self).__init__()
        self.encoder = BERTEncoder(vocab_size, num_hiddens, ffn_num_hiddens,
                                   num_heads, num_blks, dropout,
                                   max_len=max_len)
        self.hidden = nn.Sequential(nn.LazyLinear(num_hiddens),
                                    nn.Tanh())
        self.mlm = MaskLM(vocab_size, num_hiddens)
        self.nsp = NextSentencePred()

    def forward(self, tokens, segments, valid_lens=None, pred_positions=None):
        encoded_X = self.encoder(tokens, segments, valid_lens)
        if pred_positions is not None:
            mlm_Y_hat = self.mlm(encoded_X, pred_positions)
        else:
            mlm_Y_hat = None
        # The hidden layer of the MLP classifier for next sentence prediction.
        # 0 is the index of the '<cls>' token
        nsp_Y_hat = self.nsp(self.hidden(encoded_X[:, 0, :]))
        return encoded_X, mlm_Y_hat, nsp_Y_hat
15.8.7. Итоги
Модели эмбеддингов слов, такие как word2vec и GloVe, не учитывают контекст. Они присваивают одно и то же предобученное векторное представление одному и тому же слову независимо от контекста (если он есть). Им трудно корректно обрабатывать полисемию или сложную семантику в естественных языках.
Для контекстно-зависимых представлений слов, таких как ELMo и GPT, представления слов зависят от их контекста.
ELMo кодирует контекст двунаправленно, но использует архитектуры, специфичные для задачи (однако практически нетривиально разрабатывать специфичную архитектуру для каждой задачи обработки естественного языка); в то время как GPT не зависит от задачи, но кодирует контекст слева направо.
BERT сочетает в себе лучшие черты обоих подходов: он кодирует контекст двунаправленно и требует минимальных изменений архитектуры для широкого спектра задач обработки естественного языка.
Векторные представления входной последовательности BERT представляют собой сумму векторных представлений токенов, сегментов и позиций.
Предобучение BERT состоит из двух задач: маскированного языкового моделирования и предсказания следующего предложения. Первая из них позволяет кодировать двунаправленный контекст для представления слов, тогда как вторая явно моделирует логические отношения между парами текстов.
15.8.8. Упражнения
При прочих равных условиях, потребуется ли языковой модели с маскированием больше или меньше шагов предобучения для сходимости, чем левосторонней языковой модели? Почему?
В оригинальной реализации BERT позиционно-независимая полносвязная сеть в
BERTEncoder(черезd2l.TransformerEncoderBlock) и полносвязный слой вMaskLMиспользуют функцию активации Gaussian error linear unit (GELU) (Hendrycks and Gimpel, 2016). Исследования различий между GELU и ReLU.