
5.1. Многослойные перцептроны
В разделе Section 4.1 мы представили софтмакс-регрессию, реализовав алгоритм с нуля (Section 4.4) и с использованием высокоуровневых API (Section 4.5). Это позволило нам обучить классификаторы, способные распознавать 10 категорий одежды по изображениям низкого разрешения. В процессе мы научились обрабатывать данные, преобразовывать выходные значения в корректное распределение вероятностей, применять подходящую функцию потерь и минимизировать её относительно параметров модели. Теперь, когда мы освоили эти механизмы в контексте простых линейных моделей, мы можем приступить к изучению глубоких нейронных сетей — сравнительно богатого класса моделей, которому в первую очередь посвящена эта книга.
%matplotlib inline
import torch
from d2l import torch as d2l
5.1.1. Скрытые слои
В Section 3.1.1.1 мы описали аффинные преобразования как линейные преобразования с добавленным смещением. Для начала вспомним архитектуру модели, соответствующую нашему примеру софтмакс-регрессии, показанную на рисунке Fig. 4.1.1. Эта модель отображает входные данные непосредственно на выходные с помощью одного аффинного преобразования, за которым следует операция софтмакс. Если бы наши метки действительно были связаны с входными данными посредством простого аффинного преобразования, то такой подход был бы достаточным. Однако линейность (в аффинных преобразованиях) — это сильное допущение.
5.1.1.1. Ограничения линейных моделей
Например, линейность подразумевает более слабое предположение о монотонности, то есть что любое увеличение нашего признака либо всегда приводит к увеличению выхода нашей модели (если соответствующий вес положителен), либо всегда приводит к его уменьшению (если соответствующий вес отрицателен). Иногда это имеет смысл. Например, если мы пытаемся предсказать, выплатит ли человек кредит, мы можем разумно предположить, что при прочих равных условиях заявитель с более высоким доходом всегда будет более склонен к погашению, чем заявитель с более низким доходом. Хотя эта зависимость монотонна, она, вероятно, не линейно связана с вероятностью погашения. Увеличение дохода с 0 до 50 000 долларов, вероятно, соответствует большему увеличению правдоподобия погашения, чем увеличение с 1 миллиона до 1,05 миллиона долларов. Одним из способов решения этой проблемы может быть постобработка нашего результата, чтобы линейность стала более правдоподобной, путем использования логистического отображения (и, следовательно, логарифма вероятности результата).
Обратите внимание, что мы можем легко привести примеры, нарушающие монотонность. Скажем, мы хотим предсказать здоровье как функцию от температуры тела. Для людей с нормальной температурой тела выше 37 °C (98,6 °F) более высокие температуры указывают на больший риск. Однако если температура тела опускается ниже 37 °C, более низкие температуры также указывают на больший риск! Снова мы можем решить эту проблему с помощью некоторой хитрой предобработки, например, используя расстояние от 37 °C в качестве признака.
Но как насчет классификации изображений кошек и собак? Должно ли увеличение интенсивности пикселя в позиции (13, 17) всегда увеличивать (или всегда уменьшать) правдоподобие того, что на изображении изображена собака? Использование линейной модели соответствует неявному предположению, что для различения кошек и собак достаточно оценить яркость отдельных пикселей. Этот подход обречен на провал в мире, где инвертирование изображения не меняет его категорию.
И всё же, несмотря на кажущуюся абсурдность линейности в данном случае по сравнению с предыдущими примерами, не так очевидно, что мы можем решить эту проблему с помощью простой предобработки. Дело в том, что значимость любого пикселя сложным образом зависит от его контекста (значений окружающих пикселей). Хотя может существовать такое представление данных, которое учитывало бы необходимые взаимодействия между признаками и на основе которого была бы применима линейная модель, мы просто не знаем, как вычислить его вручную. В глубоких нейронных сетях мы используем эмпирические данные для совместного обучения представления через скрытые слои и линейного предиктора, действующего на основе этого представления.
Эта проблема нелинейности изучается уже как минимум столетие (Fisher, 1925). Например, решающие деревья в своей простейшей форме используют последовательность бинарных решений для определения принадлежности объекта к классу (Quinlan, 1993). Аналогично, методы ядра применяются уже много десятилетий для моделирования нелинейных зависимостей (Aronszajn, 1950). Это нашло свое отражение в непараметрических сплайн-моделях (Wahba, 1990) и методах ядра (Schölkopf and Smola, 2002). Эту же задачу мозг решает довольно естественно. В конце концов, нейроны передают сигналы другим нейронам, которые, в свою очередь, передают сигналы следующим нейронам (Ramón y Cajal and Azoulay, 1894). В результате мы получаем последовательность относительно простых преобразований.
5.1.1.2. Добавление скрытых слоёв
Мы можем преодолеть ограничения линейных моделей, добавив один или несколько скрытых слоёв. Самый простой способ сделать это — разместить несколько полносвязных слоёв друг над другом. Каждый слой передаёт данные в слой, расположенный выше, пока не будут сгенерированы выходные значения. Мы можем рассматривать первые \(L-1\) слои как наше представление, а последний слой — как линейный предиктор. Эта архитектура обычно называется многослойным перцептроном, часто сокращённо MLP (Fig. 5.1.1).
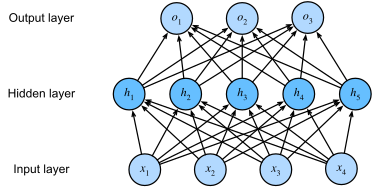
Fig. 5.1.1 Многослойный перцептрон со скрытым слоем из пяти скрытых единиц.
В этой многослойной сети (MLP) четыре входа, три выхода, а скрытый слой содержит пять скрытых единиц. Поскольку во входном слое вычисления не производятся, для получения результатов необходимо реализовать вычисления как для скрытого, так и для выходного слоя; следовательно, число слоёв в данной MLP равно двум. Обратите внимание, что оба слоя являются полносвязными. Каждый вход влияет на каждый нейрон скрытого слоя, а каждый из них, в свою очередь, влияет на каждый нейрон выходного слоя. Тем не менее, на этом мы пока не закончили.
5.1.1.3. От линейных к нелинейным
Как и ранее, обозначим через матрицу \(\mathbf{X} \in \mathbb{R}^{n \times d}\) мини-батч из \(n\) примеров, где каждый пример содержит \(d\) входов (признаков). Для многослойного перцептрона с одним скрытым слоем, содержащим \(h\) скрытых единиц, обозначим через \(\mathbf{H} \in \mathbb{R}^{n \times h}\) выходы скрытого слоя, которые являются скрытыми представлениями. Поскольку скрытый и выходной слои полностью связаны, у нас есть веса и смещения скрытого слоя \(\mathbf{W}^{(1)} \in \mathbb{R}^{d \times h}\) и \(\mathbf{b}^{(1)} \in \mathbb{R}^{1 \times h}\), а также веса и смещения выходного слоя \(\mathbf{W}^{(2)} \in \mathbb{R}^{h \times q}\) и \(\mathbf{b}^{(2)} \in \mathbb{R}^{1 \times q}\). Это позволяет вычислять выходы \(\mathbf{O} \in \mathbb{R}^{n \times q}\) многослойного перцептрона с одним скрытым слоем следующим образом:
Обратите внимание, что после добавления скрытого слоя нашей модели теперь требуется отслеживать и обновлять дополнительные наборы параметров. Так что же мы получили взамен? Вы можете удивиться, узнав, что в модели, определённой выше, мы не получаем ничего за свои усилия! Причина проста. Скрытые единицы выше являются аффинной функцией от входов, а выходы (до софтмакса) — это просто аффинная функция от скрытых единиц. Аффинная функция от аффинной функции сама по себе является аффинной функцией. Более того, наша линейная модель уже была способна представлять любую аффинную функцию.
Чтобы показать это формально, мы можем исключить скрытый слой из приведённого выше определения, получив эквивалентную однослойную модель с параметрами \(\mathbf{W} = \mathbf{W}^{(1)}\mathbf{W}^{(2)}\) и \(\mathbf{b} = \mathbf{b}^{(1)} \mathbf{W}^{(2)} + \mathbf{b}^{(2)}\):
Чтобы реализовать потенциал многослойных архитектур, нам нужен ещё один ключевой элемент: нелинейная функция активации \(\sigma\), применяемая к каждому скрытому объекту после аффинного преобразования. Например, популярным выбором является функция активации ReLU (rectified linear unit) (Nair and Hinton, 2010) \(\sigma(x) = \mathrm{max}(0, x)\), действующая на свои аргументы поэлементно. Результаты работы функций активации \(\sigma(\cdot)\) называются активациями. В общем случае наличие функций активации не позволяет свести наш многослойный персептрон к линейной модели:
Поскольку каждая строка в \(\mathbf{X}\) соответствует одному примеру в мини-батче, с некоторым допущением в обозначениях мы определяем нелинейность \(\sigma\) так, чтобы она применялась к входным данным построчно, то есть по одному примеру за раз. Обратите внимание, что мы использовали те же обозначения для софтмакса, когда описывали построчную операцию в Section 4.1.1.3. Очень часто используемые нами функции активации применяются не только построчно, но и поэлементно. Это означает, что после вычисления линейной части слоя мы можем вычислить каждое значение активации, не обращая внимания на значения, принятые другими скрытыми нейронами.
Чтобы построить более общие многослойные перцептроны, мы можем продолжать добавлять скрытые слои, например \(\mathbf{H}^{(1)} = \sigma_1(\mathbf{X} \mathbf{W}^{(1)} + \mathbf{b}^{(1)})\) и \(\mathbf{H}^{(2)} = \sigma_2(\mathbf{H}^{(1)} \mathbf{W}^{(2)} + \mathbf{b}^{(2)})\), один над другим, получая всё более выразительные модели.
5.1.1.4. Универсальные аппроксиматоры
Мы знаем, что мозг способен выполнять весьма сложные статистические вычисления. В связи с этим стоит задать вопрос: насколько мощной может быть глубокая нейронная сеть? На этот вопрос неоднократно отвечали, например, в Cybenko (1989) в контексте многослойных персептронов (MLP), и в Micchelli (1984) в контексте воспроизводящих ядерных гильбертовых пространств, что можно рассматривать как эквивалент радиальных базисных сетей (RBF) со скрытым слоем. Эти (и смежные) результаты показывают, что даже при наличии сети с одним скрытым слоем, если выбрать достаточное количество узлов (возможно, чрезмерно большое) и правильные веса, мы сможем аппроксимировать любую функцию. Однако сам процесс обучения этой функции является сложной задачей. Можно провести аналогию между нейронной сетью и языком программирования C. Как и любой другой современный язык, C способен выразить любую вычислимую программу. Но написать программу, соответствующую вашим требованиям, — вот в чём заключается главная сложность.
Более того, тот факт, что однослойная сеть может выучить любую функцию, не означает, что вам следует пытаться решать все свои задачи с её помощью. На самом деле в этом случае методы ядра оказываются гораздо более эффективными, поскольку они способны решать задачу точно даже в бесконечномерных пространствах (Kimeldorf and Wahba, 1971, Schölkopf et al., 2001). Более того, мы можем аппроксимировать многие функции гораздо более компактно, используя более глубокие (а не широкие) сети (Simonyan and Zisserman, 2014). Более строгие аргументы мы рассмотрим в последующих главах.
5.1.2. Функции активации
Функции активации определяют, должен ли нейрон активироваться, вычисляя взвешенную сумму и добавляя к ней смещение. Это дифференцируемые операторы, преобразующие входные сигналы в выходные, причём большинство из них вносит нелинейность. Поскольку функции активации являются фундаментальными для глубокого обучения, кратко рассмотрим некоторые из наиболее распространенных.
5.1.2.1. Функция ReLU
Наиболее популярным выбором, благодаря простоте реализации и хорошей производительности в различных задачах прогнозирования, является прямолинейный блок (ReLU) (Nair and Hinton, 2010). ReLU обеспечивает очень простую нелинейную трансформацию. Для элемента \(x\) функция определяется как максимум этого элемента и \(0\):
Неформально функция ReLU оставляет только положительные элементы и обнуляет все отрицательные, устанавливая соответствующие значения активации равными 0. Чтобы получить интуитивное понимание её работы, можно построить график функции. Как видно, функция активации является кусочно-линейной.
x = torch.arange(-8.0, 8.0, 0.1, requires_grad=True)
y = torch.relu(x)
d2l.plot(x.detach(), y.detach(), 'x', 'relu(x)', figsize=(5, 2.5))
Когда вход отрицателен, производная функции ReLU равна 0, а когда вход положителен, производная функции ReLU равна 1. Обратите внимание, что функция ReLU недифференцируема, когда вход принимает значение, точно равное 0. В таких случаях мы по умолчанию используем левостороннюю производную и считаем, что производная равна 0 при входе, равном 0. Мы можем пойти на это упрощение, поскольку вход может никогда фактически не становиться нулевым (математики сказали бы, что функция недифференцируема на множестве меры нуль). Существует старая поговорка: если существенное значение имеют тонкие граничные условия, то, вероятно, мы занимаемся (настоящей) математикой, а не инженерией. Это общепринятое мнение может применяться и здесь, или, по крайней мере, тот факт, что мы не выполняем оптимизацию с ограничениями (Mangasarian, 1965, Rockafellar, 1970). Ниже мы приводим график производной функции ReLU.
y.backward(torch.ones_like(x), retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of relu', figsize=(5, 2.5))
Причина использования ReLU заключается в том, что его производные ведут себя особенно хорошо: либо они обращаются в ноль, либо просто пропускают аргумент. Это делает процесс оптимизации более устойчивым и смягчает хорошо задокументированную проблему затухающих градиентов, которая ранее сопровождала предыдущие версии нейронных сетей (об этом мы поговорим позже).
Обратите внимание, что существует множество вариантов функции ReLU, включая параметризованную ReLU (pReLU) (He et al., 2015). Эта вариация добавляет к ReLU линейный член, поэтому часть информации сохраняется даже при отрицательных значениях аргумента:
5.1.2.2. Функция сигмоиды
[Функция сигмоиды преобразует входы, значения которых лежат в области определения :math:`mathbb{R}`, **в выходы, лежащие на интервале (0, 1).] По этой причине сигмоиду часто называют функцией сжатия: она сжимает любой вход из диапазона (-∞, ∞) в некоторое значение из диапазона (0, 1):
В самых ранних нейронных сетях учёных интересовало моделирование биологических нейронов, которые либо возбуждаются, либо не возбуждаются. Поэтому пионеры этой области, начиная с МакКаллока и Питтса — создателей искусственного нейрона, — сосредоточились на пороговых элементах (McCulloch and Pitts, 1943). Пороговая функция активации принимает значение 0, если её вход ниже некоторого порога, и значение 1, если вход превышает порог.
Когда фокус сместился на обучение на основе градиентов, сигмоидная функция стала естественным выбором, поскольку она представляет собой гладкое дифференцируемое приближение к пороговому элементу. Сигмоиды по-прежнему широко используются в качестве функций активации на выходных нейронах, когда мы хотим интерпретировать выходы как вероятности для задач бинарной классификации: сигмоиду можно рассматривать как частный случай софтмакса. Однако в большинстве случаев применения в скрытых слоях сигмоиды были в значительной степени вытеснены более простой и легко обучаемой функцией ReLU. Во многом это связано с тем, что сигмоида создает проблемы для оптимизации (LeCun et al., 1998), поскольку её градиент обращается в ноль при больших положительных и отрицательных аргументах. Это может приводить к появлению плато, из которых трудно выбраться. Тем не менее сигмоиды остаются важными. В последующих главах (например, в Section 10.1), посвященных рекуррентным нейронным сетям, мы опишем архитектуры, которые используют сигмоидные элементы для управления потоком информации во времени.
Ниже приведён график сигмоидной функции. Обратите внимание, что при значениях аргумента, близких к нулю, сигмоидная функция приближается к линейному преобразованию.
y = torch.sigmoid(x)
d2l.plot(x.detach(), y.detach(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
Производная сигмоидной функции задаётся следующим уравнением:
Производная сигмоидной функции изображена на рисунке ниже. Обратите внимание, что при входном значении, равном нулю, производная сигмоидной функции достигает максимального значения 0,25. По мере удаления входного значения от нуля в любом направлении производная стремится к нулю.
# Clear out previous gradients
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of sigmoid', figsize=(5, 2.5))
5.1.2.3. Функция Tanh
Как и сигмоидная функция, функция tanh (гиперболический тангенс также сжимает свои входные значения, преобразуя их в элементы на интервале между \(-1\) и \(1\):
Ниже приведен график функции tanh. Обратите внимание, что при приближении аргумента к нулю функция tanh ведет себя как линейное преобразование. Хотя форма этой функции похожа на форму сигмоидальной функции, функция tanh обладает точечной симметрией относительно начала координат (Kalman and Kwasny, 1992).
y = torch.tanh(x)
d2l.plot(x.detach(), y.detach(), 'x', 'tanh(x)', figsize=(5, 2.5))
Производная функции tanh равна:
На рисунке ниже приведён график этой функции. Когда входное значение приближается к нулю, производная функции tanh стремится к своему максимальному значению, равному 1. Как мы уже видели для сигмоидной функции, при удалении входного значения от нуля в любом направлении производная функции tanh стремится к нулю.
# Clear out previous gradients
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of tanh', figsize=(5, 2.5))
5.1.3. Итоги и обсуждение
Теперь мы знаем, как использовать нелинейности для построения выразительных архитектур многослойных нейронных сетей. Как побочное замечание, ваши знания уже позволяют вам владеть набором инструментов, аналогичным тому, что был у специалистов примерно в 1990 году. В некотором смысле вы имеете преимущество перед теми, кто работал в то время, поскольку можете использовать мощные фреймворки глубокого обучения с открытым исходным кодом для быстрого создания моделей, используя всего несколько строк кода. Ранее для обучения таких сетей исследователям приходилось явно реализовывать слои и производные на C, Fortran или даже Lisp (в случае LeNet).
Вторым преимуществом является то, что ReLU значительно лучше поддается оптимизации, чем сигмоидная или гиперболический тангенс. Можно утверждать, что это стало одним из ключевых нововведений, способствовавших возрождению глубокого обучения за последнее десятилетие. Однако следует отметить, что исследования в области функций активации не прекращаются. Например, функция активации GELU (Gaussian Error Linear Unit) \(x \Phi(x)\), предложенная в Hendrycks and Gimpel (2016) (где \(\Phi(x)\) обозначает стандартную функцию распределения Гаусса), и функция активации Swish \(\sigma(x) = x \operatorname{sigmoid}(\beta x)\), предложенная в Ramachandran et al. (2017), могут обеспечивать более высокую точность во многих случаях.
5.1.4. Упражнения
Покажите, что добавление слоёв в линейную глубокую сеть, то есть сеть без нелинейности \(\sigma\), никогда не может увеличить выразительную способность сети. Приведите пример, где она активно её снижает.
Вычислите производную функции активации pReLU.
Вычислите производную функции активации Swish \(x \operatorname{sigmoid}(\beta x)\).
Покажите, что многослойный перцептрон, использующий только ReLU (или pReLU), строит непрерывную кусочно-линейную функцию.
Функции сигмоиды и гиперболического тангенса очень похожи.
Докажите, что \(\operatorname{tanh}(x) + 1 = 2 \operatorname{sigmoid}(2x)\).
Докажите, что классы функций, задаваемые обеими нелинейностями, совпадают. Подсказка: аффинные слои также содержат члены смещения.
Предположим, что у нас есть нелинейность, которая применяется к одному мини-батчу за раз, например, батч-нормализация (Ioffe and Szegedy, 2015). Какие проблемы, по вашему мнению, это может вызвать?
Приведите пример, в котором градиенты затухают для функции активации сигмоиды.