
19.3. Асинхронный случайный поиск
Как мы видели в предыдущем Section 19.2, из-за высокой стоимости оценки конфигураций гиперпараметров нам может потребоваться ждать часы или даже дни, прежде чем случайный поиск вернёт хорошую конфигурацию гиперпараметров. На практике у нас часто есть доступ к пулу ресурсов, например, к нескольким GPU на одной машине или к нескольким машинам с одним GPU. Это порождает вопрос: как эффективно распараллелить случайный поиск?
В целом различают синхронную и асинхронную параллельную оптимизацию гиперпараметров (см. Fig. 19.3.1). В синхронном режиме мы ждем завершения всех одновременно запущенных экспериментов, прежде чем приступать к следующей партии. Рассмотрим пространства конфигураций, содержащие такие гиперпараметры, как количество фильтров или число слоёв в глубокой нейронной сети. Конфигурации гиперпараметров, содержащие большее число слоёв фильтров, будут завершаться естественным образом дольше, и все остальные эксперименты в той же партии будут вынуждены ждать на точках синхронизации (серая область на Fig. 19.3.1), прежде чем мы сможем продолжить процесс оптимизации.
В асинхронном режиме мы немедленно планируем новый эксперимент, как только становятся доступными ресурсы. Это позволяет оптимально использовать ресурсы, поскольку мы можем избежать любых накладных расходов на синхронизацию. При случайном поиске каждая новая конфигурация гиперпараметров выбирается независимо от всех остальных, в частности, без использования наблюдений, полученных в ходе предыдущих оценок. Это означает, что мы можем тривиально распараллелить случайный поиск в асинхронном режиме. Это не так просто для более сложных методов, которые принимают решения на основе предыдущих наблюдений (см. Section 19.5). Хотя для асинхронного случайного поиска требуется больше ресурсов, чем в последовательном режиме, он демонстрирует линейное ускорение: определённый уровень производительности достигается в \(K\) раз быстрее, если можно запустить \(K\) экспериментов параллельно.
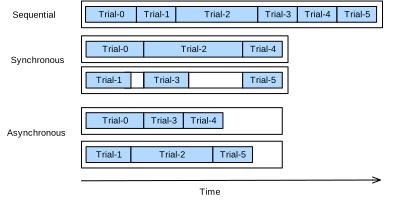
Fig. 19.3.1 Распределение процесса оптимизации гиперпараметров может осуществляться как синхронно, так и асинхронно. По сравнению с последовательным подходом, это позволяет сократить общее время выполнения при сохранении общего объёма вычислений. Синхронное планирование может приводить к простоям рабочих узлов из-за наличия «медленных» задач (stragglers).
В этом разделе мы рассмотрим асинхронный случайный поиск, при котором испытания выполняются в нескольких процессах Python на одной машине. Распределённое планирование и выполнение задач сложно реализовать с нуля. Мы будем использовать Syne Tune (Salinas et al., 2022), предоставляющий простой интерфейс для асинхронной оптимизации гиперпараметров (HPO). Syne Tune разработан для работы с различными бэкендами выполнения; заинтересованным читателям предлагается изучить его простые API, чтобы узнать больше о распределённой оптимизации гиперпараметров.
import logging
from d2l import torch as d2l

logging.basicConfig(level=logging.INFO)
from syne_tune import StoppingCriterion, Tuner
from syne_tune.backend.python_backend import PythonBackend
from syne_tune.config_space import loguniform, randint
from syne_tune.experiments import load_experiment
from syne_tune.optimizer.baselines import RandomSearch
19.3.1. Целевая функция
Во-первых, нам необходимо определить новую целевую функцию, которая
будет возвращать показатели эффективности в Syne Tune через коллбэк
report.
def hpo_objective_lenet_synetune(learning_rate, batch_size, max_epochs):
    from syne_tune import Reporter
    from d2l import torch as d2l

    model = d2l.LeNet(lr=learning_rate, num_classes=10)
    trainer = d2l.HPOTrainer(max_epochs=1, num_gpus=1)
    data = d2l.FashionMNIST(batch_size=batch_size)
    model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
    report = Reporter()
    for epoch in range(1, max_epochs + 1):
        if epoch == 1:
            # Initialize the state of Trainer
            trainer.fit(model=model, data=data)
        else:
            trainer.fit_epoch()
        validation_error = trainer.validation_error().cpu().detach().numpy()
        report(epoch=epoch, validation_error=float(validation_error))
Обратите внимание, что PythonBackend Syne Tune требует импорта
зависимостей внутри определения функции.
19.3.2. Асинхронный планировщик
Сначала определим количество рабочих процессов, которые будут оценивать эксперименты параллельно. Также необходимо указать продолжительность выполнения случайного поиска, задав верхний предел общего времени работы.
n_workers = 2  # Needs to be <= the number of available GPUs

max_wallclock_time = 12 * 60  # 12 minutes
Далее мы указываем метрику, которую хотим оптимизировать, а также
направление её оптимизации — минимизацию или максимизацию. При этом
значение metric должно соответствовать имени аргумента,
передаваемому в коллбек report.
mode = "min"
metric = "validation_error"
Мы используем пространство конфигураций из нашего предыдущего примера. В
Syne Tune этот словарь также можно использовать для передачи постоянных
атрибутов в скрипт обучения. Мы используем эту возможность для передачи
max_epochs. Кроме того, мы указываем первую конфигурацию, подлежащую
оценке, в initial_config.
config_space = {
    "learning_rate": loguniform(1e-2, 1),
    "batch_size": randint(32, 256),
    "max_epochs": 10,
}
initial_config = {
    "learning_rate": 0.1,
    "batch_size": 128,
}
Далее необходимо указать бэкенд для выполнения задач. В данном разделе мы рассматриваем только распределение на локальной машине, где параллельные задачи выполняются в виде подпроцессов. Однако для масштабного поиска гиперпараметров (HPO) эту конфигурацию можно также развернуть в кластерной или облачной среде, где каждая попытка (trial) использует целый объект (instance).
trial_backend = PythonBackend(
    tune_function=hpo_objective_lenet_synetune,
    config_space=config_space,
)
Теперь мы можем создать планировщик для асинхронного случайного поиска,
который по поведению аналогичен нашему BasicScheduler из
Section 19.2.
scheduler = RandomSearch(
    config_space,
    metric=metric,
    mode=mode,
    points_to_evaluate=[initial_config],
)
Syne Tune также включает Tuner, в котором основной цикл
экспериментов и учёт данных централизованы, а взаимодействие между
планировщиком и бэкендом опосредовано.
stop_criterion = StoppingCriterion(max_wallclock_time=max_wallclock_time)

tuner = Tuner(
    trial_backend=trial_backend,
    scheduler=scheduler,
    stop_criterion=stop_criterion,
    n_workers=n_workers,
    print_update_interval=int(max_wallclock_time * 0.6),
)
Запустим наш распределённый эксперимент по оптимизации гиперпараметров. Согласно критерию остановки, он будет выполняться около 12 минут.
tuner.run()
Логи всех протестированных конфигураций гиперпараметров сохраняются для последующего анализа. В любой момент во время выполнения задачи настройки мы можем легко получить результаты, достигнутые на данный момент, и построить траекторию incumbent-решения.
d2l.set_figsize()
tuning_experiment = load_experiment(tuner.name)
tuning_experiment.plot()
19.3.3. Визуализация процесса асинхронной оптимизации
Ниже мы визуализируем, как эволюционируют кривые обучения каждого испытания (каждый цвет на графике соответствует одному испытанию) в процессе асинхронной оптимизации. В любой момент времени количество одновременно запущенных испытаний равно числу рабочих. Как только одно испытание завершается, мы немедленно запускаем следующее, не дожидаясь завершения остальных. Асинхронное планирование сводит время простоя рабочих к минимуму.
d2l.set_figsize([6, 2.5])
results = tuning_experiment.results

for trial_id in results.trial_id.unique():
    df = results[results["trial_id"] == trial_id]
    d2l.plt.plot(
        df["st_tuner_time"],
        df["validation_error"],
        marker="o"
    )

d2l.plt.xlabel("wall-clock time")
d2l.plt.ylabel("objective function")
19.3.4. Резюме
Мы можем существенно сократить время ожидания при случайном поиске, распределяя испытания по параллельным ресурсам. В целом мы различаем синхронное и асинхронное планирование. При синхронном планировании мы выбираем новую партию конфигураций гиперпараметров только после завершения предыдущей. Если есть «отстающие» испытания — те, которые занимают больше времени, чем остальные, — наши рабочие узлы вынуждены ждать на точках синхронизации. Асинхронное планирование оценивает новые конфигурации гиперпараметров сразу же, как только становятся доступными ресурсы, и, следовательно, обеспечивает занятость всех рабочих узлов в любой момент времени. Хотя случайный поиск легко распараллелить асинхронно и он не требует изменений самого алгоритма, другие методы нуждаются в дополнительных модификациях.
19.3.5. Упражнения
Рассмотрим модель
DropoutMLP, реализованную в Section 5.6 и использованную в упражнении 1 из Section 19.2.Реализуйте целевую функцию
hpo_objective_dropoutmlp_synetuneдля использования с Syne Tune. Убедитесь, что функция сообщает об ошибке на валидационной выборке после каждой эпохи.Используя настройку из упражнения 1 в Section 19.2, сравните случайный поиск с байесовской оптимизацией. Если вы используете SageMaker, вы можете воспользоваться средствами бенчмаркинга Syne Tune для запуска экспериментов параллельно. Подсказка: байесовская оптимизация предоставляется в виде
syne_tune.optimizer.baselines.BayesianOptimization.Для выполнения этого упражнения вам потребуется запустить код на объекте с как минимум 4 ядрами процессора. Для одного из рассмотренных выше методов (случайный поиск или байесовская оптимизация) проведите эксперименты с
n_workers=1,n_workers=2,n_workers=4и сравните результаты (траектории incumbent). По крайней мере для случайного поиска вы должны наблюдать линейное масштабирование в зависимости от количества рабочих процессов. Подсказка: для получения надёжных результатов может потребоваться усреднение по нескольким повторениям для каждого случая.
Продвинутый. Цель этого упражнения — реализовать новый планировщик в Syne Tune.
Создайте виртуальное окружение, включающее исходные коды d2lbook и syne-tune.
Реализуйте
LocalSearcherиз упражнения 2 в Section 19.2 в виде нового алгоритма поиска в Syne Tune. Подсказка: ознакомьтесь с этим руководством. В качестве альтернативы вы можете воспользоваться этим примером.Сравните ваш новый
LocalSearcherсRandomSearchна бенчмаркеDropoutMLP.