
17.1. Марковский процесс принятия решений (MDP)
В этом разделе мы обсудим, как формулировать задачи обучения с подкреплением с помощью марковских процессов принятия решений (MDP) и подробно опишем различные компоненты MDP.
17.1.1. Определение MDP
Марковский процесс принятия решений (MDP) (Bellman, 1957) — это модель, описывающая эволюцию состояния системы при применении различных действий. Для формирования MDP объединяется несколько различных величин.
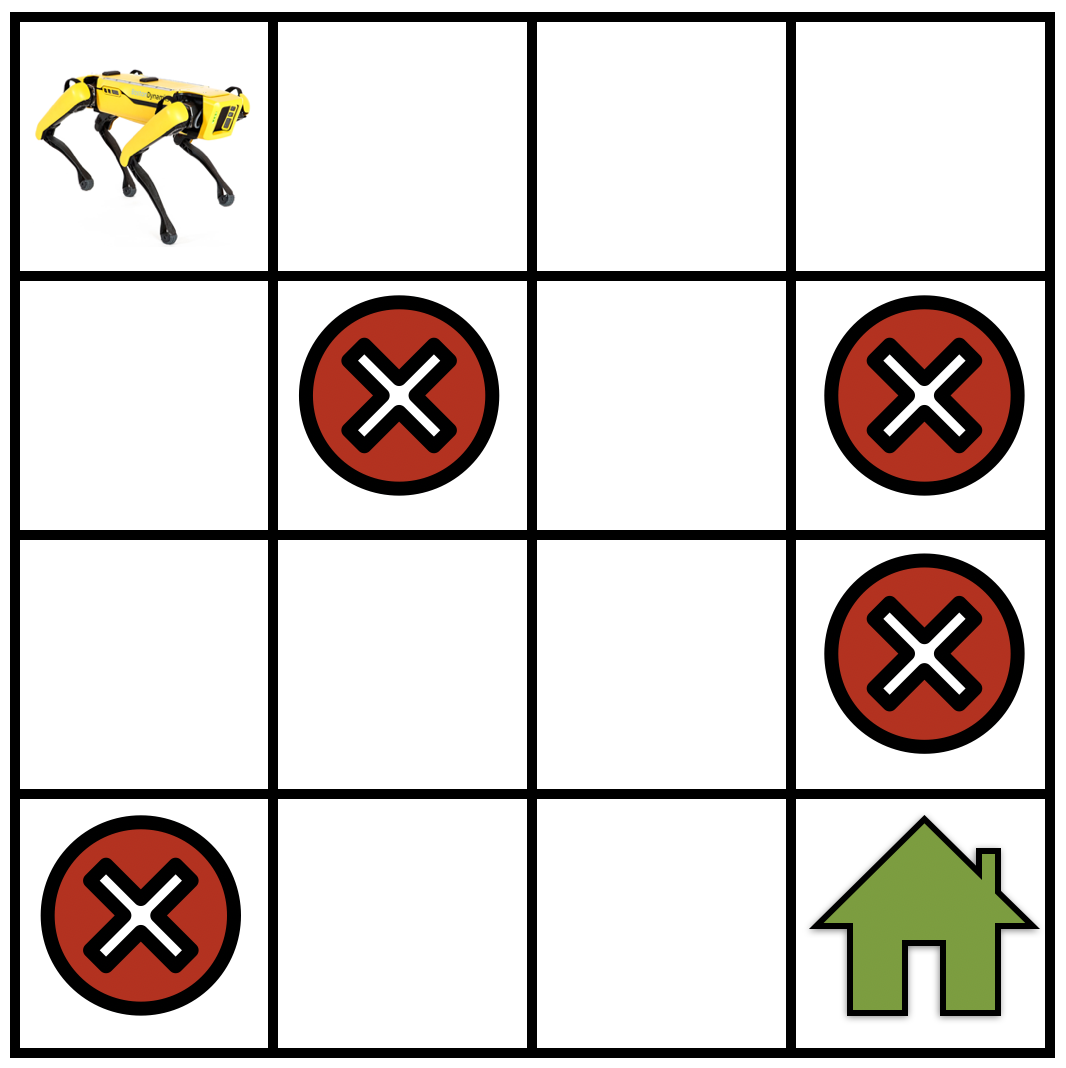
Fig. 17.1.1 Простая задача навигации в сеточном мире, где робот не только должен найти путь к целевой точке (обозначена зелёным домиком), но и избегать ловушек (обозначены красными крестиками).
Пусть \(\mathcal{S}\) — множество состояний в MDP. В качестве конкретного примера см. Fig. 17.1.1 для робота, перемещающегося по сетчатому миру. В этом случае \(\mathcal{S}\) соответствует множеству позиций, в которых робот может находиться в любой заданный момент времени.
Пусть \(\mathcal{A}\) — множество действий, которые робот может совершить в каждом состоянии, например, «идти вперед», «повернуть направо», «повернуть налево», «остаться на месте» и т. д. Действия могут переводить текущее состояние робота в другое состояние из множества \(\mathcal{S}\).
Может случиться так, что мы не знаем, как именно перемещается робот, а лишь знаем это с некоторым приближением. В обучении с подкреплением мы моделируем эту ситуацию следующим образом: если робот выполняет действие «идти вперёд», существует небольшая вероятность того, что он останется в текущем состоянии, небольшая вероятность того, что он «повернёт налево» и так далее. Математически это сводится к определению «функции перехода» \(T: \mathcal{S} \times \mathcal{A} \times \mathcal{S} \to [0,1]\), такой что \(T(s, a, s') = P(s' \mid s, a)\), где используется условная вероятность достижения состояния \(s'\) при условии, что робот находился в состоянии \(s\) и выполнил действие \(a\). Функция перехода является распределением вероятностей, поэтому для всех \(s \in \mathcal{S}\) и \(a \in \mathcal{A}\) выполняется условие \(\sum_{s' \in \mathcal{S}} T(s, a, s') = 1\), то есть робот должен перейти в какое-либо состояние, если он выполняет действие.
Теперь мы вводим понятие полезности тех или иных действий с помощью концепции «вознаграждения» \(r: \mathcal{S} \times \mathcal{A} \to \mathbb{R}\). Мы говорим, что робот получает вознаграждение \(r(s,a)\), если совершает действие \(a\) в состоянии \(s\). Если вознаграждение \(r(s, a)\) велико, это означает, что выполнение действия \(a\) в состоянии \(s\) более полезно для достижения цели робота, то есть для перемещения к зеленому дому. Если же вознаграждение \(r(s, a)\) мало, то действие \(a\) менее полезно для достижения этой цели. Важно отметить, что вознаграждение разрабатывается пользователем (тем, кто создает алгоритм обучения с подкреплением) с учётом поставленной цели.
17.1.2. Накопленная награда и коэффициент дисконтирования
Различные компоненты, описанные выше, вместе образуют марковский процесс принятия решений (MDP).
Рассмотрим теперь ситуацию, когда робот начинает движение из определённого состояния \(s_0 \in \mathcal{S}\) и продолжает выполнять действия, в результате чего формируется траектория
На каждом шаге времени \(t\) робот находится в состоянии \(s_t\) и совершает действие \(a_t\), что приводит к получению награды \(r_t = r(s_t, a_t)\). Суммарная награда траектории — это общая награда, полученная роботом вдоль такой траектории.
Цель обучения с подкреплением заключается в поиске траектории с максимальным возвратом.
Рассмотрим ситуацию, когда робот продолжает перемещаться по сетчатому миру, никогда не достигая целевой точки. В этом случае последовательность состояний и действий в траектории может быть бесконечно длинной, а возврат любой такой бесконечно длинной траектории будет бесконечным. Чтобы формулировка задачи обучения с подкреплением оставалась осмысленной даже для таких траекторий, мы вводим понятие коэффициента дисконтирования \(\gamma < 1\). Дисконтированный возврат записывается как
Обратите внимание, что если \(\gamma\) очень мало, награды, полученные роботом в отдалённом будущем, например \(t = 1000\), сильно дисконтируются множителем \(\gamma^{1000}\). Это стимулирует робота выбирать короткие траектории, ведущие к достижению цели, а именно — перемещение к зеленому дому в примере с сеткой (см. Fig. 17.1.1). При больших значениях коэффициента дисконтирования, например \(\gamma = 0.99\), робот поощряется к исследованию и поиску оптимальной траектории для достижения целевой локации.
17.1.3. Обсуждение марковского предположения
Давайте рассмотрим нового робота, у которого состояние \(s_t\) — это местоположение, как и ранее, но действие \(a_t\) представляет собой ускорение, которое робот прикладывает к своим колёсам, а не абстрактную команду вроде «идти вперёд». Если у этого робота в состоянии \(s_t\) есть ненулевая скорость, то следующее местоположение \(s_{t+1}\) зависит от предыдущего местоположения \(s_t\), ускорения \(a_t\), а также скорости робота в момент времени \(t\), которая пропорциональна \(s_t - s_{t-1}\). Это указывает на то, что нам следует
«Некоторая функция» в нашем случае — это закон движения Ньютона. Это существенно отличается от нашей функции перехода, которая зависит исключительно от \(s_t\) и \(a_t\).
Марковские системы — это системы, в которых следующее состояние \(s_{t+1}\) зависит только от текущего состояния \(s_t\) и действия \(a_t\), предпринятого в этом состоянии. В марковских системах следующее состояние не зависит от действий, предпринятых в прошлом, или от состояний, в которых находился робот ранее. Например, новый робот, у которого действием является ускорение, не является марковским, поскольку следующее местоположение \(s_{t+1}\) зависит от предыдущего состояния \(s_{t-1}\) через скорость. Может показаться, что марковское свойство системы является ограничивающим предположением, но это не так. Марковские процессы принятия решений всё ещё способны моделировать очень широкий класс реальных систем. Например, для нашего нового робота, если мы выберем состояние \(s_t\) в виде кортежа \((\textrm{location}, \textrm{velocity})\), то система станет марковской, поскольку её следующее состояние \((\textrm{location}_{t+1}, \textrm{velocity}_{t+1})\) зависит только от текущего состояния \((\textrm{location}_t, \textrm{velocity}_t)\) и действия в текущем состоянии \(a_t\).
17.1.4. Краткое изложение
Задача обучения с подкреплением обычно моделируется с помощью марковских процессов принятия решений. Марковский процесс принятия решений (МППР) определяется кортежем из четырёх элементов \((\mathcal{S}, \mathcal{A}, T, r)\), где \(\mathcal{S}\) — пространство состояний, \(\mathcal{A}\) — пространство действий, \(T\) — функция переходов, кодирующая вероятности переходов МППР, а \(r\) — немедленное вознаграждение, получаемое при совершении действия в определённом состоянии.
17.1.5. Упражнения
Предположим, что мы хотим разработать MDP для моделирования задачи MountainCar [https://www.gymlibrary.dev/environments/classic_control/mountain_car/].
Каков будет набор состояний?
Каков был бы набор действий?
Какие могут быть возможные функции вознаграждения?
Как вы спроектируете MDP для игры Atari, такой как Pong?