
9.3. Языковые модели
В разделе Section 9.2 мы рассмотрели, как преобразовывать текстовые последовательности в токены, которые можно рассматривать как последовательность дискретных наблюдений, таких как слова или символы. Предположим, что токены в текстовой последовательности длины \(T\) упорядочены \(x_1, x_2, \ldots, x_T\). Цель языковых моделей — оценить совместную вероятность всей последовательности:
где могут быть применены статистические инструменты из Section 9.1.
Языковые модели невероятно полезны. Например, идеальная языковая модель должна самостоятельно генерировать естественный текст, последовательно выбирая по одному токену \(x_t \sim P(x_t \mid x_{t-1}, \ldots, x_1)\). В отличие от обезьяны, печатающей на пишущей машинке, весь текст, генерируемый такой моделью, будет выглядеть как естественный язык, например, английский. Кроме того, для создания осмысленного диалога достаточно будет просто учитывать предыдущие фрагменты беседы. Очевидно, что мы всё ещё очень далеки от создания подобной системы, поскольку ей потребуется не просто генерировать грамматически корректный контент, а понимать текст.
Тем не менее, языковые модели приносят большую пользу даже в их ограниченном виде. Например, фразы «to recognize speech» (распознать речь) и «to wreck a nice beach» (разрушить прекрасный пляж) звучат очень похоже. Это может создавать неоднозначность при распознавании речи, которая легко разрешается с помощью языковой модели, отбрасывающей второй вариант как абсурдный. Аналогичным образом, в алгоритмах суммаризации документов полезно знать, что фраза «dog bites man» (собака кусает человека) встречается гораздо чаще, чем «man bites dog» (человек кусает собаку), или что выражение «I want to eat grandma» (я хочу съесть бабушку) звучит довольно пугающе, тогда как «I want to eat, grandma» (я хочу есть, бабушка) является вполне безобидным.
import torch
from d2l import torch as d2l
9.3.1. Обучение языковых моделей
Самый очевидный вопрос заключается в том, как следует моделировать документ или даже последовательность токенов. Предположим, что мы токенизируем текстовые данные на уровне слов. Начнем с применения базовых правил вероятности:
Например, вероятность текстовой последовательности, содержащей четыре слова, задаётся следующим образом:
9.3.1.1. Модели Маркова и \(n\)-граммы
Среди рассмотренных в Section 9.1 моделей последовательностей применим марковские модели к языковому моделированию. Распределение над последовательностями удовлетворяет марковскому свойству первого порядка, если выполняется условие \(P(x_{t+1} \mid x_t, \ldots, x_1) = P(x_{t+1} \mid x_t)\). Более высокие порядки соответствуют более длинным зависимостям. Это приводит к ряду приближений, которые мы можем использовать для моделирования последовательности:
Формулы вероятностей, включающие одну, две и три переменные, обычно называются моделями униграмм, биграмм и триграмм соответственно. Для построения языковой модели нам необходимо вычислить вероятность слов и условную вероятность слова при условии предыдущих нескольких слов. Обратите внимание, что такие вероятности являются параметрами языковой модели.
9.3.1.2. Частота слов
Здесь мы предполагаем, что обучающий набор данных представляет собой большой текстовый корпус, такой как все статьи Википедии, Project Gutenberg и весь текст, опубликованный в интернете. Вероятность слов может быть вычислена на основе относительной частоты данного слова в обучающем наборе данных. Например, оценку \(\hat{P}(\textrm{deep})\) можно рассчитать как вероятность того, что любое предложение начинается со слова «deep». Более простой, хотя и менее точный подход заключается в подсчёте всех вхождений слова «deep» и делении этого числа на общее количество слов в корпусе. Этот метод работает достаточно хорошо, особенно для часто встречающихся слов. Далее мы можем попытаться оценить
где \(n(x)\) и \(n(x, x')\) — количество вхождений одиночных слов и последовательных пар слов соответственно. К сожалению, оценка вероятности пары слов несколько сложнее, поскольку вхождения фразы «deep learning» встречаются гораздо реже. В частности, для некоторых редких сочетаний слов может быть трудно найти достаточное количество вхождений для получения точных оценок. Как показывают эмпирические результаты в Section 9.2.5, ситуация ухудшается для сочетаний из трёх слов и более. Существует множество правдоподобных троек слов, которые мы, вероятно, не встретим в нашем наборе данных. Если мы не предложим способ присвоения таким сочетаниям ненулевых частот, мы не сможем использовать их в языковой модели. Если набор данных мал или слова встречаются очень редко, мы можем не найти ни одного такого вхождения.
9.3.1.3. Сглаживание Лапласа
Общей стратегией является использование сглаживания Лапласа. Решение заключается в добавлении небольшой константы ко всем частотам. Обозначим через \(n\) общее количество слов в обучающей выборке, а через \(m\) — количество уникальных слов. Это решение помогает справиться с одиночными встречами, например, посредством
Здесь \(\epsilon_1,\epsilon_2\) и \(\epsilon_3\) — гиперпараметры. Возьмем \(\epsilon_1\) в качестве примера: когда \(\epsilon_1 = 0\), сглаживание не применяется; когда \(\epsilon_1\) стремится к положительной бесконечности, \(\hat{P}(x)\) приближается к равномерной вероятности \(1/m\). Вышеописанное является довольно примитивным вариантом того, чего могут достичь другие методы (Wood et al., 2011).
К сожалению, подобные модели становятся слишком громоздкими довольно быстро по следующим причинам. Во-первых, как обсуждалось в Section 9.2.5, многие \(n\)-граммы встречаются крайне редко, что делает сглаживание Лапласа не очень подходящим для языкового моделирования. Во-вторых, нам необходимо хранить все подсчёты. В-третьих, это полностью игнорирует смысл слов. Например, слова «cat» (кошка) и «feline» (кошачий) должны встречаться в схожих контекстах. Настроить такие модели на дополнительные контексты довольно сложно, тогда как языковые модели на основе глубокого обучения хорошо подходят для учёта этих факторов. Наконец, длинные последовательности слов почти наверняка будут новыми, поэтому модель, которая просто подсчитывает частоту ранее встречавшихся последовательностей слов, неизбежно будет работать плохо. Поэтому в остальной части главы мы сосредоточимся на использовании нейронных сетей для языкового моделирования.
9.3.2. Перплексия
Далее обсудим, как измерить качество языковой модели, чтобы затем использовать эту метрику для оценки наших моделей в последующих разделах. Один из способов — оценить, насколько неожиданным является текст. Хорошая языковая модель способна с высокой точностью предсказывать следующие токены. Рассмотрим следующие варианты продолжения фразы «It is raining», предложенные различными языковыми моделями:
«На улице идёт дождь»
«Идет дождь из банановых деревьев»
«Идёт дождь из случайных символов»
С точки зрения качества, пример 1 явно лучше всего. Слова осмысленны и логически связны. Хотя он может не совсем точно отражать, какое слово следует семантически («в Сан-Франциско» и «зимой» были бы вполне разумными продолжениями), модель способна уловить, какого рода слово следует далее. Пример 2 значительно хуже, поскольку генерирует бессмысленное продолжение. Тем не менее, модель хотя бы научилась правильно писать слова и уловила некоторую степень корреляции между словами. Наконец, пример 3 указывает на плохо обученную модель, которая неадекватно описывает данные.
Мы можем оценить качество модели, вычислив правдоподобие последовательности. К сожалению, это число трудно интерпретировать и сложно сравнивать. В конце концов, короткие последовательности возникают гораздо чаще, чем длинные, поэтому оценка модели на магнуме Толстого «Война и мир» неизбежно даст гораздо меньшее правдоподобие, чем, скажем, на повести Сент-Экзюпери «Маленький принц». Нам не хватает аналога среднего значения.
Теория информации оказывается здесь весьма полезной. Мы определили понятия энтропии, неожиданности и перекрёстной энтропии, когда вводили софтмакс-регрессию (Section 4.1.3). Если мы хотим сжать текст, мы можем поставить задачу предсказания следующего токена по текущему набору токенов. Более качественная языковая модель должна позволять нам точнее предсказывать следующий токен. Следовательно, она должна позволять тратить меньше битов на сжатие последовательности. Таким образом, мы можем измерить это, вычислив среднюю по всем \(n\) токенам последовательности функцию потерь перекрёстной энтропии:
где \(P\) задаётся языковой моделью, а \(x_t\) — это фактический токен, наблюдаемый на шаге времени \(t\) в последовательности. Это делает показатели качества для документов разной длины сопоставимыми. По историческим причинам специалисты в области обработки естественного языка предпочитают использовать величину, называемую перплексией. Если говорить кратко, она равна экспоненте от (9.3.7):
Перплексия лучше всего понимается как величина, обратная геометрическому среднему числа реальных вариантов выбора следующего токена. Рассмотрим несколько случаев:
В лучшем случае модель всегда точно оценивает вероятность целевого токена как 1. В этом случае перплексия модели равна 1.
В худшем случае модель всегда предсказывает вероятность целевого токена равной 0. В этой ситуации перплексия стремится к положительной бесконечности.
На базовом уровне модель предсказывает равномерное распределение по всем доступным токенам словаря. В этом случае перплексия равна количеству уникальных токенов в словаре. По сути, если бы мы хранили последовательность без сжатия, это было бы наилучшим возможным способом её кодирования. Следовательно, это задаёт нетривиальную верхнюю границу, которую должна превзойти любая полезная модель.
9.3.3. Разбиение последовательностей
Мы будем разрабатывать языковые модели на основе нейронных сетей и использовать перплексивность для оценки того, насколько хорошо модель предсказывает следующий токен по текущему набору токенов в текстовых последовательностях. Прежде чем перейти к описанию модели, предположим, что она обрабатывает мини-батч последовательностей фиксированной длины за один проход. Возникает вопрос: как выбирать мини-батчи входных и целевых последовательностей случайным образом.
Предположим, что набор данных представляет собой последовательность
\(T\) индексов токенов в corpus. Мы разобьем её на
подпоследовательности, каждая из которых содержит \(n\) токенов
(временных шагов). Чтобы пройтись по (почти) всем токенам всего набора
данных в течение каждой эпохи и получить все возможные
подпоследовательности длины \(n\), мы можем внести элемент
случайности. Более конкретно, в начале каждой эпохи мы отбрасываем
первые \(d\) токенов, где \(d\in [0,n)\) выбирается равномерно
случайным образом. Оставшаяся часть последовательности затем разбивается
на \(m=\lfloor (T-d)/n \rfloor\) подпоследовательностей. Обозначим
через \(\mathbf x_t = [x_t, \ldots, x_{t+n-1}]\)
подпоследовательность длины \(n\), начинающуюся с токена \(x_t\)
на временном шаге \(t\). Полученные \(m\) подпоследовательностей
— это
\(\mathbf x_d, \mathbf x_{d+n}, \ldots, \mathbf x_{d+n(m-1)}.\)
Каждая подпоследовательность будет использоваться в качестве входной
последовательности для языковой модели.
Для языкового моделирования цель заключается в предсказании следующего токена на основе токенов, которые мы уже видели; следовательно, целевые переменные (метки) представляют собой исходную последовательность, сдвинутую на один токен. Целевая последовательность для любой входной последовательности \(\mathbf x_t\) имеет вид \(\mathbf x_{t+1}\) длины \(n\).
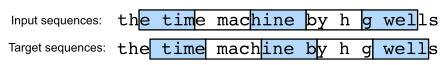
Fig. 9.3.1 Получение пяти пар входных и целевых последовательностей из разбиения подпоследовательностей длины 5.
Fig. 9.3.1 показывает пример получения пяти пар входных последовательностей и целевых переменных с помощью \(n=5\) и \(d=2\).
@d2l.add_to_class(d2l.TimeMachine)  #@save
def __init__(self, batch_size, num_steps, num_train=10000, num_val=5000):
    super(d2l.TimeMachine, self).__init__()
    self.save_hyperparameters()
    corpus, self.vocab = self.build(self._download())
    array = torch.tensor([corpus[i:i+num_steps+1]
                        for i in range(len(corpus)-num_steps)])
    self.X, self.Y = array[:,:-1], array[:,1:]
Для обучения языковых моделей мы будем случайным образом выбирать пары
входных и целевых последовательностей в мини-батчах. Приведённый ниже
загрузчик данных каждый раз случайным образом формирует мини-батч из
набора данных. Аргумент batch_size задает количество примеров
подпоследовательностей в каждом мини-батче, а num_steps — длину
подпоследовательности в токенах.
@d2l.add_to_class(d2l.TimeMachine)  #@save
def get_dataloader(self, train):
    idx = slice(0, self.num_train) if train else slice(
        self.num_train, self.num_train + self.num_val)
    return self.get_tensorloader([self.X, self.Y], train, idx)
Как видно далее, мини-батч целевых переменных можно получить, сдвинув входные последовательности на один токен.
data = d2l.TimeMachine(batch_size=2, num_steps=10)
for X, Y in data.train_dataloader():
    print('X:', X, '\nY:', Y)
    break
9.3.4. Итоги и обсуждение
Языковые модели оценивают совместную вероятность последовательности текста. Для длинных последовательностей n-граммы \(n\) предоставляют удобную модель за счёт усечения зависимости. Однако существует много структурных закономерностей, но недостаточно частотности для эффективной обработки редких сочетаний слов с помощью сглаживания Лапласа. Поэтому в последующих разделах мы сосредоточимся на нейронных языковых моделях. Для обучения языковых моделей мы можем случайным образом выбирать пары входных и целевых последовательностей в мини-пакетах. После обучения мы будем использовать перплексивность для оценки качества языковой модели.
Языковые модели можно масштабировать, увеличивая объём данных, размер модели и объём вычислений, затрачиваемых на обучение. Большие языковые модели способны выполнять поставленные задачи, предсказывая выходной текст по инструкциям в виде входного текста. Как мы обсудим позже (например, в Section 11.9), на данный момент большие языковые модели составляют основу современных систем, демонстрирующих наилучшие результаты в самых разных задачах.
9.3.5. Упражнения
Предположим, что в обучающем наборе данных содержится 100 000 слов. Какой объём данных о частоте слов и частоте соседних четырёхсловных последовательностей необходимо хранить для четырёхграммной модели?
Как смоделировать диалог?
Какие ещё методы вы можете придумать для чтения длинных последовательностей данных?
Рассмотрим наш метод отбрасывания случайного числа первых токенов в начале каждой эпохи.
Приводит ли это действительно к идеально равномерному распределению по последовательностям в документе?
Что нужно сделать, чтобы сделать всё ещё более однородным?
Если мы хотим, чтобы пример-последовательность представлял собой полное предложение, какую проблему это создаёт при выборке мини-батчей? Как можно её решить?