
14.9. Семантическая сегментация и набор данных
В разделах Section 14.3–Section 14.8, посвященных задачам обнаружения объектов, для разметки и предсказания объектов на изображениях используются прямоугольные ограничивающие рамки. В этом разделе мы обсудим задачу семантической сегментации, которая заключается в разделении изображения на области, относящиеся к различным семантическим классам. В отличие от обнаружения объектов, семантическая сегментация распознает и понимает, что именно содержится на изображении, на уровне пикселей: её разметка и предсказание семантических областей выполняются на уровне пикселей. На рисунке Fig. 14.9.1 показаны метки собаки, кошки и фона изображения при семантической сегментации. По сравнению с обнаружением объектов, границы, размеченные на уровне пикселей при семантической сегментации, оказываются значительно более детализированными.
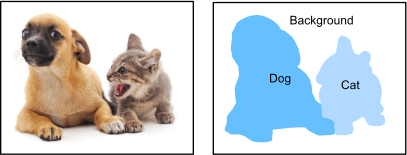
Fig. 14.9.1 Метки собаки, кошки и фона изображения при семантической сегментации.
14.9.1. Сегментация изображений и пообъектная сегментация
В области компьютерного зрения также существуют две важные задачи, схожие с семантической сегментацией, а именно сегментация изображений и сегментация объектов. Мы кратко рассмотрим их отличия от семантической сегментации.
Сегментация изображений разделяет изображение на несколько составляющих областей. Методы для решения этой задачи обычно используют корреляцию между пикселями. В процессе обучения им не требуется информация о метках пикселей, и они не могут гарантировать, что сегментированные области будут обладать той семантикой, которую мы ожидаем получить при прогнозировании. На примере изображения в Fig. 14.9.1 видно, что сегментация изображений может разделить собаку на две области: одну, охватывающую рот и глаза, которые в основном черные, и другую, охватывающую остальную часть тела, которая в основном желтая.
Сегментация объектов (instance segmentation) также называется одновременным обнаружением и сегментацией. Она изучает, как распознавать области на уровне пикселей для каждого объекта на изображении. В отличие от семантической сегментации, сегментация объектов должна различать не только семантику, но и различные объекты. Например, если на изображении есть две собаки, сегментация объектов должна определить, к какому из двух объектов принадлежит каждый пиксель.
14.9.2. Набор данных Pascal VOC2012 для семантической сегментации
Одним из наиболее важных наборов данных для семантической сегментации является Pascal VOC2012. В дальнейшем мы рассмотрим этот набор данных.
%matplotlib inline
import os
import torch
import torchvision
from d2l import torch as d2l
Тар-архив набора данных занимает около 2 ГБ, поэтому его загрузка может
занять некоторое время. Извлеченный набор данных находится по адресу
../data/VOCdevkit/VOC2012.
#@save
d2l.DATA_HUB['voc2012'] = (d2l.DATA_URL + 'VOCtrainval_11-May-2012.tar',
                           '4e443f8a2eca6b1dac8a6c57641b67dd40621a49')

voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
После ввода пути ../data/VOCdevkit/VOC2012 мы видим различные
компоненты набора данных. Путь ImageSets/Segmentation содержит
текстовые файлы, определяющие обучающие и тестовые примеры, тогда как
пути JPEGImages и SegmentationClass хранят входное изображение и
метку для каждого примера соответственно. Метка здесь также представлена
в виде изображения того же размера, что и соответствующее ему входное
изображение. Кроме того, пиксели одного цвета на любом изображении меток
принадлежат одному и тому же семантическому классу. Ниже определяется
функция read_voc_images для загрузки всех входных изображений и
меток в память.
#@save
def read_voc_images(voc_dir, is_train=True):
    """Read all VOC feature and label images."""
    txt_fname = os.path.join(voc_dir, 'ImageSets', 'Segmentation',
                             'train.txt' if is_train else 'val.txt')
    mode = torchvision.io.image.ImageReadMode.RGB
    with open(txt_fname, 'r') as f:
        images = f.read().split()
    features, labels = [], []
    for i, fname in enumerate(images):
        features.append(torchvision.io.read_image(os.path.join(
            voc_dir, 'JPEGImages', f'{fname}.jpg')))
        labels.append(torchvision.io.read_image(os.path.join(
            voc_dir, 'SegmentationClass' ,f'{fname}.png'), mode))
    return features, labels

train_features, train_labels = read_voc_images(voc_dir, True)
Мы нарисуем первые пять входных изображений и их метки. На изображениях меток белый и черный цвета обозначают границы и фон соответственно, тогда как другие цвета соответствуют различным классам.
n = 5
imgs = train_features[:n] + train_labels[:n]
imgs = [img.permute(1,2,0) for img in imgs]
d2l.show_images(imgs, 2, n);
Далее мы перечисляем значения цветов RGB и названия классов для всех меток в этом наборе данных.
#@save
VOC_COLORMAP = [[0, 0, 0], [128, 0, 0], [0, 128, 0], [128, 128, 0],
                [0, 0, 128], [128, 0, 128], [0, 128, 128], [128, 128, 128],
                [64, 0, 0], [192, 0, 0], [64, 128, 0], [192, 128, 0],
                [64, 0, 128], [192, 0, 128], [64, 128, 128], [192, 128, 128],
                [0, 64, 0], [128, 64, 0], [0, 192, 0], [128, 192, 0],
                [0, 64, 128]]

#@save
VOC_CLASSES = ['background', 'aeroplane', 'bicycle', 'bird', 'boat',
               'bottle', 'bus', 'car', 'cat', 'chair', 'cow',
               'diningtable', 'dog', 'horse', 'motorbike', 'person',
               'potted plant', 'sheep', 'sofa', 'train', 'tv/monitor']
Используя две константы, определённые выше, мы можем удобно найти индекс
класса для каждого пикселя в метке. Мы определяем функцию
voc_colormap2label для построения отображения от приведённых выше
значений RGB к индексам классов и функцию voc_label_indices для
преобразования любых значений RGB в их индексы классов в наборе данных
Pascal VOC2012.
#@save
def voc_colormap2label():
    """Build the mapping from RGB to class indices for VOC labels."""
    colormap2label = torch.zeros(256 ** 3, dtype=torch.long)
    for i, colormap in enumerate(VOC_COLORMAP):
        colormap2label[
            (colormap[0] * 256 + colormap[1]) * 256 + colormap[2]] = i
    return colormap2label

#@save
def voc_label_indices(colormap, colormap2label):
    """Map any RGB values in VOC labels to their class indices."""
    colormap = colormap.permute(1, 2, 0).numpy().astype('int32')
    idx = ((colormap[:, :, 0] * 256 + colormap[:, :, 1]) * 256
           + colormap[:, :, 2])
    return colormap2label[idx]
Например, в первом примере изображения индекс класса передней части самолета равен 1, тогда как индекс фона равен 0.
y = voc_label_indices(train_labels[0], voc_colormap2label())
y[105:115, 130:140], VOC_CLASSES[1]
14.9.2.1. Предобработка данных
В предыдущих экспериментах, таких как в Section 8.1–Section 8.4, изображения приводились к размеру, соответствующему требуемой входной форме модели. Однако в семантической сегментации это потребовало бы обратного масштабирования предсказанных классов пикселей к исходной форме входного изображения. Такое масштабирование может быть неточным, особенно для сегментированных областей с разными классами. Чтобы избежать этой проблемы, мы обрезаем изображение до фиксированной формы вместо его масштабирования. А именно, используя случайную обрезку из аугментации изображений, мы обрезаем одну и ту же область входного изображения и метки.
#@save
def voc_rand_crop(feature, label, height, width):
    """Randomly crop both feature and label images."""
    rect = torchvision.transforms.RandomCrop.get_params(
        feature, (height, width))
    feature = torchvision.transforms.functional.crop(feature, *rect)
    label = torchvision.transforms.functional.crop(label, *rect)
    return feature, label
imgs = []
for _ in range(n):
    imgs += voc_rand_crop(train_features[0], train_labels[0], 200, 300)

imgs = [img.permute(1, 2, 0) for img in imgs]
d2l.show_images(imgs[::2] + imgs[1::2], 2, n);
14.9.2.2. Пользовательский класс набора данных для семантической сегментации
Мы определяем пользовательский класс набора данных для семантической
сегментации VOCSegDataset, наследуя класс Dataset,
предоставляемый высокоуровневыми API. Реализуя метод __getitem__, мы
можем произвольно получать доступ к входному изображению с индексом
idx в наборе данных и к индексам классов каждого пикселя в этом
изображении. Поскольку некоторые изображения в наборе данных имеют
меньший размер, чем размер выходных данных случайной обрезки, эти
примеры отфильтровываются с помощью пользовательского фильтра
filter. Кроме того, мы также определяем метод normalize_image
для стандартизации значений трёх каналов RGB входных изображений.
#@save
class VOCSegDataset(torch.utils.data.Dataset):
    """A customized dataset to load the VOC dataset."""

    def __init__(self, is_train, crop_size, voc_dir):
        self.transform = torchvision.transforms.Normalize(
            mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
        self.crop_size = crop_size
        features, labels = read_voc_images(voc_dir, is_train=is_train)
        self.features = [self.normalize_image(feature)
                         for feature in self.filter(features)]
        self.labels = self.filter(labels)
        self.colormap2label = voc_colormap2label()
        print('read ' + str(len(self.features)) + ' examples')

    def normalize_image(self, img):
        return self.transform(img.float() / 255)

    def filter(self, imgs):
        return [img for img in imgs if (
            img.shape[1] >= self.crop_size[0] and
            img.shape[2] >= self.crop_size[1])]

    def __getitem__(self, idx):
        feature, label = voc_rand_crop(self.features[idx], self.labels[idx],
                                       *self.crop_size)
        return (feature, voc_label_indices(label, self.colormap2label))

    def __len__(self):
        return len(self.features)
14.9.2.3. Чтение набора данных
Мы используем пользовательский класс VOCSegDatase для создания
экземпляров обучающей и тестовой выборок соответственно. Предположим,
что мы указали, что форма случайно вырезанных изображений составляет
\(320\times 480\). Ниже показано количество примеров, сохранённых в
обучающей и тестовой выборках.
crop_size = (320, 480)
voc_train = VOCSegDataset(True, crop_size, voc_dir)
voc_test = VOCSegDataset(False, crop_size, voc_dir)
Задавая размер батча равным 64, мы определяем итератор данных для обучающей выборки. Выведем форму первого мини-батча. В отличие от задач классификации изображений или обнаружения объектов, метки здесь являются трёхмерными тензорами.
batch_size = 64
train_iter = torch.utils.data.DataLoader(voc_train, batch_size, shuffle=True,
                                    drop_last=True,
                                    num_workers=d2l.get_dataloader_workers())
for X, Y in train_iter:
    print(X.shape)
    print(Y.shape)
    break
14.9.2.4. Собираем всё вместе
Наконец, мы определяем следующую load_data_voc функцию для загрузки
и чтения набора данных семантической сегментации Pascal VOC2012. Она
возвращает итераторы данных как для обучающего, так и для тестового
наборов данных.
#@save
def load_data_voc(batch_size, crop_size):
    """Load the VOC semantic segmentation dataset."""
    voc_dir = d2l.download_extract('voc2012', os.path.join(
        'VOCdevkit', 'VOC2012'))
    num_workers = d2l.get_dataloader_workers()
    train_iter = torch.utils.data.DataLoader(
        VOCSegDataset(True, crop_size, voc_dir), batch_size,
        shuffle=True, drop_last=True, num_workers=num_workers)
    test_iter = torch.utils.data.DataLoader(
        VOCSegDataset(False, crop_size, voc_dir), batch_size,
        drop_last=True, num_workers=num_workers)
    return train_iter, test_iter
14.9.3. Итоги
Семантическая сегментация распознаёт и определяет, что изображено на картинке, на уровне пикселей, разделяя изображение на области, относящиеся к различным семантическим классам.
Одним из наиболее важных наборов данных для семантической сегментации является Pascal VOC2012.
В семантической сегментации, поскольку входное изображение и метка соответствуют друг другу пиксель в пиксель, входное изображение случайным образом вырезается до фиксированной формы, а не масштабируется.
14.9.4. Упражнения
Как семантическая сегментация может применяться в автономных транспортных средствах и медицинской диагностике изображений? Можете ли вы придумать другие области применения?
Вспомните описания аугментации данных в Section 14.1. Какие из методов аугментации изображений, используемых в классификации изображений, было бы невозможно применить в семантической сегментации?