
7.6. Свёрточные нейронные сети (LeNet)
Теперь у нас есть все необходимые компоненты для создания полнофункциональной свёрточной нейронной сети. В предыдущих разделах, посвященных работе с изображениями, мы применяли линейную модель с софтмакс-регрессией (Section 4.4) и многослойный персептрон (MLP) (Section 5.2) к изображениям одежды из набора данных Fashion-MNIST. Чтобы сделать такие данные пригодными для обработки, мы сначала преобразовали каждое изображение из двумерной матрицы (\(28\times28\)) в вектор фиксированной размерности (\(784\)), а затем обрабатывали их в полносвязных слоях. Теперь, когда мы освоили свёрточные слои, мы можем сохранять пространственную структуру изображений. В качестве дополнительного преимущества замены полносвязных слоёв на свёрточные мы получим более экономичные модели, требующие значительно меньшего количества параметров.
В этом разделе мы представим LeNet, одну из первых опубликованных свёрточных нейронных сетей, привлекших широкое внимание благодаря своей эффективности в задачах компьютерного зрения. Модель была предложена Янном Лекюном (и названа в его честь), который в то время работал исследователем в Bell Labs компании AT&T, для распознавания рукописных цифр на изображениях (LeCun et al., 1998). Эта работа стала итогом десятилетия исследований в области разработки соответствующих технологий; команда Лекюна опубликовала первое исследование, в котором успешно обучила свёрточные нейронные сети с помощью обратного распространения ошибки (LeCun et al., 1989).
В то время LeNet показывал выдающиеся результаты, сопоставимые с производительностью машин опорных векторов, которые тогда были доминирующим подходом в обучении с учителем, достигая ошибки менее 1% на каждую цифру. Впоследствии LeNet был адаптирован для распознавания цифр при обработке депозитов в банкоматах. И по сей день некоторые банкоматы всё ещё используют код, написанный Янником Лекуном и его коллегой Леоном Боттоу в 1990-х годах!
import torch
from torch import nn
from d2l import torch as d2l
7.6.1. LeNet
В общих чертах LeNet (LeNet-5) состоит из двух частей: (i) свёрточного кодировщика, включающего два свёрточных слоя; и (ii) плотного блока, состоящего из трёх полносвязных слоёв. Архитектура приведена на рисунке Fig. 7.6.1.
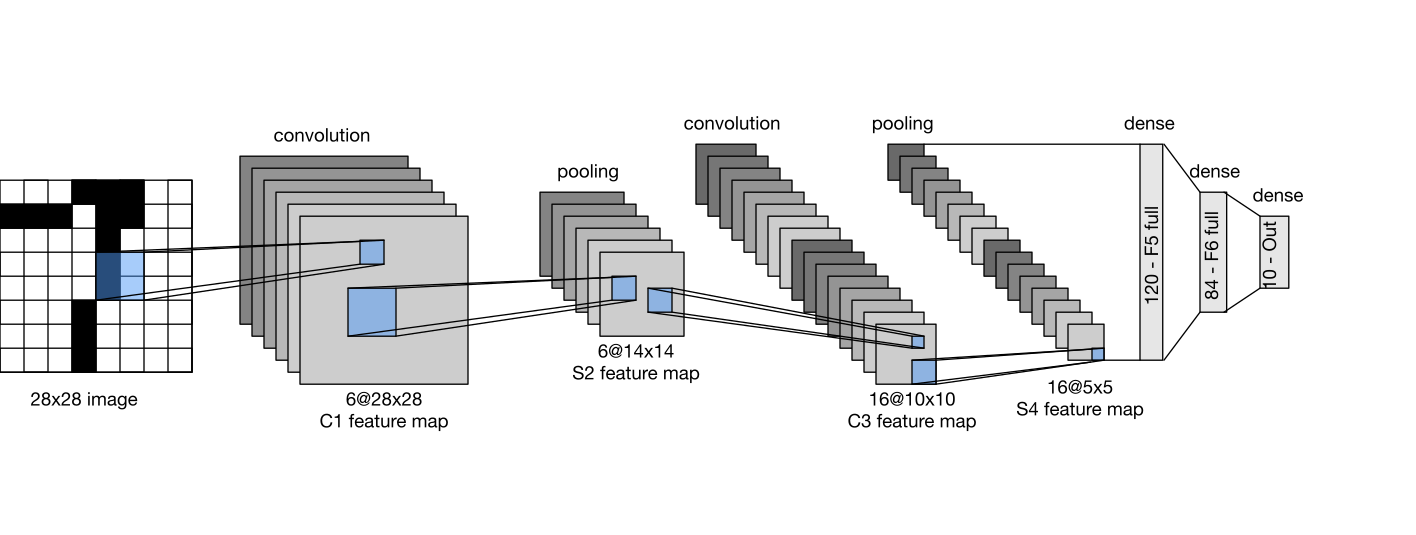
Fig. 7.6.1 Поток данных в LeNet. На вход подаётся рукописная цифра, а на выходе получается вероятность для одного из 10 возможных исходов.
Базовыми элементами каждого свёрточного блока являются свёрточный слой, функция активации сигмоиды и последующая операция усредняющего пулинга. Обратите внимание, что хотя ReLU и максимальный пулинг работают лучше, на момент разработки LeNet они ещё не были открыты. Каждый свёрточный слой использует \(5\times 5\) ядро и функцию активации сигмоиды. Эти слои отображают пространственно упорядоченные входы на множество двумерных карт признаков, как правило, увеличивая количество каналов. Первый свёрточный слой имеет 6 выходных каналов, а второй — 16. Каждая операция \(2\times2\) пулинга (шаг 2) уменьшает размерность в \(4\) раза за счет пространственного уменьшения разрешения. Свёрточный блок выдает результат со ⟨shape⟩, заданным как (размер батча, количество каналов, высота, ширина).
Чтобы передать выход свёрточного блока в плотный блок, необходимо выполнить операцию разворачивания (flatten) каждого примера в мини-батче. Иными словами, мы преобразуем этот четырёхмерный вход в двухмерный, ожидаемый полносвязными слоями: напомним, что требуемое двухмерное представление использует первую размерность для индексации примеров в мини-батче, а вторую — для хранения плоского векторного представления каждого примера. Плотный блок LeNet состоит из трёх полносвязных слоёв с 120, 84 и 10 выходами соответственно. Поскольку мы по-прежнему выполняем классификацию, выходной слой размерности 10 соответствует количеству возможных классов.
Хотя для того, чтобы по-настоящему понять, что происходит внутри LeNet,
потребовалось некоторое усилие, мы надеемся, что следующий фрагмент кода
убедит вас в том, что реализация таких моделей с помощью современных
фреймворков глубокого обучения удивительно проста. Нам нужно лишь
создать экземпляр блока Sequential и соединить соответствующие слои,
используя инициализацию Xavier, описанную в Section 5.4.2.2.
def init_cnn(module):  #@save
    """Initialize weights for CNNs."""
    if type(module) == nn.Linear or type(module) == nn.Conv2d:
        nn.init.xavier_uniform_(module.weight)
class LeNet(d2l.Classifier):  #@save
    """The LeNet-5 model."""
    def __init__(self, lr=0.1, num_classes=10):
        super().__init__()
        self.save_hyperparameters()
        self.net = nn.Sequential(
            nn.LazyConv2d(6, kernel_size=5, padding=2), nn.Sigmoid(),
            nn.AvgPool2d(kernel_size=2, stride=2),
            nn.LazyConv2d(16, kernel_size=5), nn.Sigmoid(),
            nn.AvgPool2d(kernel_size=2, stride=2),
            nn.Flatten(),
            nn.LazyLinear(120), nn.Sigmoid(),
            nn.LazyLinear(84), nn.Sigmoid(),
            nn.LazyLinear(num_classes))
Мы внесли некоторые изменения при воспроизведении LeNet, заменив слой с гауссовой функцией активации на слой софтмакс. Это значительно упрощает реализацию, в том числе потому, что гауссовский декодировщик в настоящее время практически не используется. В остальном эта сеть соответствует оригинальной архитектуре LeNet-5.
Рассмотрим, что происходит внутри сети. Пропустив одноканальное (чёрно-белое) \(28 \times 28\) изображение через сеть и выведя форму выходных данных на каждом слое, мы можем проверить модель, чтобы убедиться, что её операции соответствуют нашим ожиданиям от Fig. 7.6.2.
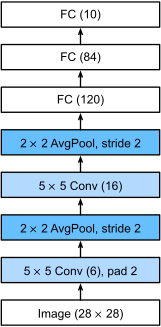
Fig. 7.6.2 Сжатое представление для LeNet-5.
@d2l.add_to_class(d2l.Classifier)  #@save
def layer_summary(self, X_shape):
    X = torch.randn(*X_shape)
    for layer in self.net:
        X = layer(X)
        print(layer.__class__.__name__, 'output shape:\t', X.shape)

model = LeNet()
model.layer_summary((1, 1, 28, 28))
Обратите внимание, что высота и ширина представления на каждом слое свёрточного блока уменьшаются (по сравнению с предыдущим слоем). Первый свёрточный слой использует дополнение в два пикселя, чтобы компенсировать уменьшение высоты и ширины, которое возникло бы при использовании ядра размера \(5 \times 5\). Для справки, размер изображения в наборе данных распознавания рукописного текста MNIST составляет \(28 \times 28\) пикселей, что является результатом обрезки двух строк (и столбцов) пикселей от исходных сканов, имевших размер \(32 \times 32\) пикселей. Это было сделано прежде всего для экономии места (на 30%) в эпоху, когда каждый мегабайт имел значение.
В отличие от этого, второй свёрточный слой не использует дополнение, поэтому высота и ширина уменьшаются на четыре пикселя. По мере продвижения вверх по стеку слоёв количество каналов увеличивается от слоя к слою: с 1 на входе до 6 после первого свёрточного слоя и до 16 после второго свёрточного слоя. Однако каждый слой пулинга уменьшает высоту и ширину вдвое. Наконец, каждый полносвязный слой снижает размерность, в итоге выдавая выход, размерность которого соответствует количеству классов.
7.6.2. Обучение
Теперь, когда мы реализовали модель, давайте проведём эксперимент, чтобы оценить, как модель LeNet-5 справляется с набором данных Fashion-MNIST.
Хотя в свёрточных нейронных сетях (CNN) параметров меньше, их вычисление
может обходиться дороже, чем в многослойных персептронах (MLP)
аналогичной глубины, поскольку каждый параметр участвует во множестве
операций умножения. Если у вас есть доступ к графическому процессору
(GPU), сейчас самое время использовать его для ускорения обучения.
Обратите внимание, что класс d2l.Trainer берёт на себя все детали
реализации. По умолчанию он инициализирует параметры модели на доступных
устройствах. Как и в случае с MLP, нашей функцией потерь является
перекрёстная энтропия, и мы минимизируем её с помощью стохастического
градиентного спуска на мини-батчах.
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128)
model = LeNet(lr=0.1)
model.apply_init([next(iter(data.get_dataloader(True)))[0]], init_cnn)
trainer.fit(model, data)
7.6.3. Резюме
В этой главе мы достигли значительного прогресса. Мы перешли от многослойных перцептронов (MLP) 1980-х годов к свёрточным нейронным сетям (CNN) 1990-х и начала 2000-х годов. Предложенные архитектуры, например LeNet-5, остаются актуальными и по сей день. Стоит сравнить ошибки классификации на наборе данных Fashion-MNIST, достигаемые с помощью LeNet-5, как с наилучшими возможными для MLP (Section 5.2), так и с теми, что показывают значительно более сложные архитектуры, такие как ResNet (Section 8.6). LeNet гораздо ближе ко вторым, чем к первым. Как мы увидим далее, одно из ключевых различий заключается в том, что возросшие вычислительные мощности позволили создавать значительно более сложные архитектуры.
Второе отличие заключается в относительной простоте реализации LeNet. То, что раньше было инженерной задачей, требовавшей месяцев работы на C++ и ассемблере, настройки инструментов вроде SN (одного из первых инструментов глубокого обучения на базе Lisp) (Bottou and Le Cun, 1988) и последующего экспериментирования с моделями, теперь можно выполнить за считанные минуты. Именно этот невероятный рост производительности кардинально демократизировал разработку моделей глубокого обучения. В следующей главе мы отправимся в это увлекательное путешествие, чтобы увидеть, куда оно нас приведет.
7.6.4. Упражнения
Давайте модернизируем LeNet. Реализуйте и протестируйте следующие изменения:
Замените пулинг усреднением на максимальный пулинг.
Замените слой софтмакс на ReLU.
Попробуйте изменить размер сети в стиле LeNet, чтобы повысить её точность, добавив к max-pooling и ReLU другие методы.
Измените размер окна свёртки.
Измените количество выходных каналов.
Измените количество слоёв свёртки.
Измените количество полносвязных слоёв.
Настройте скорости обучения и другие детали обучения (например, инициализацию и количество эпох).
Попробуйте улучшить сеть на исходном наборе данных MNIST.
Отобразите активации первого и второго слоя LeNet для различных входных данных (например, свитеров и пальто).
Что происходит с активациями, если подать в сеть существенно разные изображения (например, кошек, автомобили или даже случайный шум)?