
14.7. Однопроходное обнаружение с несколькими боксами
В разделах Section 14.3–Section 14.6 мы ввели понятия ограничивающих рамок, якорных рамок, обнаружения объектов на нескольких масштабах и набора данных для обнаружения объектов. Теперь мы готовы использовать эти знания для проектирования модели обнаружения объектов: одноэтапного многорамерного детектора (SSD) (Liu et al., 2016). Эта модель проста, быстра и широко используется. Хотя это лишь одна из множества моделей обнаружения объектов, некоторые принципы проектирования и детали реализации, рассмотренные в этом разделе, применимы и к другим моделям.
14.7.1. Модель
Fig. 14.7.1 дает обзор архитектуры детекции Single Shot Multibox. Эта модель в основном состоит из базовой сети, за которой следуют несколько блоков карт признаков с разными масштабами. Базовая сеть предназначена для извлечения признаков из входного изображения, поэтому в ней можно использовать глубокую свёрточную нейронную сеть (CNN). Например, в оригинальной статье по детекции Single Shot Multibox применяется сеть VGG, усеченная перед слоем классификации (Liu et al., 2016), а также часто используется ResNet. Благодаря нашему дизайну базовая сеть может выдавать карты признаков большего размера, что позволяет генерировать больше анкорных боксов для обнаружения мелких объектов. Далее каждый блок карт признаков с другим масштабом уменьшает (например, вдвое) высоту и ширину карт признаков, полученных на предыдущем блоке, и позволяет каждому элементу карт признаков увеличить свое рецептивное поле на входном изображении.
Вспомним архитектуру многомасштабного обнаружения объектов на основе послойных представлений изображений, формируемых глубокими нейронными сетями, описанную в Section 14.5. Поскольку карты признаков, расположенные ближе к верху Fig. 14.7.1, имеют меньший размер, но большее поле восприятия, они подходят для обнаружения меньшего числа, но более крупных объектов.
Если говорить кратко, благодаря базовой сети и нескольким блокам карт признаков разного масштаба модель single-shot multibox detection генерирует разное количество якорных боксов различных размеров и обнаруживает объекты разных размеров, предсказывая классы и смещения этих якорных боксов (а значит, и ограничивающих рамок); таким образом, это модель обнаружения объектов разного масштаба.
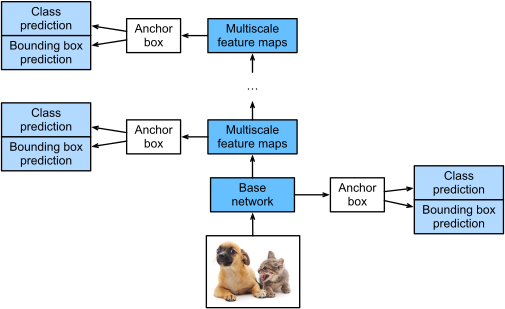
Fig. 14.7.1 Как модель обнаружения объектов, работающая с несколькими масштабами, single-shot multibox detection в основном состоит из базовой сети, за которой следуют несколько блоков карт признаков различных масштабов.
В дальнейшем мы опишем детали реализации различных блоков в Fig. 14.7.1. Для начала обсудим, как реализовать предсказание классов и ограничивающих рамок.
14.7.1.1. Слой предсказания классов
Пусть число классов объектов равно \(q\). Тогда якорные боксы имеют \(q+1\) классов, где класс 0 соответствует фону. На некотором масштабе предположим, что высота и ширина карт признаков равны \(h\) и \(w\) соответственно. Когда \(a\) якорных боксов генерируются с использованием каждой пространственной позиции этих карт признаков в качестве их центра, всего необходимо классифицировать \(hwa\) якорных боксов. Это часто делает классификацию с помощью полносвязных слоёв нецелесообразной из-за высоких затрат на параметризацию. Вспомним, как мы использовали каналы свёрточных слоёв для предсказания классов в Section 8.3. Одноэтапное многосчётное обнаружение использует ту же технику для снижения сложности модели.
В частности, слой предсказания классов использует свёрточный слой, не изменяющий ширину и высоту карт признаков. Таким образом, между выходами и входами при тех же пространственных размерах (ширине и высоте) карт признаков устанавливается взаимно однозначное соответствие. Более конкретно, каналы выходных карт признаков в любой пространственной позиции (\(x\), \(y\)) представляют предсказания классов для всех якорных рамок, центрированных в позиции (\(x\), \(y\)) входных карт признаков. Для получения корректных предсказаний должно быть \(a(q+1)\) выходных каналов, причём для одной и той же пространственной позиции выходной канал с индексом \(i(q+1) + j\) представляет предсказание класса \(j\) (\(0 \leq j \leq q\)) для якорной рамки \(i\) (\(0 \leq i < a\)).
Below we define such a class prediction layer, specifying \(a\) and
\(q\) via arguments num_anchors and num_classes,
respectively. This layer uses a \(3\times3\) convolutional layer
with a padding of 1. The width and height of the input and output of
this convolutional layer remain unchanged.
%matplotlib inline
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l


def cls_predictor(num_inputs, num_anchors, num_classes):
    return nn.Conv2d(num_inputs, num_anchors * (num_classes + 1),
                     kernel_size=3, padding=1)
14.7.1.2. Слой предсказания ограничивающих рамок
Проектирование слоя предсказания ограничивающих рамок аналогично проектированию слоя предсказания классов. Единственное отличие заключается в количестве выходов для каждой якорной рамки: здесь необходимо предсказать четыре смещения, а не \(q+1\) классов.
def bbox_predictor(num_inputs, num_anchors):
    return nn.Conv2d(num_inputs, num_anchors * 4, kernel_size=3, padding=1)
14.7.1.3. Объединение предсказаний для нескольких масштабов
Как мы упоминали, детектор объектов single-shot multibox использует многомасштабные карты признаков для генерации якорных боксов и предсказания их классов и смещений. На разных масштабах формы карт признаков или количество якорных боксов, центрированных на одном и том же элементе, могут различаться. Следовательно, формы выходных данных предсказаний на разных масштабах также могут различаться.
В следующем примере мы создадим карты признаков двух разных масштабов,
Y1 и Y2, для одного и того же мини-батча, где высота и ширина
Y2 в два раза меньше, чем у Y1. Рассмотрим в качестве примера
предсказание классов. Предположим, что для каждой ячейки в Y1 и
Y2 генерируется по 5 и 3 якорных бокса соответственно. Допустим
также, что количество классов объектов равно 10. Для карт признаков
Y1 и Y2 количество каналов в выходных данных предсказания
классов составляет \(5\times(10+1)=55\) и \(3\times(10+1)=33\)
соответственно, при этом форма каждого из этих выходов равна (размер
батча, количество каналов, высота, ширина).
def forward(x, block):
    return block(x)

Y1 = forward(torch.zeros((2, 8, 20, 20)), cls_predictor(8, 5, 10))
Y2 = forward(torch.zeros((2, 16, 10, 10)), cls_predictor(16, 3, 10))
Y1.shape, Y2.shape
Как мы видим, за исключением размерности батча, остальные три размерности имеют разные размеры. Чтобы объединить эти два выходных предсказания для более эффективных вычислений, мы преобразуем эти тензоры в более согласованный формат.
Обратите внимание, что в размерности каналов хранятся предсказания для якорных боксов с одинаковым центром. Сначала мы перемещаем эту размерность во внутреннюю. Поскольку размер батча остается неизменным для разных масштабов, мы можем преобразовать выходные данные предсказания в двумерный тензор с формой (размер батча, высота \(\times\) ширина \(\times\) количество каналов). Затем мы можем объединить такие выходные данные на разных масштабах по размерности 1.
def flatten_pred(pred):
    return torch.flatten(pred.permute(0, 2, 3, 1), start_dim=1)

def concat_preds(preds):
    return torch.cat([flatten_pred(p) for p in preds], dim=1)
Таким образом, даже если Y1 и Y2 имеют разные размеры по
каналам, высоте и ширине, мы по-прежнему можем объединять эти два
предсказания, полученные для двух разных масштабов, в рамках одного
мини-батча.
concat_preds([Y1, Y2]).shape
14.7.1.4. Блок уменьшения размера
Для обнаружения объектов на различных масштабах мы определяем следующий
блок уменьшения разрешения down_sample_blk, который уменьшает высоту
и ширину входных карт признаков вдвое. По сути, этот блок использует
архитектуру блоков VGG, описанную в Section 8.2.1. Более
конкретно, каждый блок уменьшения разрешения состоит из двух свёрточных
слоёв \(3\times3\) с дополнением (padding) равным 1, за которыми
следует слой максимального пулинга \(2\times2\) со шагом (stride) 2.
Как мы знаем, свёрточные слои \(3\times3\) с дополнением 1 не
изменяют форму карт признаков. Однако последующий максимальный пулинг
\(2\times2\) уменьшает высоту и ширину входных карт признаков вдвое.
Для входных и выходных карт признаков этого блока уменьшения разрешения,
поскольку \(1\times 2+(3-1)+(3-1)=6\), каждая единица в выходных
данных имеет рецептивное поле \(6\times6\) на входе. Таким образом,
блок уменьшения разрешения увеличивает рецептивное поле каждой единицы в
его выходных картах признаков.
def down_sample_blk(in_channels, out_channels):
    blk = []
    for _ in range(2):
        blk.append(nn.Conv2d(in_channels, out_channels,
                             kernel_size=3, padding=1))
        blk.append(nn.BatchNorm2d(out_channels))
        blk.append(nn.ReLU())
        in_channels = out_channels
    blk.append(nn.MaxPool2d(2))
    return nn.Sequential(*blk)
В следующем примере наш сконструированный блок уменьшения дискретизации изменяет количество входных каналов и уменьшает высоту и ширину входных признаков в два раза.
forward(torch.zeros((2, 3, 20, 20)), down_sample_blk(3, 10)).shape
14.7.1.5. Базовый блок сети
Базовый блок сети используется для извлечения признаков из входных изображений. Для простоты мы создадим небольшой базовый блок, состоящий из трёх блоков уменьшения размерности, в каждом из которых число каналов удваивается. Для входного изображения \(256\times256\) этот базовый блок сети выдаёт на выход \(32 \times 32\) карты признаков (\(256/2^3=32\)).
def base_net():
    blk = []
    num_filters = [3, 16, 32, 64]
    for i in range(len(num_filters) - 1):
        blk.append(down_sample_blk(num_filters[i], num_filters[i+1]))
    return nn.Sequential(*blk)

forward(torch.zeros((2, 3, 256, 256)), base_net()).shape
14.7.1.6. Полная модель
Полная модель обнаружения объектов одним проходом (single shot multibox detection) состоит из пяти блоков. Карты признаков, получаемые каждым блоком, используются как для (i) генерации якорных боксов, так и для (ii) предсказания классов и смещений этих якорных боксов. Среди этих пяти блоков первый является базовым блоком сети, второй–четвёртый — блоками уменьшения размера, а последний блок использует глобальный максимальный пулинг для уменьшения высоты и ширины до 1. Технически второй–пятый блоки представляют собой те самые блоки карт признаков многомасштабного представления из Fig. 14.7.1.
def get_blk(i):
    if i == 0:
        blk = base_net()
    elif i == 1:
        blk = down_sample_blk(64, 128)
    elif i == 4:
        blk = nn.AdaptiveMaxPool2d((1,1))
    else:
        blk = down_sample_blk(128, 128)
    return blk
Теперь мы определим прямое распространение для каждого блока. В отличие
от задач классификации изображений, выходные данные здесь включают (i)
карты признаков CNN Y, (ii) якорные боксы, сгенерированные с
использованием Y на текущем масштабе, и (iii) классы и смещения,
предсказанные (на основе Y) для этих якорных боксов.
def blk_forward(X, blk, size, ratio, cls_predictor, bbox_predictor):
    Y = blk(X)
    anchors = d2l.multibox_prior(Y, sizes=size, ratios=ratio)
    cls_preds = cls_predictor(Y)
    bbox_preds = bbox_predictor(Y)
    return (Y, anchors, cls_preds, bbox_preds)
Напомним, что в Fig. 14.7.1 блок карт признаков, расположенный
ближе к верху, предназначен для обнаружения более крупных объектов;
следовательно, он должен генерировать более крупные якорные рамки. В
приведённом выше прямом распространении на каждом блоке карт признаков
мы передаём список из двух значений масштаба через аргумент sizes
вызываемой функции multibox_prior (описанной в
Section 14.4). Далее интервал от 0,2 до 1,05 равномерно
разбивается на пять частей, чтобы определить меньшие значения масштаба
для пяти блоков: 0,2; 0,37; 0,54; 0,71 и 0,88. Затем их большие значения
масштаба вычисляются с помощью \(\sqrt{0.2 \times 0.37} = 0.272\),
\(\sqrt{0.37 \times 0.54} = 0.447\) и так далее.
sizes = [[0.2, 0.272], [0.37, 0.447], [0.54, 0.619], [0.71, 0.79],
         [0.88, 0.961]]
ratios = [[1, 2, 0.5]] * 5
num_anchors = len(sizes[0]) + len(ratios[0]) - 1
Теперь мы можем определить полную модель TinySSD следующим образом.
class TinySSD(nn.Module):
    def __init__(self, num_classes, **kwargs):
        super(TinySSD, self).__init__(**kwargs)
        self.num_classes = num_classes
        idx_to_in_channels = [64, 128, 128, 128, 128]
        for i in range(5):
            # Equivalent to the assignment statement `self.blk_i = get_blk(i)`
            setattr(self, f'blk_{i}', get_blk(i))
            setattr(self, f'cls_{i}', cls_predictor(idx_to_in_channels[i],
                                                    num_anchors, num_classes))
            setattr(self, f'bbox_{i}', bbox_predictor(idx_to_in_channels[i],
                                                      num_anchors))

    def forward(self, X):
        anchors, cls_preds, bbox_preds = [None] * 5, [None] * 5, [None] * 5
        for i in range(5):
            # Here `getattr(self, 'blk_%d' % i)` accesses `self.blk_i`
            X, anchors[i], cls_preds[i], bbox_preds[i] = blk_forward(
                X, getattr(self, f'blk_{i}'), sizes[i], ratios[i],
                getattr(self, f'cls_{i}'), getattr(self, f'bbox_{i}'))
        anchors = torch.cat(anchors, dim=1)
        cls_preds = concat_preds(cls_preds)
        cls_preds = cls_preds.reshape(
            cls_preds.shape[0], -1, self.num_classes + 1)
        bbox_preds = concat_preds(bbox_preds)
        return anchors, cls_preds, bbox_preds
Мы создаём экземпляр модели и используем его для выполнения прямого
распространения на мини-батче из \(256 \times 256\) изображений
X.
Как показано ранее в этом разделе, первый блок выдает \(32 \times 32\) карт признаков. Напомним, что блоки с уменьшением масштаба со второго по четвертый уменьшают высоту и ширину вдвое, а пятый блок использует глобальный пулинг. Поскольку для каждой ячейки вдоль пространственных размерностей карт признаков генерируется 4 якорные рамки, на всех пяти масштабах для каждого изображения генерируется в общей сложности \((32^2 + 16^2 + 8^2 + 4^2 + 1)\times 4 = 5444\) якорных рамок.
net = TinySSD(num_classes=1)
X = torch.zeros((32, 3, 256, 256))
anchors, cls_preds, bbox_preds = net(X)

print('output anchors:', anchors.shape)
print('output class preds:', cls_preds.shape)
print('output bbox preds:', bbox_preds.shape)
14.7.2. Обучение
Теперь мы объясним, как обучить модель обнаружения объектов Single Shot Multibox Detection.
14.7.2.1. Чтение набора данных и инициализация модели
Для начала давайте загрузим набор данных для обнаружения бананов, описанный в Section 14.6.
batch_size = 32
train_iter, _ = d2l.load_data_bananas(batch_size)
В наборе данных для обнаружения бананов присутствует только один класс. После определения модели нам необходимо инициализировать её параметры и определить алгоритм оптимизации.
device, net = d2l.try_gpu(), TinySSD(num_classes=1)
trainer = torch.optim.SGD(net.parameters(), lr=0.2, weight_decay=5e-4)
14.7.2.2. Определение функции потерь и функций оценки
В обнаружении объектов используются два типа функций потерь. Первая
функция потерь отвечает за классы якорных рамок: её вычисление может
просто повторно использовать функцию перекрёстной энтропии, которую мы
применяли для классификации изображений. Вторая функция потерь отвечает
за смещения положительных (не фоновых) якорных рамок: это задача
регрессии. Однако для этой задачи регрессии мы не используем
квадратичную функцию потерь, описанную в
Section 3.1.3. Вместо этого мы
используем функцию потерь на основе нормы \(\ell_1\), представляющую
собой абсолютное значение разницы между предсказанием и эталонным
значением. Переменная маски bbox_masks исключает отрицательные
якорные рамки и недопустимые (дополненные) якорные рамки из вычисления
функции потерь. В итоге мы суммируем функцию потерь для классов якорных
рамок и функцию потерь для смещений якорных рамок, чтобы получить
итоговую функцию потерь для модели.
cls_loss = nn.CrossEntropyLoss(reduction='none')
bbox_loss = nn.L1Loss(reduction='none')

def calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels, bbox_masks):
    batch_size, num_classes = cls_preds.shape[0], cls_preds.shape[2]
    cls = cls_loss(cls_preds.reshape(-1, num_classes),
                   cls_labels.reshape(-1)).reshape(batch_size, -1).mean(dim=1)
    bbox = bbox_loss(bbox_preds * bbox_masks,
                     bbox_labels * bbox_masks).mean(dim=1)
    return cls + bbox
We can use accuracy to evaluate the classification results. Due to the used \(\ell_1\) norm loss for the offsets, we use the mean absolute error to evaluate the predicted bounding boxes. These prediction results are obtained from the generated anchor boxes and the predicted offsets for them.
def cls_eval(cls_preds, cls_labels):
    # Because the class prediction results are on the final dimension,
    # `argmax` needs to specify this dimension
    return float((cls_preds.argmax(dim=-1).type(
        cls_labels.dtype) == cls_labels).sum())

def bbox_eval(bbox_preds, bbox_labels, bbox_masks):
    return float((torch.abs((bbox_labels - bbox_preds) * bbox_masks)).sum())
14.7.2.3. Обучение модели
При обучении модели необходимо генерировать якорные рамки на
нескольких масштабах (anchors) и предсказывать их классы
(cls_preds) и смещения (bbox_preds) в ходе прямого
распространения. Затем мы проставляем метки для классов
(cls_labels) и смещений (bbox_labels) этих якорных рамок на
основе информации о метках (Y). Наконец, вычисляем функцию
потерь на основе предсказанных и проставленных значений классов и
смещений. Для краткости изложения оценка на тестовом наборе данных
здесь опущена.
num_epochs, timer = 20, d2l.Timer()
animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                        legend=['class error', 'bbox mae'])
net = net.to(device)
for epoch in range(num_epochs):
    # Sum of training accuracy, no. of examples in sum of training accuracy,
    # Sum of absolute error, no. of examples in sum of absolute error
    metric = d2l.Accumulator(4)
    net.train()
    for features, target in train_iter:
        timer.start()
        trainer.zero_grad()
        X, Y = features.to(device), target.to(device)
        # Generate multiscale anchor boxes and predict their classes and
        # offsets
        anchors, cls_preds, bbox_preds = net(X)
        # Label the classes and offsets of these anchor boxes
        bbox_labels, bbox_masks, cls_labels = d2l.multibox_target(anchors, Y)
        # Calculate the loss function using the predicted and labeled values
        # of the classes and offsets
        l = calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels,
                      bbox_masks)
        l.mean().backward()
        trainer.step()
        metric.add(cls_eval(cls_preds, cls_labels), cls_labels.numel(),
                   bbox_eval(bbox_preds, bbox_labels, bbox_masks),
                   bbox_labels.numel())
    cls_err, bbox_mae = 1 - metric[0] / metric[1], metric[2] / metric[3]
    animator.add(epoch + 1, (cls_err, bbox_mae))
print(f'class err {cls_err:.2e}, bbox mae {bbox_mae:.2e}')
print(f'{len(train_iter.dataset) / timer.stop():.1f} examples/sec on '
      f'{str(device)}')
14.7.3. Предсказание
Во время предсказания цель состоит в том, чтобы обнаружить все значимые объекты на изображении. Ниже мы прочитаем и изменим размер тестового изображения, преобразовав его в четырёхмерный тензор, который требуется свёрточным слоям.
X = torchvision.io.read_image('../img/banana.jpg').unsqueeze(0).float()
img = X.squeeze(0).permute(1, 2, 0).long()
Используя функцию multibox_detection, предсказанные ограничивающие
рамки вычисляются на основе якорных рамок и их предсказанных смещений.
Затем применяется подавление немаксимумов для удаления похожих
предсказанных ограничивающих рамок.
def predict(X):
    net.eval()
    anchors, cls_preds, bbox_preds = net(X.to(device))
    cls_probs = F.softmax(cls_preds, dim=2).permute(0, 2, 1)
    output = d2l.multibox_detection(cls_probs, bbox_preds, anchors)
    idx = [i for i, row in enumerate(output[0]) if row[0] != -1]
    return output[0, idx]

output = predict(X)
Наконец, мы выводим все предсказанные ограничивающие рамки с уверенностью 0,9 или выше.
def display(img, output, threshold):
    d2l.set_figsize((5, 5))
    fig = d2l.plt.imshow(img)
    for row in output:
        score = float(row[1])
        if score < threshold:
            continue
        h, w = img.shape[:2]
        bbox = [row[2:6] * torch.tensor((w, h, w, h), device=row.device)]
        d2l.show_bboxes(fig.axes, bbox, '%.2f' % score, 'w')

display(img, output.cpu(), threshold=0.9)
14.7.4. Итог
Single Shot Multibox Detection — это модель обнаружения объектов, работающая с данными разных масштабов. С помощью базовой сети и нескольких блоков карт признаков, работающих на разных масштабах, Single Shot Multibox Detection генерирует переменное количество якорных боксов различных размеров и обнаруживает объекты разного размера, предсказывая классы и смещения этих якорных боксов (а следовательно, и ограничивающих рамок).
При обучении модели обнаружения объектов single-shot multibox функция потерь вычисляется на основе предсказанных и истинных значений классов и смещений якорных рамок.
14.7.5. Упражнения
Можно ли улучшить однократное обнаружение множественных объектов (single-shot multibox detection), улучшив функцию потерь? Например, замените \(\ell_1\) норму на гладкую \(\ell_1\) норму для предсказанных смещений. Эта функция потерь использует квадратичную функцию вблизи нуля для обеспечения гладкости, что контролируется гиперпараметром \(\sigma\):
Когда \(\sigma\) очень велико, эта функция потерь похожа на функцию потерь с нормой \(\ell_1\). При меньших значениях функция потерь становится более гладкой.
def smooth_l1(data, scalar):
    out = []
    for i in data:
        if abs(i) < 1 / (scalar ** 2):
            out.append(((scalar * i) ** 2) / 2)
        else:
            out.append(abs(i) - 0.5 / (scalar ** 2))
    return torch.tensor(out)

sigmas = [10, 1, 0.5]
lines = ['-', '--', '-.']
x = torch.arange(-2, 2, 0.1)
d2l.set_figsize()

for l, s in zip(lines, sigmas):
    y = smooth_l1(x, scalar=s)
    d2l.plt.plot(x, y, l, label='sigma=%.1f' % s)
d2l.plt.legend();
Кроме того, в эксперименте мы использовали перекрёстную энтропию в качестве функции потерь для предсказания классов: обозначая через \(p_j\) предсказанную вероятность истинного класса \(j\), перекрёстная энтропия определяется как \(-\log p_j\). Мы также можем использовать фокальную потерю (Lin et al., 2017): при заданных гиперпараметрах \(\gamma > 0\) и \(\alpha > 0\) эта функция потерь определяется следующим образом:
Как мы видим, увеличение \(\gamma\) может эффективно снизить относительную ошибку для хорошо классифицированных примеров (например, \(p_j > 0.5\)), благодаря чему обучение сможет больше фокусироваться на тех сложных примерах, которые были классифицированы неверно.
def focal_loss(gamma, x):
    return -(1 - x) ** gamma * torch.log(x)

x = torch.arange(0.01, 1, 0.01)
for l, gamma in zip(lines, [0, 1, 5]):
    y = d2l.plt.plot(x, focal_loss(gamma, x), l, label='gamma=%.1f' % gamma)
d2l.plt.legend();
Из-за ограничений по объёму мы опустили некоторые детали реализации модели обнаружения объектов Single Shot Multibox Detection в этом разделе. Можете ли вы улучшить модель в следующих аспектах:
Когда объект значительно меньше по размеру по сравнению с изображением, модель может увеличить входное изображение.
Обычно существует огромное количество отрицательных якорных боксов. Чтобы сделать распределение классов более сбалансированным, мы можем уменьшить выборку отрицательных якорных боксов.
В функции потерь задайте различные гиперпараметры весов для функции потерь класса и функции потерь смещения.
Используйте другие методы для оценки модели обнаружения объектов, например, те, что описаны в статье о методе одноэтапного многосчётного обнаружения (Liu et al., 2016).