
14.12. Перенос нейронного стиля
Если вы увлекаетесь фотографией, вы, вероятно, знакомы с фильтром. Он может менять цветовую стилистику фотографий, благодаря чему пейзажные снимки становятся более резкими, а на портретах кожа выглядит светлее. Однако один фильтр обычно изменяет лишь один аспект фотографии. Чтобы применить к фото идеальный стиль, вам, возможно, придется попробовать множество различных комбинаций фильтров. Этот процесс столь же сложен, как и настройка гиперпараметров модели.
В этом разделе мы используем послойные представления свёрточной нейронной сети для автоматического переноса стиля одного изображения на другое, то есть стилевого переноса (Gatys et al., 2016). Для этой задачи требуются два входных изображения: одно является изображением содержания, а другое — изображением стиля. Мы будем использовать нейронные сети для модификации изображения содержания так, чтобы его стиль стал близок к стилю изображения стиля. Например, изображение содержания в Fig. 14.12.1 — это пейзажная фотография, сделанная нами в национальном парке Маунт-Рейнер в пригородах Сиэтла, а изображение стиля представляет собой масляную живопись на тему осенних дубов. На синтезированном выходном изображении применяются масляные мазки стиля, что приводит к более ярким цветам, при этом сохраняется основная форма объектов на изображении содержания.
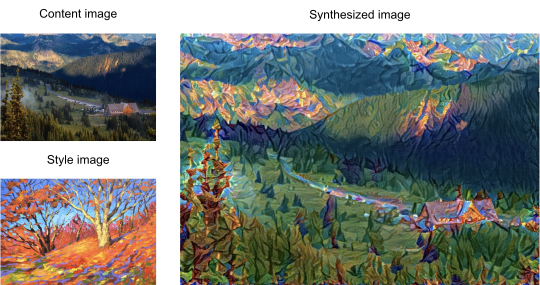
Fig. 14.12.1 При наличии изображений контента и стиля перенос стиля генерирует синтезированное изображение.
14.12.1. Метод
Fig. 14.12.2 иллюстрирует метод переноса стиля на основе свёрточной нейронной сети (CNN) на упрощённом примере. Сначала мы инициализируем синтезируемое изображение, например, используя исходное изображение с содержанием. Это синтезируемое изображение является единственной переменной, которую необходимо обновлять в процессе переноса стиля, то есть единственным параметром модели, подлежащим обновлению во время обучения. Затем мы выбираем предварительно обученную CNN для извлечения признаков изображения и фиксируем параметры этой модели на этапе обучения. Данная глубокая CNN использует несколько слоёв для извлечения иерархических признаков изображений. В качестве признаков содержания или признаков стиля можно выбрать выходные данные некоторых из этих слоёв. Возьмем для примера Fig. 14.12.2. Предварительно обученная нейронная сеть здесь имеет 3 свёрточных слоя, при этом второй слой выдает признаки содержания, а первый и третий слои — признаки стиля.
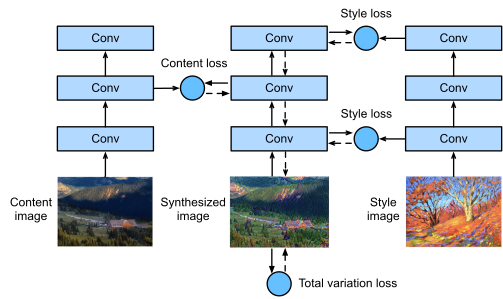
Fig. 14.12.2 Процесс переноса стиля на основе CNN. Сплошные линии показывают направление прямого распространения, а пунктирные — обратного распространения.
Далее мы вычисляем функцию потерь стилизации с помощью прямого распространения (направление сплошных стрелок) и обновляем параметры модели (синтезируемое изображение на выходе) с помощью обратного распространения ошибки (направление пунктирных стрелок). Функция потерь, обычно используемая в стилизации, состоит из трёх частей: (i) потери по содержанию обеспечивают близость синтезируемого изображения и изображения-содержания по признакам содержания; (ii) потери по стилю обеспечивают близость синтезируемого изображения и изображения-стиля по признакам стиля; и (iii) потери общей вариации помогают уменьшить шум в синтезируемом изображении. Наконец, после завершения обучения модели мы извлекаем параметры модели стилизации для генерации итогового синтезированного изображения.
В дальнейшем мы рассмотрим технические детали переноса стиля на конкретном примере.
14.12.2. Чтение изображений содержимого и стиля
Сначала прочитаем контентное и стилевое изображения. По напечатанным осям координат видно, что эти изображения имеют разные размеры.
%matplotlib inline
import torch
import torchvision
from torch import nn
from d2l import torch as d2l

d2l.set_figsize()
content_img = d2l.Image.open('../img/rainier.jpg')
d2l.plt.imshow(content_img);
style_img = d2l.Image.open('../img/autumn-oak.jpg')
d2l.plt.imshow(style_img);
14.12.3. Предобработка и постобработка
Ниже мы определяем две функции для предобработки и постобработки
изображений. Функция preprocess стандартизирует каждый из трёх
каналов RGB входного изображения и преобразует результаты в формат,
подходящий для ввода в свёрточную нейронную сеть. Функция
postprocess восстанавливает значения пикселей в выходном изображении
до их исходных значений до стандартизации. Поскольку функция вывода
изображения требует, чтобы каждый пиксель имел значение с плавающей
запятой в диапазоне от 0 до 1, мы заменяем любые значения меньше 0 или
больше 1 на 0 или 1 соответственно.
rgb_mean = torch.tensor([0.485, 0.456, 0.406])
rgb_std = torch.tensor([0.229, 0.224, 0.225])

def preprocess(img, image_shape):
    transforms = torchvision.transforms.Compose([
        torchvision.transforms.Resize(image_shape),
        torchvision.transforms.ToTensor(),
        torchvision.transforms.Normalize(mean=rgb_mean, std=rgb_std)])
    return transforms(img).unsqueeze(0)

def postprocess(img):
    img = img[0].to(rgb_std.device)
    img = torch.clamp(img.permute(1, 2, 0) * rgb_std + rgb_mean, 0, 1)
    return torchvision.transforms.ToPILImage()(img.permute(2, 0, 1))
14.12.4. Извлечение признаков
Мы используем модель VGG-19, предварительно обученную на наборе данных ImageNet, для извлечения признаков изображений (Gatys et al., 2016).
pretrained_net = torchvision.models.vgg19(pretrained=True)
Для извлечения контентных и стилистических признаков изображения мы
можем использовать выходы определённых слоёв сети VGG. Как правило, чем
ближе слой к входному, тем легче извлечь детали изображения, и наоборот,
чем дальше слой от входа, тем легче извлечь глобальную информацию об
изображении. Чтобы избежать чрезмерного сохранения деталей исходного
изображения в синтезированном изображении, мы выбираем слой VGG,
расположенный ближе к выходу, в качестве контентного слоя для
получения контентных признаков изображения. Мы также используем выходы
различных слоёв VGG для извлечения локальных и глобальных стилистических
признаков. Эти слои называются стилистическими слоями. Как упоминалось
в Section 8.2, сеть VGG состоит из 5 свёрточных блоков. В
эксперименте мы выбираем последний свёрточный слой четвёртого
свёрточного блока в качестве контентного слоя, а первый свёрточный слой
каждого свёрточного блока — в качестве стилистического слоя. Индексы
этих слоёв можно получить, распечатав объект pretrained_net.
style_layers, content_layers = [0, 5, 10, 19, 28], [25]
При извлечении признаков с помощью слоёв VGG нам достаточно использовать
все слои от входного слоя до слоя контента или стиля, ближайшего к
выходному слою. Создадим новый объект сети net, который содержит
только те слои VGG, которые будут использоваться для извлечения
признаков.
net = nn.Sequential(*[pretrained_net.features[i] for i in
                      range(max(content_layers + style_layers) + 1)])
При входных данных X, если просто выполнить прямое распространение
net(X), мы получим только выход последнего слоя. Поскольку нам также
нужны выходы промежуточных слоёв, необходимо выполнять вычисления
послойно и сохранять выходы слоёв контента и стиля.
def extract_features(X, content_layers, style_layers):
    contents = []
    styles = []
    for i in range(len(net)):
        X = net[i](X)
        if i in style_layers:
            styles.append(X)
        if i in content_layers:
            contents.append(X)
    return contents, styles
Ниже определены две функции: функция get_contents извлекает
контентные признаки из изображения-контента, а функция get_styles —
стилистические признаки из изображения-стиля. Поскольку во время
обучения нет необходимости обновлять параметры предварительно обученной
модели VGG, мы можем извлечь контентные и стилистические признаки ещё до
начала обучения. Поскольку синтезируемое изображение представляет собой
набор параметров модели, которые необходимо обновлять при переносе
стиля, мы можем извлекать контентные и стилистические признаки
синтезируемого изображения, вызывая функцию extract_features
непосредственно в процессе обучения.
def get_contents(image_shape, device):
    content_X = preprocess(content_img, image_shape).to(device)
    contents_Y, _ = extract_features(content_X, content_layers, style_layers)
    return content_X, contents_Y

def get_styles(image_shape, device):
    style_X = preprocess(style_img, image_shape).to(device)
    _, styles_Y = extract_features(style_X, content_layers, style_layers)
    return style_X, styles_Y
14.12.5. Определение функции потерь
Теперь мы опишем функцию потерь для переноса стиля. Функция потерь состоит из функции потерь по содержанию, функции потерь по стилю и функции потерь общей вариации.
14.12.5.1. Потеря содержимого
Как и в линейной регрессии, функция потерь по содержанию измеряет
разницу в признаках между синтезированным изображением и
изображением-источником с помощью квадратичной функции потерь. Оба
аргумента этой функции потерь являются выходами слоя содержания,
вычисленными с помощью функции extract_features.
def content_loss(Y_hat, Y):
    # We detach the target content from the tree used to dynamically compute
    # the gradient: this is a stated value, not a variable. Otherwise the loss
    # will throw an error.
    return torch.square(Y_hat - Y.detach()).mean()
14.12.5.2. Стилевая потеря
Стилевая функция потерь, аналогично функции потерь содержания,
использует функцию потерь квадрата разницы для измерения различий в
стиле между синтезированным изображением и изображением стиля. Чтобы
выразить вывод любого слоя стиля, мы сначала используем функцию
extract_features для вычисления вывода слоя стиля. Предположим, что
вывод содержит 1 пример, \(c\) каналов, высоту \(h\) и ширину
\(w\), мы можем преобразовать этот вывод в матрицу
\(\mathbf{X}\) с \(c\) строками и \(hw\) столбцами. Эту
матрицу можно рассматривать как конкатенацию \(c\) векторов
\(\mathbf{x}_1, \ldots, \mathbf{x}_c\), каждый из которых имеет
длину \(hw\). Здесь вектор \(\mathbf{x}_i\) представляет признак
стиля канала \(i\).
В матрице Грама этих векторов
\(\mathbf{X}\mathbf{X}^\top \in \mathbb{R}^{c \times c}\) элемент
\(x_{ij}\) в строке \(i\) и столбце \(j\) равен скалярному
произведению векторов \(\mathbf{x}_i\) и \(\mathbf{x}_j\). Он
представляет собой корреляцию стилевых признаков каналов \(i\) и
\(j\). Мы используем эту матрицу Грама для представления выхода
любого стилевого слоя. Обратите внимание, что при больших значениях
\(hw\) в матрице Грама, как правило, также получаются большие
значения. Кроме того, высота и ширина матрицы Грама равны количеству
каналов \(c\). Чтобы значение функции потерь стиля не зависело от
этих величин, функция gram, приведённая ниже, делит матрицу Грама на
количество её элементов, то есть \(chw\).
def gram(X):
    num_channels, n = X.shape[1], X.numel() // X.shape[1]
    X = X.reshape((num_channels, n))
    return torch.matmul(X, X.T) / (num_channels * n)
Очевидно, два входа матрицы Грама для функции потерь квадратичной ошибки
стилистических потерь основаны на выходах стилистического слоя для
синтезированного изображения и изображения-стиля. Здесь предполагается,
что матрица Грама gram_Y, основанная на изображении-стиле, уже
предварительно вычислена.
def style_loss(Y_hat, gram_Y):
    return torch.square(gram(Y_hat) - gram_Y.detach()).mean()
14.12.5.3. Функция потерь полной вариации
Иногда обученное синтезированное изображение содержит много высокочастотного шума, то есть особенно ярких или тёмных пикселей. Одним из распространённых методов снижения шума является сглаживание по методу полной вариации. Обозначим через \(x_{i, j}\) значение пикселя в координатах \((i, j)\). Снижение потери полной вариации
сближает значения соседних пикселей на синтезированном изображении.
def tv_loss(Y_hat):
    return 0.5 * (torch.abs(Y_hat[:, :, 1:, :] - Y_hat[:, :, :-1, :]).mean() +
                  torch.abs(Y_hat[:, :, :, 1:] - Y_hat[:, :, :, :-1]).mean())
14.12.5.4. Функция потерь
Функция потерь переноса стиля представляет собой взвешенную сумму функции потерь по содержанию, функции потерь по стилю и функции потерь по общей вариации. Регулируя эти весовые гиперпараметры, мы можем балансировать между сохранением содержания, переносом стиля и уменьшением шума на синтезированном изображении.
content_weight, style_weight, tv_weight = 1, 1e4, 10

def compute_loss(X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram):
    # Calculate the content, style, and total variance losses respectively
    contents_l = [content_loss(Y_hat, Y) * content_weight for Y_hat, Y in zip(
        contents_Y_hat, contents_Y)]
    styles_l = [style_loss(Y_hat, Y) * style_weight for Y_hat, Y in zip(
        styles_Y_hat, styles_Y_gram)]
    tv_l = tv_loss(X) * tv_weight
    # Add up all the losses
    l = sum(styles_l + contents_l + [tv_l])
    return contents_l, styles_l, tv_l, l
14.12.6. Инициализация синтезированного изображения
В переносе стиля синтезированное изображение — это единственная
переменная, которую необходимо обновлять в процессе обучения. Таким
образом, мы можем определить простую модель SynthesizedImage и
рассматривать синтезированное изображение в качестве параметров модели.
В этой модели прямое распространение просто возвращает параметры модели.
class SynthesizedImage(nn.Module):
    def __init__(self, img_shape, **kwargs):
        super(SynthesizedImage, self).__init__(**kwargs)
        self.weight = nn.Parameter(torch.rand(*img_shape))

    def forward(self):
        return self.weight
Далее мы определяем функцию get_inits. Эта функция создает объект
модели синтезированного изображения и инициализирует его изображением
X. Грам-матрицы для изображения стиля на различных слоях стиля,
styles_Y_gram, вычисляются до начала обучения.
def get_inits(X, device, lr, styles_Y):
    gen_img = SynthesizedImage(X.shape).to(device)
    gen_img.weight.data.copy_(X.data)
    trainer = torch.optim.Adam(gen_img.parameters(), lr=lr)
    styles_Y_gram = [gram(Y) for Y in styles_Y]
    return gen_img(), styles_Y_gram, trainer
14.12.7. Обучение
При обучении модели для переноса стиля мы непрерывно извлекаем контентные и стилистические признаки синтезированного изображения и вычисляем функцию потерь. Ниже определён цикл обучения.
def train(X, contents_Y, styles_Y, device, lr, num_epochs, lr_decay_epoch):
    X, styles_Y_gram, trainer = get_inits(X, device, lr, styles_Y)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_decay_epoch, 0.8)
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                            xlim=[10, num_epochs],
                            legend=['content', 'style', 'TV'],
                            ncols=2, figsize=(7, 2.5))
    for epoch in range(num_epochs):
        trainer.zero_grad()
        contents_Y_hat, styles_Y_hat = extract_features(
            X, content_layers, style_layers)
        contents_l, styles_l, tv_l, l = compute_loss(
            X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram)
        l.backward()
        trainer.step()
        scheduler.step()
        if (epoch + 1) % 10 == 0:
            animator.axes[1].imshow(postprocess(X))
            animator.add(epoch + 1, [float(sum(contents_l)),
                                     float(sum(styles_l)), float(tv_l)])
    return X
Теперь мы начинаем обучать модель. Мы изменяем высоту и ширину изображений контента и стиля до 300 на 450 пикселей. Для инициализации синтезированного изображения мы используем изображение контента.
device, image_shape = d2l.try_gpu(), (300, 450)  # PIL Image (h, w)
net = net.to(device)
content_X, contents_Y = get_contents(image_shape, device)
_, styles_Y = get_styles(image_shape, device)
output = train(content_X, contents_Y, styles_Y, device, 0.3, 500, 50)
Мы видим, что синтезированное изображение сохраняет пейзаж и объекты контентного примера, одновременно передавая цвет стилизованного. Например, в синтезированном изображении присутствуют цветовые блоки, подобные тем, что есть в стилизованном. Некоторые из этих блоков даже обладают тонкой текстурой мазков кисти.
14.12.8. Резюме
Функция потерь, обычно используемая в переносе стиля, состоит из трёх частей:
функция потерь по содержанию обеспечивает близость синтезированного и исходного изображений по признакам содержания;
функция потерь по стилю обеспечивает близость синтезированного и стилизованного изображений по признакам стиля;
функция потерь полной вариации помогает уменьшить шум в синтезированном изображении.
Мы можем использовать предварительно обученную свёрточную нейронную сеть для извлечения признаков изображения и минимизации функции потерь, чтобы непрерывно обновлять синтезированное изображение в качестве параметров модели в процессе обучения.
Мы используем матрицы Грама для представления стилевых признаков, извлеченных из стилевых слоёв.
14.12.9. Упражнения
Как изменяется выходной сигнал при выборе различных слоёв контента и стиля?
Настройте гиперпараметры весов в функции потерь. Сохраняет ли выходное изображение больше содержимого или имеет меньше шума?
Используйте другие изображения контента и стиля. Получаются ли более интересные синтезированные изображения?
Можно ли применить перенос стиля к тексту? Подсказка: обратитесь к обзорной статье Hu et al. (2022).