
11.9. Масштабное предобучение с помощью трансформеров
До сих пор в наших экспериментах по классификации изображений и машинному переводу модели обучались на наборах данных с примерами входных и выходных данных с нуля для выполнения конкретных задач. Например, трансформер обучался на парах английский–французский (Section 11.7), чтобы эта модель могла переводить входной английский текст на французский. В результате каждая модель становится специализированным экспертом, чувствительным даже к незначительным изменениям в распределении данных (Section 4.7). Для получения моделей с лучшей обобщающей способностью или даже более универсальных универсалов, способных выполнять множество задач как с адаптацией, так и без неё, всё чаще применяется предобучение моделей на больших объёмах данных.
При наличии больших данных для предобучения архитектура трансформера демонстрирует лучшие результаты при увеличении размера модели и вычислительных ресурсов, затрачиваемых на обучение, что подтверждает её превосходное поведение при масштабировании. В частности, качество языковых моделей на основе трансформеров подчиняется степенному закону в зависимости от количества параметров модели, количества обучающих токенов и вычислительных затрат на обучение (Kaplan et al., 2020). Масштабируемость трансформеров также подтверждается значительным ростом производительности больших визуальных трансформеров, обученных на больших объёмах данных (обсуждается в Section 11.8). Более недавние успешные примеры включают Gato — модель-универсала, которая может играть в Atari, подписывать изображения, общаться в чате и управлять роботом (Reed et al., 2022). Gato представляет собой единый трансформер, который хорошо масштабируется при предобучении на разнообразных модальностях, включая текст, изображения, моменты в суставах и нажатия кнопок. Примечательно, что все такие мультимодальные данные сериализуются в плоскую последовательность токенов, которые могут обрабатываться трансформерами аналогично текстовым токенам (Section 11.7) или фрагментам изображений (Section 11.8).
До впечатляющего успеха предобучения трансформеров на мультимодальных данных трансформеры активно предобучались на обширных текстовых корпусах. Изначально предложенные для машинного перевода, архитектура трансформера в Fig. 11.7.1 состоит из кодировщика для представления входных последовательностей и декодировщика для генерации целевых последовательностей. В основном трансформеры можно использовать в трёх различных режимах: только кодировщик, кодировщик–декодировщик и только декодировщик. В завершение этой главы мы рассмотрим эти три режима и объясним масштабируемость предобучения трансформеров.
11.9.1. Кодировщик
Когда используется только кодировщик трансформера, последовательность входных токенов преобразуется в такое же количество представлений, которые затем могут быть спроецированы на выход (например, для классификации). Кодировщик трансформера состоит из слоёв самовнимания, в которых все входные токены обращают внимание друг на друга. Например, визуальные трансформеры, показанные на рисунке Fig. 11.8.1, являются кодировщиками только, преобразующими последовательность входных фрагментов изображения в представление специального токена «<cls>». Поскольку это представление зависит от всех входных токенов, оно далее проецируется в метки классификации. Эта архитектура была вдохновлена более ранним кодировщиком трансформера, предварительно обученным на текстовых данных: BERT (Bidirectional Encoder Representations from Transformers) (Devlin et al., 2018).
11.9.1.1. Предобучение BERT
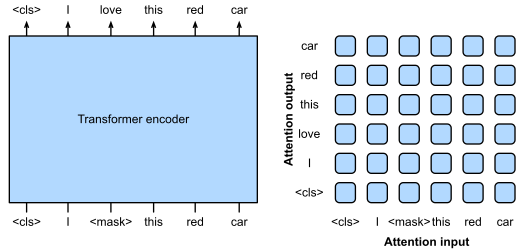
Fig. 11.9.1 Слева: предобучение BERT с использованием маскированного языкового моделирования. Предсказание замаскированного токена «love» зависит от всех входных токенов до и после него. Справа: паттерн внимания в кодировщике трансформера. Каждый токен по вертикальной оси обращает внимание на все входные токены по горизонтальной оси.
Предобучение BERT выполняется на текстовых последовательностях с использованием маскированного языкового моделирования: в кодировщик трансформера подается исходный текст, в котором случайным образом замаскированы некоторые токены, для предсказания этих замаскированных токенов. Как показано на рисунке Fig. 11.9.1, к исходной текстовой последовательности «I», «love», «this», «red», «car» добавляется токен «<cls>» в начало, а токен «<mask>» случайным образом заменяет «love»; затем в процессе предобучения минимизируется перекрёстная энтропия между замаскированным токеном «love» и его предсказанием. Обратите внимание, что в схеме внимания кодировщика трансформера (правая часть рисунка Fig. 11.9.1) отсутствуют ограничения, поэтому все токены могут взаимодействовать друг с другом. Таким образом, предсказание «love» зависит от токенов, стоящих до и после него в последовательности. Именно поэтому BERT называют «двунаправленным кодировщиком». Без необходимости ручной разметки для предобучения BERT можно использовать большие объёмы текстовых данных из книг и Википедии.
11.9.1.2. Дообучение BERT
Предобученную модель BERT можно дообучить для решения задач кодирования, связанных с одиночными текстами или парами текстов. В процессе дообучения к BERT можно добавлять дополнительные слои со случайными параметрами: эти параметры, а также предобученные параметры BERT, будут обновляться для подгонки под обучающие данные целевых задач.
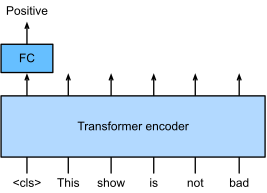
Fig. 11.9.2 Дообучение BERT для анализа тональности.
Fig. 11.9.2 иллюстрирует дообучение BERT для анализа тональности. Кодировщик трансформера представляет собой предварительно обученную модель BERT, которая принимает текстовую последовательность на вход и подаёт представление «<cls>» (глобальное представление входных данных) в дополнительный полносвязный слой для предсказания тональности. В процессе дообучения перекрёстная энтропия между предсказанием и меткой на данных для анализа тональности минимизируется с помощью алгоритмов, основанных на градиентах, при этом дополнительный слой обучается с нуля, а предварительно обученные параметры BERT обновляются. BERT применяется не только для анализа тональности. Общие языковые представления, полученные моделью BERT из 350 миллионов параметров на 250 миллиардах обучающих токенов, позволили достичь передовых результатов в таких задачах обработки естественного языка, как классификация одиночного текста, классификация пар текстов или регрессия, тегирование текста и ответ на вопросы.
Можно заметить, что эти задачи прикладного обучения включают понимание пар текстов. Предобучение BERT использует другую функцию потерь для предсказания того, следует ли одно предложение сразу за другим. Однако позже было обнаружено, что эта функция потерь оказалась менее полезной при предобучении RoBERTa — варианта BERT того же размера — на 2000 миллиардов токенов (Liu et al., 2019). Другие производные BERT улучшали архитектуру модели или цели предобучения, такие как ALBERT (обеспечивающий разделение параметров) (Lan et al., 2019), SpanBERT (представляющий и предсказывающий фрагменты текста) (Joshi et al., 2020), DistilBERT (облегчённый за счёт дистилляции знаний) (Sanh et al., 2019) и ELECTRA (обнаружение заменённых токенов) (Clark et al., 2020). Кроме того, BERT вдохновил на применение предобучения трансформеров в компьютерном зрении, например, с помощью Vision Transformers (Dosovitskiy et al., 2021), Swin Transformers (Liu et al., 2021) и MAE (маскированных автоэнкодеров) (He et al., 2022).
11.9.2. Кодировщик–Декодировщик
Поскольку кодировщик трансформера преобразует последовательность входных токенов в такое же количество выходных представлений, режим, использующий только кодировщик, не способен генерировать последовательность произвольной длины, как это требуется в машинном переводе. Как изначально предполагалось для машинного перевода, архитектура трансформера может быть дополнена декодировщиком, который авторегрессионно предсказывает целевую последовательность произвольной длины по одному токену, учитывая как выходные данные кодировщика, так и выходные данные декодировщика: (i) для учёта выходных данных кодировщика используется кросс-внимание между кодировщиком и декодировщиком (многоголовое внимание декодировщика в Fig. 11.7.1), что позволяет целевым токенам обращать внимание на все входные токены; (ii) учёт выходных данных декодировщика достигается с помощью так называемого каузального внимания (это название широко распространено в литературе, но является вводящим в заблуждение, поскольку оно мало связано с изучением причинно-следственных связей) (маскированное многоголовое внимание декодировщика в Fig. 11.7.1), при котором любой целевой токен может обращать внимание только на предыдущие и текущие токены в целевой последовательности.
Чтобы предобучить кодировщик–декодировщик Transformers на данных, выходящих за рамки размеченных человеком данных для машинного перевода, были предложены BART (Lewis et al., 2019) и T5 (Raffel et al., 2020) — две архитектуры кодировщик–декодировщик Transformers, предобученные на крупномасштабных текстовых корпусах. Обе модели стремятся восстановить исходный текст в рамках своих целей предобучения, при этом первая делает акцент на зашумлении входных данных (например, маскирование, удаление, перестановка и ротация), а вторая — на унификации множества задач, что подтверждается всесторонними исследованиями абляции.
11.9.2.1. Предобучение T5
В качестве примера предобученного трансформера с кодировщиком и декодировщиком рассмотрим T5 (Text-to-Text Transfer Transformer). Эта модель унифицирует множество задач, сводя их к единой проблеме преобразования текста в текст: для любой задачи входом кодировщика служит описание задачи (например, «Summarize» или «:»), за которым следует входные данные задачи (например, последовательность токенов из статьи), а декодировщик предсказывает выходные данные задачи (например, последовательность токенов, суммирующих входную статью). Для реализации подхода «текст в текст» T5 обучается генерировать некоторую целевую переменную при условии заданного входного текста.
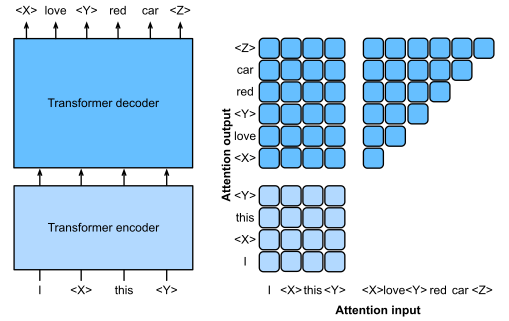
Fig. 11.9.3 Слева: предобучение T5 путем предсказания последовательных фрагментов. Исходное предложение состоит из токенов «I», «love», «this», «red», «car», где «love» заменен на специальный токен «<X>», а последовательные токены «red», «car» заменены на специальный токен «<Y>». Целевая последовательность заканчивается специальным токеном «<Z>». Справа: паттерн внимания в трансформере кодировщик–декодировщик. В самовнимании кодировщика (нижний квадрат) все входные токены обращают внимание друг на друга; во внимании кодировщик–декодировщик (верхний прямоугольник) каждый целевой токен обращает внимание на все входные токены; в самовнимании декодировщика (верхний треугольник) каждый целевой токен обращает внимание только на текущие и предыдущие целевые токены (каузально).
Для получения входных и выходных данных из любого исходного текста модель T5 предварительно обучается предсказывать последовательные фрагменты. Конкретнее, токены из текста случайным образом заменяются специальными токенами, при этом каждый последовательный фрагмент заменяется одним и тем же специальным токеном. Рассмотрим пример в Fig. 11.9.3, где исходный текст состоит из токенов “I”, “love”, “this”, “red”, “car”. Токены “love”, “red”, “car” случайным образом заменяются специальными токенами. Поскольку “red” и “car” образуют последовательный фрагмент, они заменяются одним и тем же специальным токеном. В результате входная последовательность имеет вид “I”, “<X>”, “this”, “<Y>”, а целевая последовательность — “<X>”, “love”, “<Y>”, “red”, “car”, “<Z>”, где “<Z>” — это ещё один специальный токен, обозначающий конец. Как показано в Fig. 11.9.3, декодировщик использует причинное внимание, чтобы предотвратить обращение к будущим токенам во время предсказания последовательности.
В T5 предсказание последовательных фрагментов также называют реконструкцией повреждённого текста. С этой целью модель T5 предварительно обучается на 1000 миллиардов токенов из корпуса C4 (Colossal Clean Crawled Corpus), который состоит из очищенного английского текста из интернета (Raffel et al., 2020).
11.9.2.2. Дообучение T5
Как и в случае с BERT, для выполнения задачи T5 необходимо дообучить (обновить параметры T5) на данных, специфичных для этой задачи. Основные отличия от дообучения BERT заключаются в следующем: (i) входные данные T5 содержат описание задачи; (ii) T5 способен генерировать последовательности произвольной длины с помощью своего декодировщика; (iii) дополнительные слои не требуются.
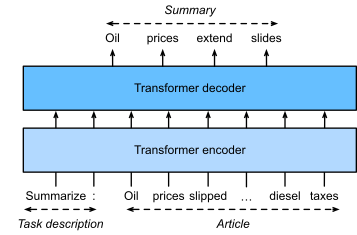
Fig. 11.9.4 Дообучение T5 для суммаризации текста. И описание задачи, и токены статьи подаются на вход кодировщика трансформера для предсказания суммаризации.
Fig. 11.9.4 демонстрирует дообучение T5 на примере суммаризации текста. В этой прикладной задаче на вход кодировщика подаются токены описания задачи «Summarize», «:», за которыми следуют токены статьи.
После дообучения модель T5-11B, содержащая 11 миллиардов параметров, достигла наилучших результатов на множестве бенчмарков для кодирования (например, классификация) и генерации (например, суммаризация). С момента выпуска T5 широко использовался в последующих исследованиях. Например, Switch Transformers были разработаны на основе T5 для активации подмножества параметров с целью повышения вычислительной эффективности (Fedus et al., 2022). В модели генерации изображений по тексту Imagen текст подается на замороженный кодировщик T5 (T5-XXL) с 4,6 миллиардами параметров (Saharia et al., 2022). Фотореалистичные примеры генерации изображений по тексту в Fig. 11.9.5 показывают, что кодировщик T5 способен эффективно представлять текст даже без дообучения.
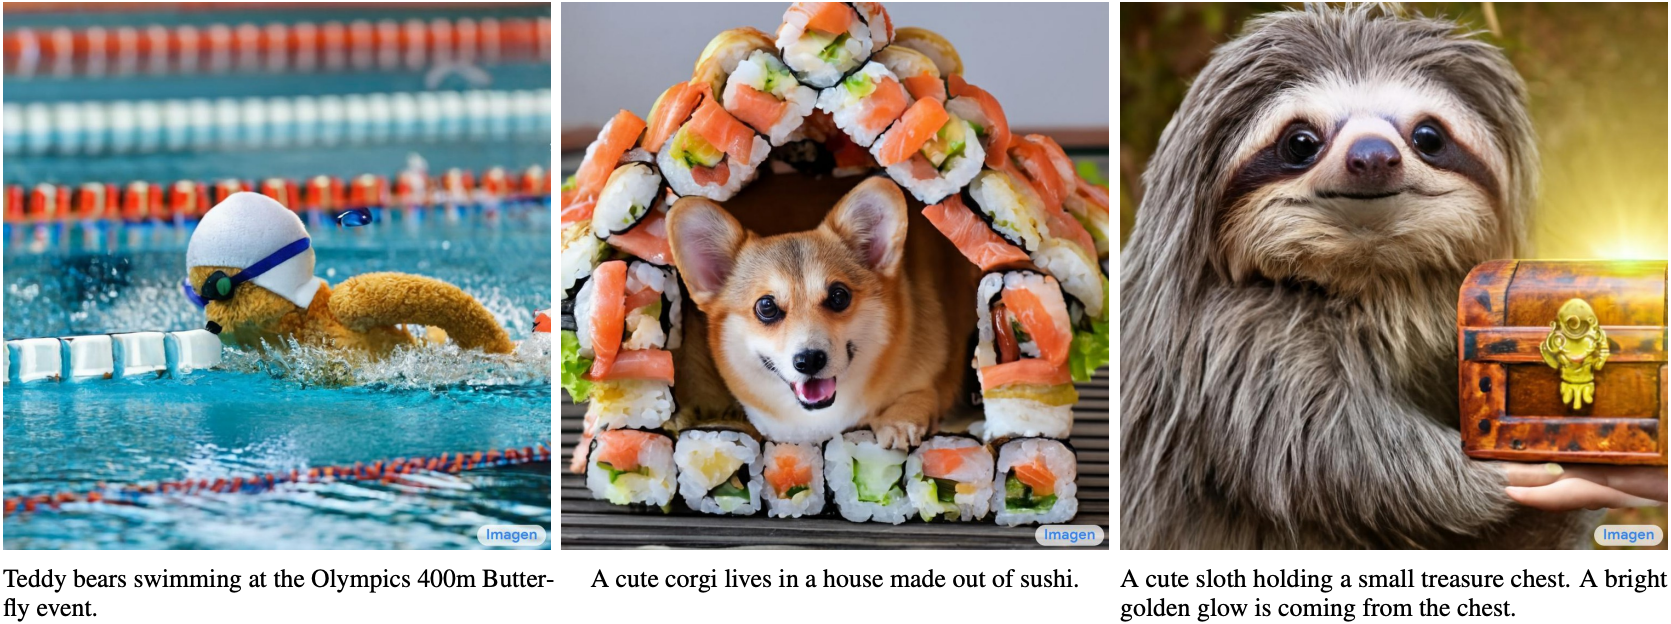
Fig. 11.9.5 Примеры преобразования текста в изображение моделью Imagen, текстовый кодировщик которой основан на T5 (изображения взяты из Saharia et al. (2022)).
11.9.3. Декодировщик
Мы рассмотрели архитектуры Transformer с кодировщиком и кодировщиком-декодировщиком. В архитектуре Transformer только с декодировщиком полностью исключаются кодировщик и подслой декодировщика с кросс-вниманием между кодировщиком и декодировщиком из исходной архитектуры кодировщик-декодировщик, показанной на рисунке Fig. 11.7.1. В настоящее время архитектуры Transformer только с декодировщиком стали де-факто стандартом для крупномасштабного языкового моделирования (Section 9.3), которое использует обилие немаркированных текстовых корпусов мира посредством самообучения.
11.9.3.1. GPT и GPT-2
Используя языковое моделирование в качестве цели обучения, модель GPT (генеративное предварительное обучение) выбирает трансформер-декодировщик в качестве основы (Radford et al., 2018).
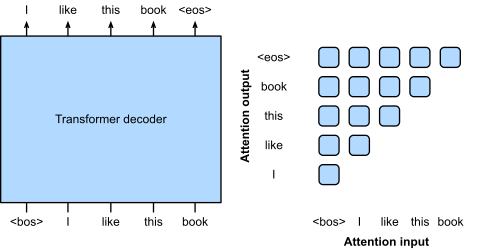
Fig. 11.9.6 Слева: предобучение GPT с помощью языкового моделирования. Целевая последовательность представляет собой входную последовательность, сдвинутую на один токен. «<bos>» и «<eos>» — это специальные токены, обозначающие начало и конец последовательности соответственно. Справа: паттерн внимания в декодировщике трансформера. Каждый токен по вертикальной оси обращает внимание только на свои предыдущие токены по горизонтальной оси (каузальное).
Следуя подходу к обучению авторегрессионной языковой модели, описанному в Section 9.3.3, на рисунке Fig. 11.9.6 показано предобучение GPT с использованием кодировщика трансформера, где целевая последовательность представляет собой входную последовательность, сдвинутую на один токен. Обратите внимание, что паттерн внимания в декодировщике трансформера гарантирует, что каждый токен может обращать внимание только на свои предыдущие токены (будущие токены недоступны для внимания, поскольку они ещё не были выбраны).
GPT содержит 100 миллионов параметров и требует дообучения для решения конкретных прикладных задач. Годом позже была представлена значительно более крупная языковая модель на основе декодировщика трансформера — GPT-2 (Radford et al., 2019). По сравнению с исходным декодировщиком трансформера в GPT, в GPT-2 были применены предварительная нормализация (обсуждаемая в Section 11.8.3), а также улучшенная инициализация и масштабирование весов. Предобученная на 40 ГБ текста, модель GPT-2 с 1,5 миллиарда параметров показала наилучшие результаты на бенчмарках языкового моделирования и перспективные результаты в ряде других задач без обновления параметров или архитектуры.
11.9.3.2. GPT-3 и далее
GPT-2 продемонстрировал потенциал использования одной и той же языковой модели для решения множества задач без обновления модели. Это более вычислительно эффективно, чем дообучение, которое требует обновления модели посредством вычисления градиентов.
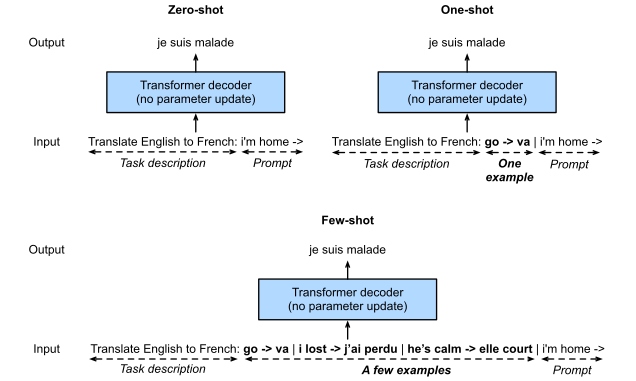
Fig. 11.9.7 Нулевое, одно- и несколько примеров в контекстном обучении с языковыми моделями (декодеры трансформеров). Обновление параметров не требуется.
Прежде чем перейти к более вычислительно эффективному использованию языковых моделей без обновления параметров, вспомним Section 9.5, что языковую модель можно обучить генерировать текстовую последовательность при условии заданной префиксной последовательности. Таким образом, предварительно обученная языковая модель может генерировать результат задачи в виде последовательности без обновления параметров при условии входной последовательности, содержащей описание задачи, примеры ввода-вывода, специфичные для задачи, и промпт (вход задачи). Эта парадигма обучения называется обучением в контексте (Brown et al., 2020), которое можно дополнительно разделить на zero-shot, one-shot и few-shot в зависимости от того, есть ли примеры ввода-вывода, специфичные для задачи, вообще, один или несколько (Fig. 11.9.7).
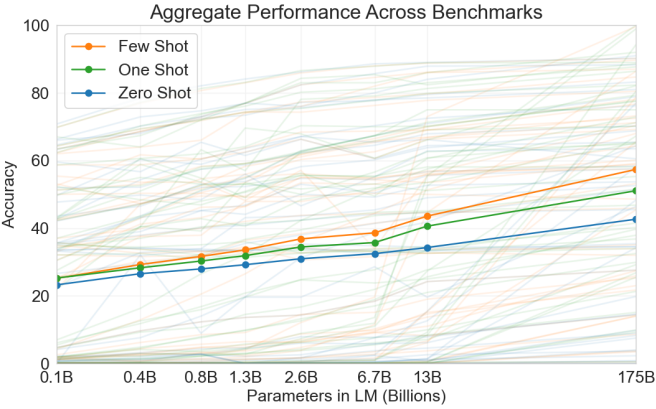
Fig. 11.9.8 Совокупная производительность GPT-3 по всем 42 бенчмаркам, измеряемым по точности (подпись адаптирована, рисунок взят из Brown et al. (2020)).
Эти три режима были протестированы в GPT-3 (Brown et al., 2020), самая крупная версия которой использует данные и имеет размер модели примерно на два порядка больше, чем у GPT-2. GPT-3 использует ту же архитектуру декодировщика трансформера, что и его непосредственный предшественник GPT-2, за исключением того, что паттерны внимания (справа на Fig. 11.9.6) становятся более разреженными на чередующихся слоях. Предобученный на 300 миллиардах токенов, GPT-3 показывает лучшие результаты при увеличении размера модели, при этом производительность в режиме few-shot (с малым числом примеров) возрастает наиболее быстро (Fig. 11.9.8).
В модели GPT-4, появившейся после предыдущих версий, технические детали в отчёте (OpenAI, 2023) были раскрыты не полностью. В отличие от своих предшественников, GPT-4 представляет собой крупномасштабную мультимодальную модель, способную принимать на вход как текст, так и изображения, а также генерировать текстовый вывод.
11.9.4. Масштабируемость
Fig. 11.9.8 эмпирически демонстрирует масштабируемость трансформеров в языковой модели GPT-3. Для языкового моделирования более масштабные эмпирические исследования масштабируемости трансформеров убедили исследователей в перспективности обучения более крупных трансформеров на больших объёмах данных и с использованием вычислительных ресурсов (Kaplan et al., 2020).
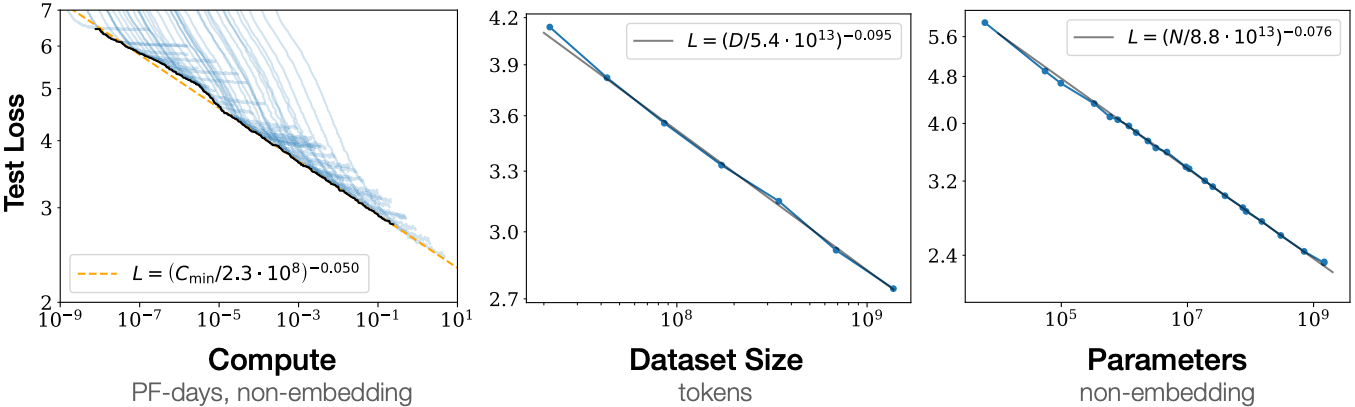
Fig. 11.9.9 Производительность языковой модели на основе трансформера плавно улучшается при увеличении размера модели, объёма набора данных и вычислительных ресурсов, используемых для обучения. Для достижения оптимальной производительности все три фактора должны масштабироваться одновременно. Эмпирическая производительность подчиняется степенному закону по отношению к каждому из факторов в отдельности, если она не ограничена другими двумя (подпись адаптирована, рисунок взят из Kaplan et al. (2020)).
Как показано на рисунке Fig. 11.9.9, степенное масштабирование наблюдается для зависимости производительности от размера модели (количества параметров, исключая слои эмбеддинга), размера набора данных (количества обучающих токенов) и объёма вычислительных ресурсов, затраченных на обучение (петафлопс-дни, исключая слои эмбеддинга). В целом, одновременное увеличение всех трёх факторов приводит к улучшению производительности. Однако вопрос о том, как именно следует увеличивать их совместно, остается предметом дискуссий (Hoffmann et al., 2022).
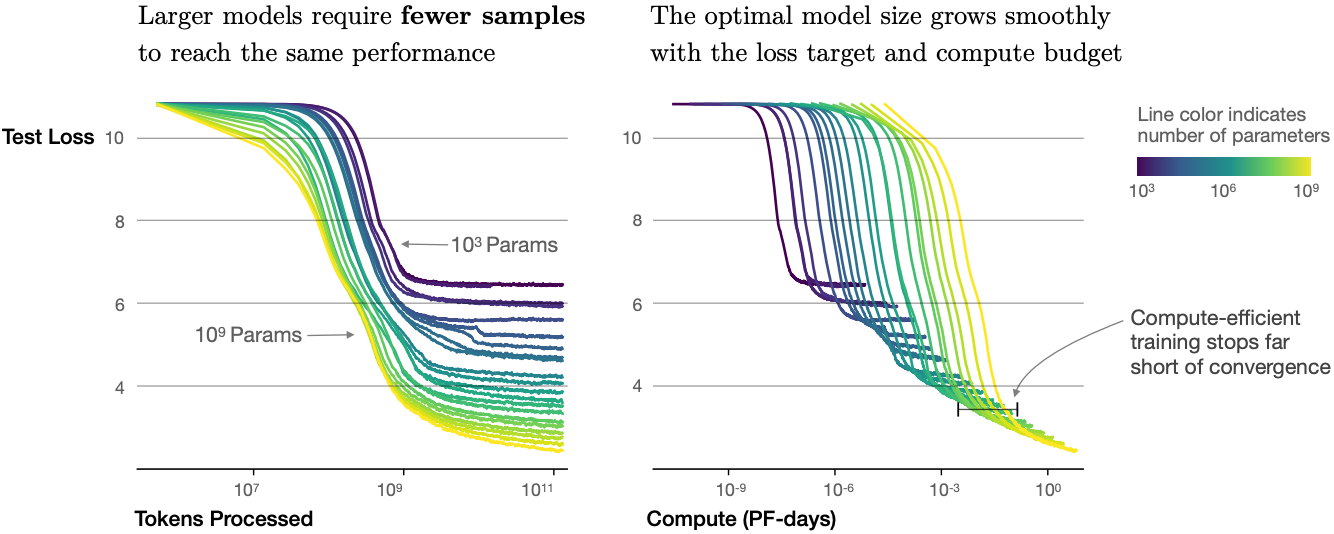
Fig. 11.9.10 Обучение языковых моделей на основе трансформеров (рисунок взят из Kaplan et al. (2020)).
Помимо повышения производительности, большие модели также демонстрируют лучшую эффективность использования примеров по сравнению с малыми моделями. Fig. 11.9.10 показывает, что большим моделям требуется меньше обучающих примеров (обработанных токенов) для достижения того же уровня, который достигается малыми моделями, а производительность плавно масштабируется с вычислительными ресурсами.
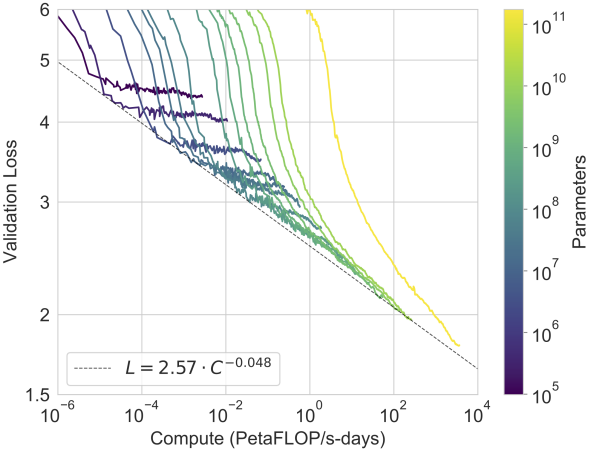
Fig. 11.9.11 Производительность GPT-3 (потеря перекрёстной энтропии на валидационной выборке) подчиняется степенному закону в зависимости от объёма вычислений, затраченных на обучение. Степенная зависимость, наблюдаемая в Kaplan et al. (2020), сохраняется ещё на два порядка величины с лишь незначительными отклонениями от предсказанной кривой. Параметры эмбеддинга исключены из подсчёта вычислений и количества параметров (подпись адаптирована, рисунок взят из Brown et al. (2020)).
Эмпирические закономерности масштабирования, описанные в Kaplan et al. (2020), были проверены в последующих крупных моделях трансформеров. Например, GPT-3 подтвердил эту гипотезу, увеличив масштаб ещё на два порядка в Fig. 11.9.11.
11.9.5. Большие языковые модели
Масштабируемость трансформеров в серии GPT вдохновила создание последующих больших языковых моделей. Декодировщик трансформера GPT-2 использовался для обучения Megatron-Turing NLG (Smith et al., 2022) с 530 миллиардами параметров на корпусе из 270 миллиардов обучающих токенов. Следуя архитектуре GPT-2, модель Gopher (Rae et al., 2021) объёмом 280 миллиардов параметров, предварительно обученная на 300 миллиардах токенов, продемонстрировала конкурентоспособные результаты в широком спектре задач. Наследуя ту же архитектуру и используя тот же вычислительный бюджет, что и Gopher, Chinchilla (Hoffmann et al., 2022) представляет собой существенно меньшую модель (70 миллиардов параметров), которая обучается значительно дольше (1,4 триллиона обучающих токенов), превосходя Gopher во многих задачах, при этом больший акцент делается на количестве токенов, а не на количестве параметров. Чтобы продолжить линию масштабирования языкового моделирования, PaLM (Pathway Language Model) (Chowdhery et al., 2022) — декодировщик трансформера на 540 миллиардов параметров с модифицированным дизайном, предварительно обученный на 780 миллиардах токенов, превзошел средний уровень человеческих результатов на бенчмарке BIG-Bench (Srivastava et al., 2022). Её более поздняя версия, PaLM 2 (Anil et al., 2023), масштабирует данные и модель примерно в соотношении 1:1, улучшая многоязычные и рассуждающие способности. Другие большие языковые модели, такие как Minerva (Lewkowycz et al., 2022), которая дополнительно обучает универсальную модель (PaLM), и Galactica (Taylor et al., 2022), которая не обучалась на общем корпусе, продемонстрировали перспективные количественные и научные способности к рассуждению.
Открытые релизы, такие как OPT (Open Pretrained Transformers) (Zhang et al., 2022), BLOOM (Scao et al., 2022) и FALCON (Penedo et al., 2023), демократизировали исследования и использование больших языковых моделей. Сосредоточившись на вычислительной эффективности на этапе вывода, открытая модель Llama 1 (Touvron et al., 2023a) превзошла гораздо более крупные модели благодаря обучению на большем количестве токенов, чем это обычно делалось. Обновленная версия Llama 2 (Touvron et al., 2023b) дополнительно увеличила корпус для предобучения на 40%, что привело к созданию продуктовых моделей, способных сопоставляться по производительности с конкурентоспособными закрытыми моделями.
В работе Wei et al. (2022) обсуждаются эмерджентные способности больших языковых моделей, которые проявляются в более крупных моделях, но отсутствуют в более мелких. Однако простое увеличение размера модели не гарантирует, что она будет лучше следовать инструкциям человека. В работе Sanh et al. (2021), Wei et al. (2021) показано, что дообучение больших языковых моделей на наборах данных, описанных с помощью инструкций, может улучшить zero-shot производительность на отложенных задачах. Используя обучение с подкреплением на основе обратной связи от человека, авторы работы Ouyang et al. (2022) выполнили дообучение GPT-3 для следования разнообразному набору инструкций. После появления InstructGPT, который согласует языковые модели с намерениями человека посредством дообучения (Ouyang et al., 2022), ChatGPT может генерировать ответы, похожие на человеческие (например, отладка кода и творческое письмо), на основе диалогов с людьми, и выполнять многие задачи обработки естественного языка в режиме zero-shot (Qin et al., 2023). В работе Bai et al. (2022) вместо входных данных человека (например, размеченных человеком данных) были использованы выходные данные модели, что позволило частично автоматизировать процесс настройки по инструкциям, который также известен как обучение с подкреплением на основе обратной связи от искусственного интеллекта.
Большие языковые модели открывают захватывающие перспективы: формулируя текстовый ввод, можно побудить модель выполнить нужную задачу с помощью обучения в контексте (in-context learning), которое также называют промптингом. В частности, цепочка рассуждений (chain-of-thought prompting) (Wei et al., 2022) — метод обучения в контексте, использующий несколько примеров формата «вопрос, промежуточные шаги рассуждения, ответ» — позволяет проявить сложные способности к рассуждению больших языковых моделей для решения математических, житейских и символических задач. Выбор нескольких путей рассуждения (Wang et al., 2023), разнообразие примеров в few-shot настройке (Zhang et al., 2023) и декомпозиция сложных задач на подзадачи (Zhou et al., 2023) способны повысить точность рассуждений. Более того, даже с использованием простых промптов, таких как «Давайте рассуждать пошагово», перед каждым ответом большие языковые модели способны выполнять zero-shot цепочку рассуждений с приёмлемой точностью (Kojima et al., 2022). Даже для мультимодальных входных данных, состоящих из текста и изображений, языковые модели могут выполнять мультимодальную цепочку рассуждений с более высокой точностью, чем при использовании только текстового ввода (Zhang et al., 2023).
11.9.6. Итоги и обсуждение
Трансформеры предобучались в конфигурациях только с кодировщиком (например, BERT), кодировщик–декодировщик (например, T5) и только с декодировщиком (например, серия GPT). Предобученные модели можно адаптировать для выполнения различных задач с помощью обновления параметров модели (например, дообучение) или без него (например, few-shot). Масштабируемость трансформеров указывает на то, что улучшение результатов достигается за счет использования более крупных моделей, большего объёма обучающих данных и вычислительных ресурсов. Поскольку трансформеры изначально разрабатывались и предобучались для текстовых данных, данный раздел немного смещен в сторону обработки естественного языка. Тем не менее модели, рассмотренные выше, часто встречаются в более современных архитектурах, работающих с несколькими модальностями. Например, (i) Chinchilla (Hoffmann et al., 2022) была расширена до Flamingo (Alayrac et al., 2022), визуальной языковой модели для обучения с малым количеством примеров; (ii) GPT-2 (Radford et al., 2019) и визуальный трансформер используются в CLIP (Contrastive Language-Image Pre-training) (Radford et al., 2021) для кодирования текста и изображений, а их эмбеддинги изображений и текста впоследствии были применены в системе генерации изображений по тексту DALL-E 2 (Ramesh et al., 2022). Хотя систематических исследований масштабируемости трансформеров в задачах мультимодального предобучения пока не проводилось, модель Parti (Yu et al., 2022), представляющая собой полностью трансформерную архитектуру для генерации изображений по тексту, демонстрирует потенциал масштабируемости между модальностями: более крупная модель Parti лучше справляется с генерацией изображений высокой точности и пониманием текстов с богатым содержанием (Fig. 11.9.12).
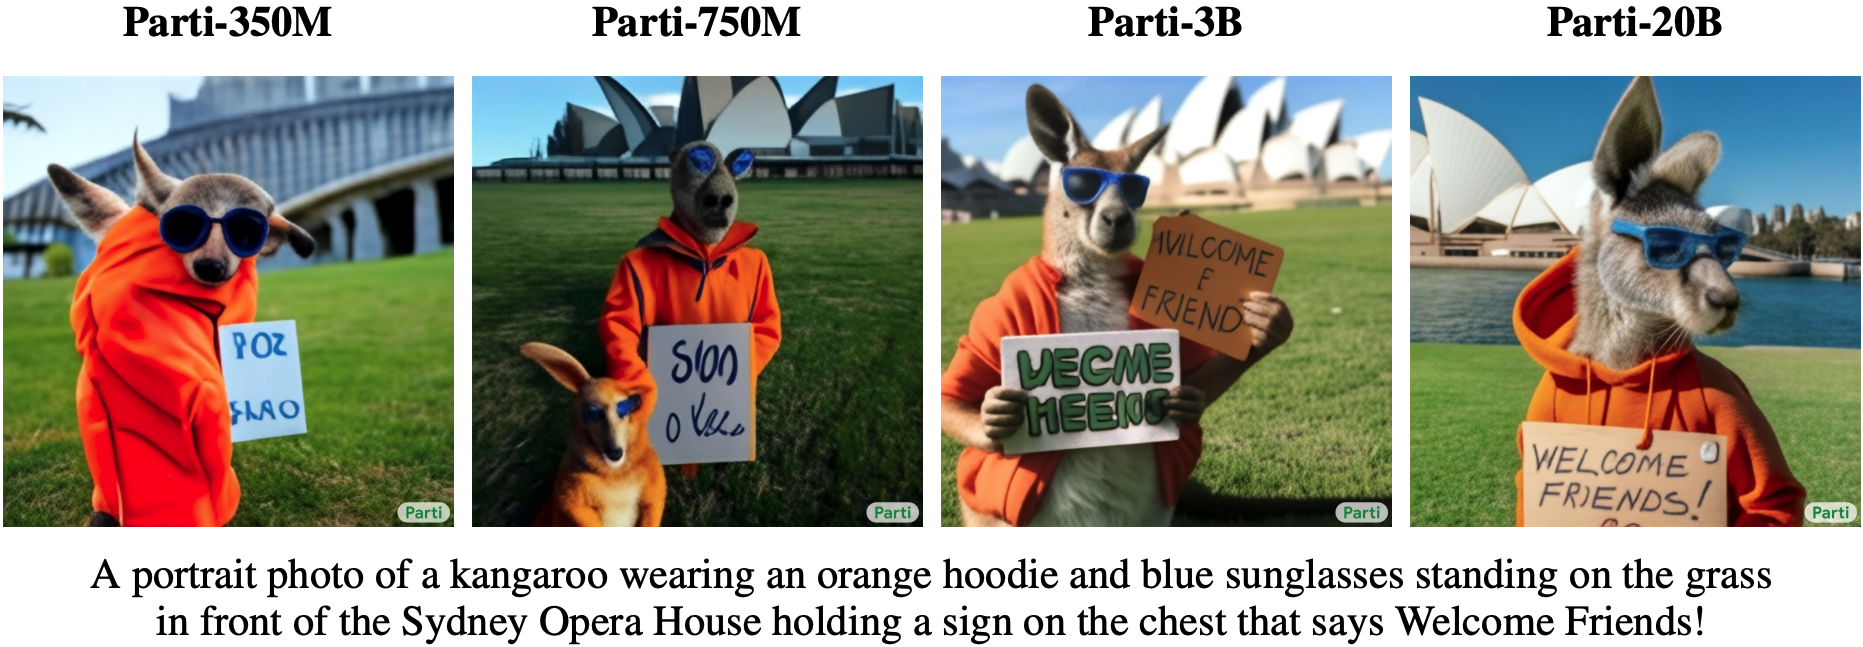
Fig. 11.9.12 Примеры изображений, сгенерированных моделью Parti из одного и того же текста при увеличении размера модели (350M, 750M, 3B, 20B) (примеры взяты из Yu et al. (2022)).
11.9.7. Упражнения
Можно ли дообучать T5, используя мини-батч, состоящий из разных задач? Почему да или почему нет? А как насчет GPT-2?
Учитывая наличие мощной языковой модели, какие приложения вы можете придумать?
Предположим, что вас просят дообучить языковую модель для выполнения классификации текстов путем добавления дополнительных слоёв. Куда вы их добавите? Почему?
Рассмотрим задачи преобразования последовательности в последовательность (например, машинный перевод), в которых входная последовательность доступна на протяжении всего процесса предсказания целевой переменной. Каковы могут быть ограничения моделирования с использованием декодировщиков на базе только трансформеров? Почему?