
14.14. Идентификация породы собак (ImageNet Dogs) на Kaggle
В этом разделе мы решим задачу идентификации породы собак на Kaggle. Ссылка на соревнование: https://www.kaggle.com/c/dog-breed-identification**
В этом соревновании предстоит распознать 120 различных пород собак. На самом деле, набор данных для этого соревнования является подмножеством набора данных ImageNet. В отличие от изображений в наборе данных CIFAR-10 из Section 14.13, изображения в наборе данных ImageNet имеют различную высоту и ширину. Fig. 14.14.1 содержит информацию со страницы соревнования. Для отправки результатов вам потребуется аккаунт на Kaggle.
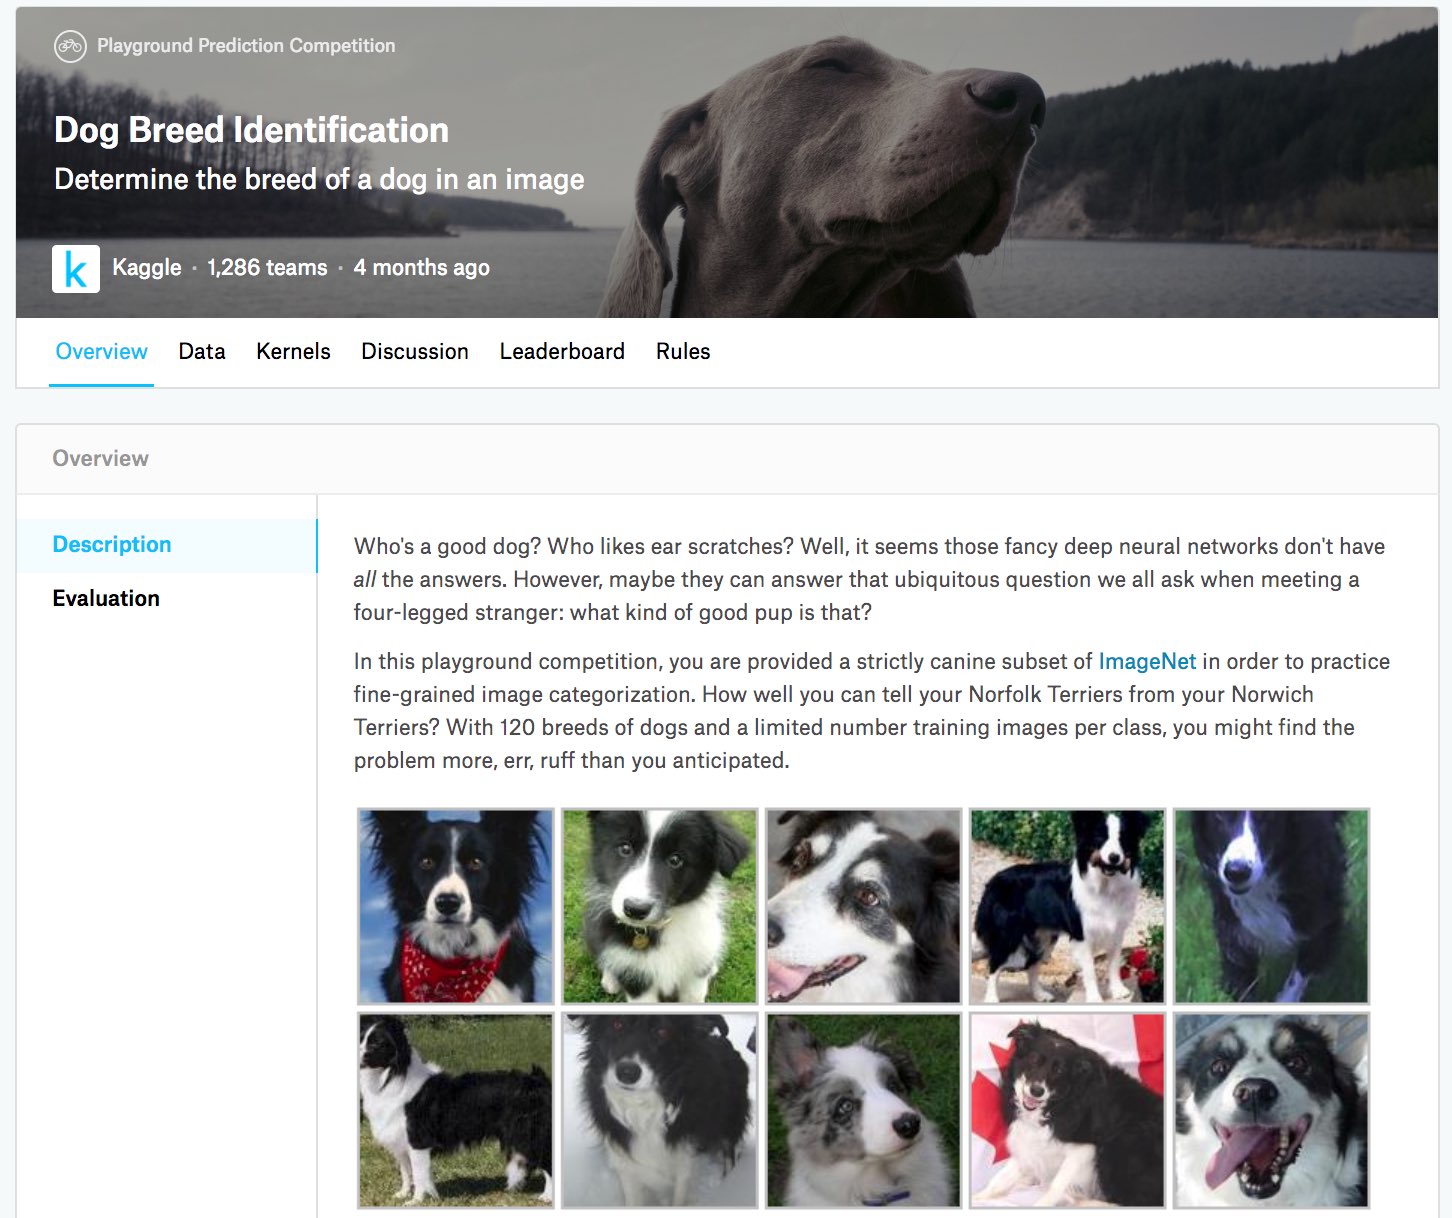
Fig. 14.14.1 Веб-сайт соревнования по идентификации пород собак. Набор данных для соревнования можно получить, перейдя на вкладку «Data».
import os
import torch
import torchvision
from torch import nn
from d2l import torch as d2l
14.14.1. Получение и организация набора данных
Набор данных соревнования разделен на обучающую выборку и тестовую выборку, содержащие 10222 и 10357 изображений в формате JPEG с тремя каналами RGB (цветными) соответственно. В обучающей выборке представлены 120 пород собак, таких как лабрадоры, пудели, таксы, самоеды, хаски, чихуахуа и йоркширские терьеры.
14.14.1.1. Скачивание набора данных
После входа в Kaggle вы можете перейти на вкладку «Data» на странице
соревнования, показанной в Fig. 14.14.1, и скачать набор
данных, нажав кнопку «Download All». После распаковки загруженного файла
в ../data вы обнаружите весь набор данных в следующих директориях:
../data/dog-breed-identification/labels.csv
../data/dog-breed-identification/sample_submission.csv
../data/dog-breed-identification/train
../data/dog-breed-identification/test
Вы могли заметить, что описанная выше структура похожа на структуру
соревнования CIFAR-10 из Section 14.13, где папки
train/ и test/ содержат обучающие и тестовые изображения собак
соответственно, а labels.csv содержит метки для обучающих
изображений. Аналогично, чтобы облегчить начало работы, мы предоставляем
небольшую выборку из вышеупомянутого набора данных:
train_valid_test_tiny.zip. Если вы планируете использовать полный
набор данных для соревнования на Kaggle, вам нужно изменить переменную
demo ниже на False.
#@save
d2l.DATA_HUB['dog_tiny'] = (d2l.DATA_URL + 'kaggle_dog_tiny.zip',
                            '0cb91d09b814ecdc07b50f31f8dcad3e81d6a86d')

# If you use the full dataset downloaded for the Kaggle competition, change
# the variable below to `False`
demo = True
if demo:
    data_dir = d2l.download_extract('dog_tiny')
else:
    data_dir = os.path.join('..', 'data', 'dog-breed-identification')
14.14.1.2. Организация набора данных
Мы можем организовать набор данных аналогично тому, как мы поступали в Section 14.13, а именно выделив из исходной обучающей выборки валидационную выборку и переместив изображения в подпапки, сгруппированные по меткам.
Функция reorg_dog_data ниже считывает метки обучающей выборки,
выделяет из неё валидационную выборку и организует оставшуюся обучающую
выборку.
def reorg_dog_data(data_dir, valid_ratio):
    labels = d2l.read_csv_labels(os.path.join(data_dir, 'labels.csv'))
    d2l.reorg_train_valid(data_dir, labels, valid_ratio)
    d2l.reorg_test(data_dir)


batch_size = 32 if demo else 128
valid_ratio = 0.1
reorg_dog_data(data_dir, valid_ratio)
14.14.2. Аугментация изображений
Напомним, что этот набор данных с породами собак является подмножеством набора данных ImageNet, изображения в котором больше, чем в наборе данных CIFAR-10 из Section 14.13. Ниже приведены несколько операций аугментации изображений, которые могут быть полезны для относительно больших изображений.
transform_train = torchvision.transforms.Compose([
    # Randomly crop the image to obtain an image with an area of 0.08 to 1 of
    # the original area and height-to-width ratio between 3/4 and 4/3. Then,
    # scale the image to create a new 224 x 224 image
    torchvision.transforms.RandomResizedCrop(224, scale=(0.08, 1.0),
                                             ratio=(3.0/4.0, 4.0/3.0)),
    torchvision.transforms.RandomHorizontalFlip(),
    # Randomly change the brightness, contrast, and saturation
    torchvision.transforms.ColorJitter(brightness=0.4,
                                       contrast=0.4,
                                       saturation=0.4),
    # Add random noise
    torchvision.transforms.ToTensor(),
    # Standardize each channel of the image
    torchvision.transforms.Normalize([0.485, 0.456, 0.406],
                                     [0.229, 0.224, 0.225])])
Во время предсказания мы используем только операции предобработки изображений без элементов случайности.
transform_test = torchvision.transforms.Compose([
    torchvision.transforms.Resize(256),
    # Crop a 224 x 224 square area from the center of the image
    torchvision.transforms.CenterCrop(224),
    torchvision.transforms.ToTensor(),
    torchvision.transforms.Normalize([0.485, 0.456, 0.406],
                                     [0.229, 0.224, 0.225])])
14.14.3. Чтение набора данных
Как и в Section 14.13, мы можем прочитать организованный набор данных, состоящий из необработанных файлов изображений.
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_train) for folder in ['train', 'train_valid']]

valid_ds, test_ds = [torchvision.datasets.ImageFolder(
    os.path.join(data_dir, 'train_valid_test', folder),
    transform=transform_test) for folder in ['valid', 'test']]
Ниже мы создаём экземпляры итераторов данных тем же способом, что и в Section 14.13.
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
    dataset, batch_size, shuffle=True, drop_last=True)
    for dataset in (train_ds, train_valid_ds)]

valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
                                         drop_last=True)

test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
                                        drop_last=False)
14.14.4. Дообучение предварительно обученной модели
Напомним, что набор данных для этого соревнования является подмножеством набора данных ImageNet. Следовательно, мы можем использовать подход, описанный в Section 14.2, чтобы выбрать модель, предварительно обученную на полном наборе данных ImageNet, и использовать её для извлечения признаков изображений, которые затем подаются в небольшую пользовательскую выходную сеть. Высокоуровневые API фреймворков глубокого обучения предоставляют широкий выбор моделей, предварительно обученных на наборе данных ImageNet. Здесь мы выбираем предварительно обученную модель ResNet-34, повторно используя вход её выходного слоя (то есть извлеченные признаки). Затем мы заменяем оригинальный выходной слой небольшой пользовательской выходной сетью, которую можно обучить, например, путем объединения двух полносвязных слоёв. В отличие от эксперимента в Section 14.2, в дальнейшем мы не будем переобучать предварительно обученную модель, используемую для извлечения признаков. Это сокращает время обучения и объём памяти, необходимый для хранения градиентов.
Напомним, что мы нормализовали изображения, используя средние значения и стандартные отклонения трёх каналов RGB для всего набора данных ImageNet. По сути, это также соответствует операции нормализации, выполняемой предварительно обученной моделью на ImageNet.
def get_net(devices):
    finetune_net = nn.Sequential()
    finetune_net.features = torchvision.models.resnet34(pretrained=True)
    # Define a new output network (there are 120 output categories)
    finetune_net.output_new = nn.Sequential(nn.Linear(1000, 256),
                                            nn.ReLU(),
                                            nn.Linear(256, 120))
    # Move the model to devices
    finetune_net = finetune_net.to(devices[0])
    # Freeze parameters of feature layers
    for param in finetune_net.features.parameters():
        param.requires_grad = False
    return finetune_net
Перед вычислением функции потерь мы сначала получаем выход предобученной модели, то есть извлечённый признак. Затем мы используем этот признак в качестве входа для нашей небольшой пользовательской выходной сети, чтобы вычислить функцию потерь.
loss = nn.CrossEntropyLoss(reduction='none')

def evaluate_loss(data_iter, net, devices):
    l_sum, n = 0.0, 0
    for features, labels in data_iter:
        features, labels = features.to(devices[0]), labels.to(devices[0])
        outputs = net(features)
        l = loss(outputs, labels)
        l_sum += l.sum()
        n += labels.numel()
    return l_sum / n
14.14.5. Определение функции обучения
Мы выберем модель и настроим гиперпараметры, ориентируясь на
производительность модели на валидационной выборке. Функция обучения
train итерирует только параметры небольшой пользовательской выходной
сети.
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
          lr_decay):
    # Only train the small custom output network
    net = nn.DataParallel(net, device_ids=devices).to(devices[0])
    trainer = torch.optim.SGD((param for param in net.parameters()
                               if param.requires_grad), lr=lr,
                              momentum=0.9, weight_decay=wd)
    scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
    num_batches, timer = len(train_iter), d2l.Timer()
    legend = ['train loss']
    if valid_iter is not None:
        legend.append('valid loss')
    animator = d2l.Animator(xlabel='epoch', xlim=[1, num_epochs],
                            legend=legend)
    for epoch in range(num_epochs):
        metric = d2l.Accumulator(2)
        for i, (features, labels) in enumerate(train_iter):
            timer.start()
            features, labels = features.to(devices[0]), labels.to(devices[0])
            trainer.zero_grad()
            output = net(features)
            l = loss(output, labels).sum()
            l.backward()
            trainer.step()
            metric.add(l, labels.shape[0])
            timer.stop()
            if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
                animator.add(epoch + (i + 1) / num_batches,
                             (metric[0] / metric[1], None))
        measures = f'train loss {metric[0] / metric[1]:.3f}'
        if valid_iter is not None:
            valid_loss = evaluate_loss(valid_iter, net, devices)
            animator.add(epoch + 1, (None, valid_loss.detach().cpu()))
        scheduler.step()
    if valid_iter is not None:
        measures += f', valid loss {valid_loss:.3f}'
    print(measures + f'\n{metric[1] * num_epochs / timer.sum():.1f}'
          f' examples/sec on {str(devices)}')
14.14.6. Обучение и проверка модели
Теперь мы можем обучить и проверить модель. Все указанные гиперпараметры
являются настраиваемыми. Например, можно увеличить количество эпох.
Поскольку lr_period и lr_decay установлены равными 2 и 0,9
соответственно, скорость обучения алгоритма оптимизации будет умножаться
на 0,9 после каждой 2-й эпохи.
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 10, 1e-4, 1e-4
lr_period, lr_decay, net = 2, 0.9, get_net(devices)
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
      lr_decay)
14.14.7. Классификация тестовой выборки и отправка результатов на Kaggle
Как и на финальном шаге в Section 14.13, в конце все размеченные данные (включая валидационную выборку) используются для обучения модели и классификации тестовой выборки. Для классификации мы будем использовать обученную пользовательскую выходную сеть.
net = get_net(devices)
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
      lr_decay)

preds = []
for data, label in test_iter:
    output = torch.nn.functional.softmax(net(data.to(devices[0])), dim=1)
    preds.extend(output.cpu().detach().numpy())
ids = sorted(os.listdir(
    os.path.join(data_dir, 'train_valid_test', 'test', 'unknown')))
with open('submission.csv', 'w') as f:
    f.write('id,' + ','.join(train_valid_ds.classes) + '\n')
    for i, output in zip(ids, preds):
        f.write(i.split('.')[0] + ',' + ','.join(
            [str(num) for num in output]) + '\n')
Приведённый выше код создаст файл submission.csv, который можно
отправить на Kaggle тем же способом, что описан в
Section 5.7.
14.14.8. Резюме
Изображения в наборе данных ImageNet имеют большие размеры (с различными размерностями), чем изображения CIFAR-10. Для задач на другом наборе данных мы можем изменить операции аугментации изображений.
Для классификации подмножества набора данных ImageNet можно использовать предварительно обученные модели на полном наборе данных ImageNet для извлечения признаков и обучать только небольшую пользовательскую выходную сеть. Это позволит сократить время вычислений и затраты памяти.
14.14.9. Упражнения
При использовании полного набора данных соревнования Kaggle, какие результаты можно получить, увеличив
batch_size(размер батча) иnum_epochs(количество эпох), а также задав некоторые другие гиперпараметры какlr = 0.01,lr_period = 10иlr_decay = 0.1?Получаете ли вы лучшие результаты, если используете более глубокую предварительно обученную модель? Как настраивать гиперпараметры? Можно ли дополнительно улучшить результаты?