
19.4. Многоуровневая оптимизация гиперпараметров
Обучение нейронных сетей может быть дорогостоящим даже на наборах данных среднего размера. В зависимости от пространства конфигураций (Section 19.1.1.2) оптимизация гиперпараметров требует от десятков до сотен вычислений функции, чтобы найти конфигурацию гиперпараметров, обеспечивающую высокую производительность. Как мы видели в Section 19.3, мы можем значительно ускорить общее время выполнения HPO, используя параллельные ресурсы, но это не уменьшает общий объём необходимых вычислений.
В этом разделе мы покажем, как ускорить оценку конфигураций гиперпараметров. Методы, такие как случайный поиск, выделяют одинаковый объём ресурсов (например, количество эпох, точек обучающих данных) для каждой оценки гиперпараметров. Fig. 19.4.1 иллюстрирует кривые обучения набора нейронных сетей, обученных с различными конфигурациями гиперпараметров. Уже после нескольких эпох мы можем визуально отличить хорошо работающие конфигурации от субоптимальных. Однако кривые обучения зашумлены, и нам, возможно, все же потребуется полный объём в 100 эпох, чтобы определить лучшую конфигурацию.
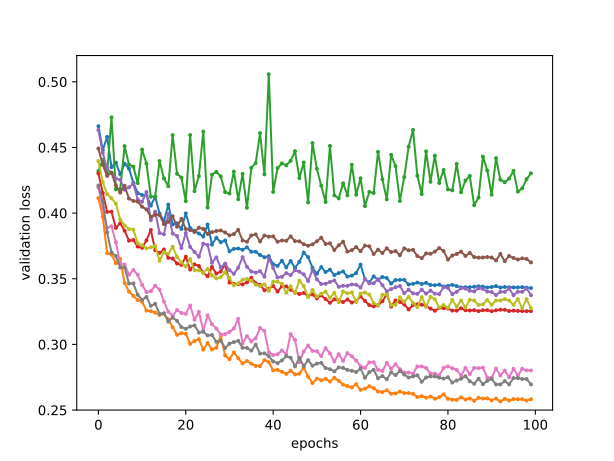
Fig. 19.4.1 Кривые обучения случайных конфигураций гиперпараметров
Многоуровневая оптимизация гиперпараметров выделяет больше ресурсов перспективным конфигурациям и рано прекращает оценку тех, которые показывают плохие результаты. Это ускоряет процесс оптимизации, поскольку мы можем протестировать большее количество конфигураций при том же общем объёме ресурсов.
Более формально мы расширяем определение из Section 19.1.1, добавляя к нашей целевой функции \(f(\mathbf{x}, r)\) дополнительный входной параметр \(r \in [r_{\mathrm{min}}, r_{max}]\), который указывает объём ресурсов, готовых потратить на оценку конфигурации \(\mathbf{x}\). Мы предполагаем, что ошибка \(f(\mathbf{x}, r)\) уменьшается с ростом \(r\), тогда как вычислительные затраты \(c(\mathbf{x}, r)\) возрастают. Обычно \(r\) обозначает количество эпох обучения нейронной сети, но это также может быть размер обучающей выборки или количество фолдов перекрёстной проверки.
from collections import defaultdict
import numpy as np
from scipy import stats
from d2l import torch as d2l

d2l.set_figsize()
19.4.1. Последовательное урезание
Один из простейших способов адаптировать случайный поиск к многоверсионному подходу — это последовательное усечение (Jamieson and Talwalkar, 2016, Karnin et al., 2013). Основная идея заключается в том, чтобы начать с \(N\) конфигураций, например, случайно выбранных из пространства конфигураций, и обучить каждую из них только в течение \(r_{\mathrm{min}}\) эпох. Затем мы отбрасываем часть наихудших по результатам испытаний и обучаем оставшиеся дольше. Повторяя этот процесс, мы уменьшаем количество испытаний, которые выполняются дольше, пока хотя бы одно испытание не достигнет \(r_{max}\) эпох.
Более формально рассмотрим минимальный бюджет \(r_{\mathrm{min}}\)
(например, 1 эпоха), максимальный бюджет \(r_{max}\), например
max_epochs в нашем предыдущем примере, и константу деления пополам
\(\eta\in\{2, 3, \dots\}\). Для простоты предположим, что
\(r_{max} = r_{\mathrm{min}} \eta^K\), где \(K \in \mathbb{I}\).
Тогда количество начальных конфигураций равно \(N = \eta^K\).
Определим множество ступеней
\(\mathcal{R} = \{ r_{\mathrm{min}}, r_{\mathrm{min}}\eta, r_{\mathrm{min}}\eta^2, \dots, r_{max} \}\).
Один раунд последовательного отсечения выполняется следующим образом. Мы начинаем с запуска \(N\) испытаний до достижения первой ступени \(r_{\mathrm{min}}\). Сортируя ошибки валидации, мы оставляем верхние \(1 / \eta\) доли (что составляет \(\eta^{K-1}\) конфигураций) и отбрасываем все остальные. Оставшиеся испытания обучаются до следующей ступени (\(r_{\mathrm{min}}\eta\) эпох), и процесс повторяется. На каждой ступени \(1 / \eta\) доля испытаний сохраняется, и их обучение продолжается с бюджетом, в \(\eta\) раз большим. При таком выборе \(N\) только одно испытание будет обучено до полного бюджета \(r_{max}\). После завершения такого раунда последовательного отсечения мы начинаем следующий с новым набором начальных конфигураций, повторяя итерации до исчерпания общего бюджета.
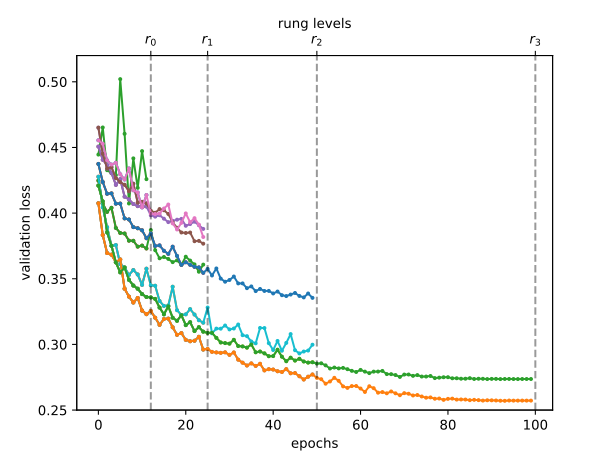
Fig. 19.4.2 Кривые обучения случайных конфигураций гиперпараметров.
Мы наследуемся от базового класса HPOScheduler из
Section 19.2, чтобы реализовать последовательное отсечение
(successive halving), что позволяет использовать универсальный объект
HPOSearcher для выборки конфигураций (в нашем примере ниже это будет
RandomSearcher). Кроме того, пользователь должен передать в качестве
входных параметров минимальный ресурс \(r_{\mathrm{min}}\),
максимальный ресурс \(r_{max}\) и \(\eta\). Внутри нашего
планировщика мы поддерживаем очередь конфигураций, которые ещё
необходимо оценить для текущего этапа \(r_i\). Мы обновляем очередь
каждый раз, когда переходим к следующему этапу.
class SuccessiveHalvingScheduler(d2l.HPOScheduler):  #@save
    def __init__(self, searcher, eta, r_min, r_max, prefact=1):
        self.save_hyperparameters()
        # Compute K, which is later used to determine the number of configurations
        self.K = int(np.log(r_max / r_min) / np.log(eta))
        # Define the rungs
        self.rung_levels = [r_min * eta ** k for k in range(self.K + 1)]
        if r_max not in self.rung_levels:
            # The final rung should be r_max
            self.rung_levels.append(r_max)
            self.K += 1
        # Bookkeeping
        self.observed_error_at_rungs = defaultdict(list)
        self.all_observed_error_at_rungs = defaultdict(list)
        # Our processing queue
        self.queue = []
В начале наша очередь пуста, и мы заполняем её
\(n = \textrm{prefact} \cdot \eta^{K}\) конфигурациями, которые
сначала оцениваются на наименьшем уровне \(r_{\mathrm{min}}\). Здесь
\(\textrm{prefact}\) позволяет нам переиспользовать код в другом
контексте. В рамках данного раздела мы фиксируем
\(\textrm{prefact} = 1\). Каждый раз, когда освобождаются ресурсы и
объект HPOTuner запрашивает функцию suggest, мы возвращаем
элемент из очереди. Как только завершается один раунд последовательного
отсечения, то есть все оставшиеся конфигурации оцениваются на
максимальном уровне ресурсов \(r_{max}\) и очередь становится
пустой, мы начинаем весь процесс заново с новым случайно сгенерированным
набором конфигураций.
@d2l.add_to_class(SuccessiveHalvingScheduler)  #@save
def suggest(self):
    if len(self.queue) == 0:
        # Start a new round of successive halving
        # Number of configurations for the first rung:
        n0 = int(self.prefact * self.eta ** self.K)
        for _ in range(n0):
            config = self.searcher.sample_configuration()
            config["max_epochs"] = self.r_min  # Set r = r_min
            self.queue.append(config)
    # Return an element from the queue
    return self.queue.pop()
Когда мы собираем новую точку данных, мы сначала обновляем модуль поиска. Затем мы проверяем, собрали ли мы уже все точки данных на текущем уровне. Если да, то мы сортируем все конфигурации и помещаем в очередь лучшие \(\frac{1}{\eta}\) конфигураций.
@d2l.add_to_class(SuccessiveHalvingScheduler)  #@save
def update(self, config: dict, error: float, info=None):
    ri = int(config["max_epochs"])  # Rung r_i
    # Update our searcher, e.g if we use Bayesian optimization later
    self.searcher.update(config, error, additional_info=info)
    self.all_observed_error_at_rungs[ri].append((config, error))
    if ri < self.r_max:
        # Bookkeeping
        self.observed_error_at_rungs[ri].append((config, error))
        # Determine how many configurations should be evaluated on this rung
        ki = self.K - self.rung_levels.index(ri)
        ni = int(self.prefact * self.eta ** ki)
        # If we observed all configuration on this rung r_i, we estimate the
        # top 1 / eta configuration, add them to queue and promote them for
        # the next rung r_{i+1}
        if len(self.observed_error_at_rungs[ri]) >= ni:
            kiplus1 = ki - 1
            niplus1 = int(self.prefact * self.eta ** kiplus1)
            best_performing_configurations = self.get_top_n_configurations(
                rung_level=ri, n=niplus1
            )
            riplus1 = self.rung_levels[self.K - kiplus1]  # r_{i+1}
            # Queue may not be empty: insert new entries at the beginning
            self.queue = [
                dict(config, max_epochs=riplus1)
                for config in best_performing_configurations
            ] + self.queue
            self.observed_error_at_rungs[ri] = []  # Reset
Конфигурации сортируются на основе их наблюдаемой производительности на текущем этапе.
@d2l.add_to_class(SuccessiveHalvingScheduler)  #@save
def get_top_n_configurations(self, rung_level, n):
    rung = self.observed_error_at_rungs[rung_level]
    if not rung:
        return []
    sorted_rung = sorted(rung, key=lambda x: x[1])
    return [x[0] for x in sorted_rung[:n]]
Рассмотрим, как работает последовательное усечение на примере нашей нейронной сети. Мы будем использовать \(r_{\mathrm{min}} = 2\), \(\eta = 2\), \(r_{max} = 10\), так что количество уровней будет \(2, 4, 8, 10\).
min_number_of_epochs = 2
max_number_of_epochs = 10
eta = 2
num_gpus=1

config_space = {
    "learning_rate": stats.loguniform(1e-2, 1),
    "batch_size": stats.randint(32, 256),
}
initial_config = {
    "learning_rate": 0.1,
    "batch_size": 128,
}
Мы просто заменяем планировщик на наш новый
SuccessiveHalvingScheduler.
searcher = d2l.RandomSearcher(config_space, initial_config=initial_config)
scheduler = SuccessiveHalvingScheduler(
    searcher=searcher,
    eta=eta,
    r_min=min_number_of_epochs,
    r_max=max_number_of_epochs,
)
tuner = d2l.HPOTuner(
    scheduler=scheduler,
    objective=d2l.hpo_objective_lenet,
)
tuner.run(number_of_trials=30)
Мы можем визуализировать кривые обучения всех протестированных конфигураций. Большинство конфигураций останавливаются досрочно, и только наиболее эффективные из них доживают до \(r_{max}\). Сравните это с обычным случайным поиском, который выделяет \(r_{max}\) каждой конфигурации.
for rung_index, rung in scheduler.all_observed_error_at_rungs.items():
    errors = [xi[1] for xi in rung]
    d2l.plt.scatter([rung_index] * len(errors), errors)
d2l.plt.xlim(min_number_of_epochs - 0.5, max_number_of_epochs + 0.5)
d2l.plt.xticks(
    np.arange(min_number_of_epochs, max_number_of_epochs + 1),
    np.arange(min_number_of_epochs, max_number_of_epochs + 1)
)
d2l.plt.ylabel("validation error")
d2l.plt.xlabel("epochs")
Наконец, отметим некоторые особенности реализации
SuccessiveHalvingScheduler. Предположим, что один из рабочих
свободен и готов выполнить задачу, а функция suggest вызывается в
момент, когда текущий уровень почти полностью заполнен, но другой
рабочий всё ещё занят оценкой. Поскольку у нас нет значения метрики от
этого рабочего, мы не можем определить верхнюю долю \(1 / \eta\) для
открытия следующего уровня. С другой стороны, мы хотим назначить задачу
нашему свободному рабочему, чтобы он не простаивал. Наше решение —
запустить новый раунд последовательного отсечения и назначить этого
рабочего на первую попытку в нём. Однако, как только уровень завершён в
update, мы гарантированно вставляем новые конфигурации в начало
очереди, чтобы они имели приоритет над конфигурациями из следующего
раунда.
19.4.2. Итог
В этом разделе мы ввели понятие многоверной оптимизации гиперпараметров, где предполагается наличие доступных дешевых для вычисления аппроксимаций целевой функции, таких как ошибка валидации после определённого числа эпох обучения в качестве прокси для ошибки валидации после полного числа эпох. Многоверная оптимизация гиперпараметров позволяет сократить общие вычислительные затраты HPO, а не только уменьшить время выполнения.
Мы реализовали и оценили последовательное отсечение — простой, но эффективный алгоритм многоуровневой оптимизации гиперпараметров.