
8.4. Многоветвевые сети (GoogLeNet)
В 2014 году GoogLeNet выиграл соревнование ImageNet (Szegedy et al., 2015), используя архитектуру, которая объединила сильные стороны NiN (Lin et al., 2013), повторяющихся блоков (Simonyan and Zisserman, 2014) и набора свёрточных ядер. Можно сказать, что это была первая сеть, в которой чётко разграничены ствол (приём данных), тело (обработка данных) и голова (предсказание) в CNN. Этот шаблон проектирования сохраняется и по сей день при разработке глубоких сетей: ствол задаётся первыми двумя или тремя свёртками, которые обрабатывают изображение. Они извлекают низкоуровневые признаки из исходных изображений. За ними следует тело, состоящее из блоков свёрток. Наконец, голова отображает полученные признаки на требуемую задачу классификации, сегментации, обнаружения или отслеживания.
Ключевой вклад GoogLeNet заключался в проектировании структуры сети. Она решала проблему выбора ядер свёртки гениальным образом. В то время как другие работы пытались определить, какая именно свёртка — от \(1 \times 1\) до \(11 \times 11\) — окажется наилучшей, GoogLeNet просто конкатенировал многоветвевые свёртки. В дальнейшем мы рассмотрим немного упрощённую версию GoogLeNet: оригинальный дизайн включал ряд приёмов для стабилизации процесса обучения с помощью промежуточных функций потерь, применяемых к нескольким слоям сети. В настоящее время они не требуются благодаря появлению улучшенных алгоритмов обучения.
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
8.4.1. Блоки Inception
Базовый свёрточный блок в GoogLeNet называется Inception block, что отсылает к мему «Нам нужно идти глубже» из фильма Начало.
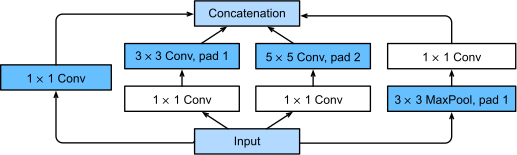
Fig. 8.4.1 Структура блока Inception.
Как показано на рисунке Fig. 8.4.1, блок Inception состоит из четырёх параллельных ветвей. Первые три ветви используют свёрточные слои с размерами окон \(1\times 1\), \(3\times 3\) и \(5\times 5\) для извлечения информации из областей разных пространственных размеров. Две средние ветви также применяют свёртку \(1\times 1\) к входным данным для уменьшения числа каналов, что снижает сложность модели. Четвёртая ветвь использует слой пулинга \(3\times 3\) с максимальным значением, за которым следует свёрточный слой \(1\times 1\) для изменения числа каналов. Все четыре ветви используют соответствующее дополнение, чтобы высота и ширина входа и выхода оставались одинаковыми. Наконец, выходы каждой ветви объединяются по измерению каналов и формируют выход блока. Наиболее часто настраиваемыми гиперпараметрами блока Inception являются число выходных каналов на каждом слое, то есть способ распределения ёмкости между свёртками разных размеров.
class Inception(nn.Module):
    # c1--c4 are the number of output channels for each branch
    def __init__(self, c1, c2, c3, c4, **kwargs):
        super(Inception, self).__init__(**kwargs)
        # Branch 1
        self.b1_1 = nn.LazyConv2d(c1, kernel_size=1)
        # Branch 2
        self.b2_1 = nn.LazyConv2d(c2[0], kernel_size=1)
        self.b2_2 = nn.LazyConv2d(c2[1], kernel_size=3, padding=1)
        # Branch 3
        self.b3_1 = nn.LazyConv2d(c3[0], kernel_size=1)
        self.b3_2 = nn.LazyConv2d(c3[1], kernel_size=5, padding=2)
        # Branch 4
        self.b4_1 = nn.MaxPool2d(kernel_size=3, stride=1, padding=1)
        self.b4_2 = nn.LazyConv2d(c4, kernel_size=1)

    def forward(self, x):
        b1 = F.relu(self.b1_1(x))
        b2 = F.relu(self.b2_2(F.relu(self.b2_1(x))))
        b3 = F.relu(self.b3_2(F.relu(self.b3_1(x))))
        b4 = F.relu(self.b4_2(self.b4_1(x)))
        return torch.cat((b1, b2, b3, b4), dim=1)
Чтобы получить интуитивное понимание того, почему эта сеть работает так хорошо, рассмотрим комбинацию фильтров. Они исследуют изображение с помощью фильтров разных размеров. Это означает, что детали на разных масштабах могут эффективно распознаваться фильтрами различных размеров. В то же время мы можем выделять разное количество параметров для разных фильтров.
8.4.2. Модель GoogLeNet
Как показано на рисунке Fig. 8.4.2, GoogLeNet использует стек из 9 блоков Inception, сгруппированных в три группы, между которыми выполняется max-пулинг, а в головной части — глобальный средний пулинг для формирования прогнозов. Max-пулинг между блоками Inception снижает размерность. На начальном этапе архитектуры первый модуль похож на AlexNet и LeNet.
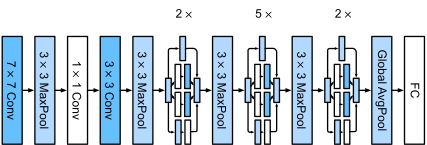
Fig. 8.4.2 Архитектура GoogLeNet.
Теперь мы можем реализовать GoogLeNet по частям. Начнем со стебля. Первый модуль использует свёрточный слой на 64 канала \(7\times 7\).
class GoogleNet(d2l.Classifier):
    def b1(self):
        return nn.Sequential(
            nn.LazyConv2d(64, kernel_size=7, stride=2, padding=3),
            nn.ReLU(), nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
Второй модуль использует два свёрточных слоя: сначала свёрточный слой с 64 каналами \(1\times 1\), за которым следует свёрточный слой \(3\times 3\), увеличивающий количество каналов в три раза. Это соответствует второй ветви блока Inception и завершает проектирование основной части сети. На этом этапе у нас есть 192 канала.
@d2l.add_to_class(GoogleNet)
def b2(self):
    return nn.Sequential(
        nn.LazyConv2d(64, kernel_size=1), nn.ReLU(),
        nn.LazyConv2d(192, kernel_size=3, padding=1), nn.ReLU(),
        nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
Третий модуль соединяет два полных блока Inception последовательно. Число выходных каналов первого блока Inception равно \(64+128+32+32=256\). Это соответствует соотношению чисел выходных каналов четырёх ветвей, равному \(2:4:1:1\). Для этого мы сначала уменьшаем размерность входных данных до \(\frac{1}{2}\) и до \(\frac{1}{12}\) каналов во второй и третьей ветвях соответственно, чтобы получить \(96 = 192/2\) и \(16 = 192/12\) каналов соответственно.
Число выходных каналов второго блока Inception увеличено до
\(128+192+96+64=480\), что дает соотношение
\(128:192:96:64 = 4:6:3:2\). Как и прежде, необходимо уменьшить
количество промежуточных каналов во втором и третьем блоках. Для этого
достаточно масштабных коэффициентов \(\frac{1}{2}\) и
\(\frac{1}{8}\) соответственно, что дает \(128\) и \(32\)
каналов. Это отражено в аргументах следующих конструкторов блоков
Inception.
@d2l.add_to_class(GoogleNet)
def b3(self):
    return nn.Sequential(Inception(64, (96, 128), (16, 32), 32),
                         Inception(128, (128, 192), (32, 96), 64),
                         nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
Четвертый модуль устроен сложнее. Он соединяет пять блоков Inception последовательно, и они имеют \(192+208+48+64=512\), \(160+224+64+64=512\), \(128+256+64+64=512\), \(112+288+64+64=528\) и \(256+320+128+128=832\) выходных каналов соответственно. Количество каналов, отведенных этим ветвям, аналогично тому, что было в третьем модуле: вторая ветвь со свёрточным слоем \(3\times 3\) выдает наибольшее количество каналов, за ней следует первая ветвь, содержащая только свёрточный слой \(1\times 1\), третья ветвь со свёрточным слоем \(5\times 5\) и четвертая ветвь со слоем пулинга \(3\times 3\). Во второй и третьей ветвях количество каналов сначала уменьшается в соответствии с заданными соотношениями. Эти соотношения немного различаются в разных блоках Inception.
@d2l.add_to_class(GoogleNet)
def b4(self):
    return nn.Sequential(Inception(192, (96, 208), (16, 48), 64),
                         Inception(160, (112, 224), (24, 64), 64),
                         Inception(128, (128, 256), (24, 64), 64),
                         Inception(112, (144, 288), (32, 64), 64),
                         Inception(256, (160, 320), (32, 128), 128),
                         nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
Пятый модуль содержит два блока Inception с \(256+320+128+128=832\) и \(384+384+128+128=1024\) выходными каналами. Количество каналов, выделенное для каждой ветви, такое же, как в третьем и четвертом модулях, но отличается конкретными значениями. Следует отметить, что после пятого блока следует выходной слой. Этот блок использует слой глобального пулинга для изменения высоты и ширины каждого канала до 1, как и в NiN. Наконец, мы преобразуем выход в двумерный массив, за которым следует полносвязный слой, количество выходов которого равно числу классов меток.
@d2l.add_to_class(GoogleNet)
def b5(self):
    return nn.Sequential(Inception(256, (160, 320), (32, 128), 128),
                         Inception(384, (192, 384), (48, 128), 128),
                         nn.AdaptiveAvgPool2d((1,1)), nn.Flatten())
Теперь, когда мы определили все блоки b1 через b5, остается лишь
собрать их в единую сеть.
@d2l.add_to_class(GoogleNet)
def __init__(self, lr=0.1, num_classes=10):
    super(GoogleNet, self).__init__()
    self.save_hyperparameters()
    self.net = nn.Sequential(self.b1(), self.b2(), self.b3(), self.b4(),
                             self.b5(), nn.LazyLinear(num_classes))
    self.net.apply(d2l.init_cnn)
Модель GoogLeNet вычислительно сложна. Обратите внимание на большое количество относительно произвольных гиперпараметров, таких как выбранное количество каналов, число блоков перед снижением размерности, относительное распределение ёмкости между каналами и т. д. Во многом это связано с тем, что на момент появления GoogLeNet ещё не существовало автоматических инструментов для определения архитектуры сети или исследования вариантов дизайна. Например, сегодня мы считаем само собой разумеющимся, что компетентный фреймворк для глубокого обучения способен автоматически выводить размерности входных тензоров. В то время многие такие конфигурации приходилось явно указывать экспериментатору, что часто замедляло активные эксперименты. Более того, инструменты, необходимые для автоматического исследования, всё ещё находились в стадии развития, а начальные эксперименты во многом сводились к дорогостоящему перебору, генетическим алгоритмам и подобным стратегиям.
На данный момент мы внесем лишь одно изменение: уменьшим высоту и ширину входа с 224 до 96, чтобы обеспечить приёмлемое время обучения на Fashion-MNIST. Это упрощает вычисления. Давайте посмотрим, как изменяется форма выходных данных между различными модулями.
model = GoogleNet().layer_summary((1, 1, 96, 96))
8.4.3. Обучение
Как и ранее, мы обучаем модель на наборе данных Fashion-MNIST. Перед запуском процедуры обучения мы приводим его к разрешению \(96 \times 96\) пикселей.
model = GoogleNet(lr=0.01)
trainer = d2l.Trainer(max_epochs=10, num_gpus=1)
data = d2l.FashionMNIST(batch_size=128, resize=(96, 96))
model.apply_init([next(iter(data.get_dataloader(True)))[0]], d2l.init_cnn)
trainer.fit(model, data)
8.4.4. Обсуждение
Ключевой особенностью GoogLeNet является то, что её вычисление обходится дешевле, чем у предшественников, при этом обеспечивается более высокая точность. Это знаменует начало более целенаправленного проектирования сетей, в котором компромисс заключается в балансе между вычислительной стоимостью оценки сети и снижением количества ошибок. Это также стало началом экспериментов с гиперпараметрами проектирования сети на уровне блоков, хотя на тот момент всё делалось полностью вручную. Мы вернёмся к этой теме в Section 8.8 при обсуждении стратегий исследования структуры сети.
В следующих разделах мы рассмотрим ряд архитектурных решений (например, батч-нормализацию, остаточные связи и группировку каналов), которые позволяют существенно улучшить сети. Пока же вы можете гордиться тем, что реализовали, пожалуй, первую по-настоящему современную свёрточную нейронную сеть.
8.4.5. Упражнения
GoogLeNet оказался настолько успешным, что прошёл через ряд итераций, последовательно улучшая скорость и точность. Попробуйте реализовать и запустить некоторые из них. К ним относятся следующие:
Добавьте слой батч-нормализации (Ioffe and Szegedy, 2015), как описано далее в Section 8.5.
Внесите изменения в блок Inception (ширину, выбор и порядок свёрток), как описано в Szegedy et al. (2016).
Используйте сглаживание меток для регуляризации модели, как описано в Szegedy et al. (2016).
Внесите дополнительные изменения в блок Inception, добавив остаточную связь (Szegedy et al., 2017), как описано далее в Section 8.6.
Каков минимальный размер изображения, необходимый для работы GoogLeNet?
Можете ли вы разработать вариант GoogLeNet, который работает с родным разрешением Fashion-MNIST в \(28 \times 28\) пикселей? Каким образом потребуется изменить начальный блок, основную часть и выходной слой сети, если это вообще необходимо?
Сравните размеры параметров моделей AlexNet, VGG, NiN и GoogLeNet. Как архитектуры последних двух сетей существенно уменьшают размер параметров модели?
Сравните объём вычислений, необходимых для GoogLeNet и AlexNet. Как это влияет на проектирование чипа-акселератора, например, с точки зрения размера памяти, пропускной способности памяти, размера кэша, объёма вычислений и эффективности специализированных операций?