
10.2. Блоки с управляемыми переходами (GRU)
По мере того как рекуррентные нейронные сети и, в частности, архитектура LSTM (Section 10.1) быстро набирали популярность в 2010-х годах, ряд исследователей начал экспериментировать с упрощёнными архитектурами в надежде сохранить ключевую идею использования внутреннего состояния и механизмов мультипликативного управления, но с целью ускорения вычислений. Управляемый рекуррентный блок (GRU) (Cho et al., 2014) предложил упрощённую версию ячейки памяти LSTM, которая часто достигает сопоставимой производительности, но имеет преимущество в виде более быстрой вычислительной скорости (Chung et al., 2014).
import torch
from torch import nn
from d2l import torch as d2l
10.2.1. Вентиль сброса и вентиль обновления
В данном случае три вентиля LSTM заменяются двумя: вентилем сброса и вентилем обновления. Как и в LSTM, эти вентили используют сигмоидную функцию активации, что приводит к тому, что их значения лежат в интервале \((0, 1)\). Интуитивно вентиль сброса контролирует, какая часть предыдущего состояния всё ещё может быть полезна для запоминания. Аналогично, вентиль обновления позволяет управлять тем, насколько новое состояние является копией старого. Fig. 10.2.1 иллюстрирует входы для вентилей сброса и обновления в GRU, учитывая вход текущего временного шага и скрытое состояние предыдущего временного шага. Выходы вентилей формируются двумя полносвязными слоями с сигмоидной функцией активации.
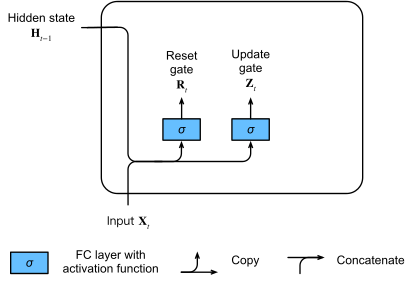
Fig. 10.2.1 Вычисление вентиля сброса и вентиля обновления в модели GRU.
Математически, для заданного шага времени \(t\), предположим, что входом является мини-батч \(\mathbf{X}_t \in \mathbb{R}^{n \times d}\) (количество примеров \(=n\); количество входов \(=d\)), а скрытое состояние предыдущего шага времени равно \(\mathbf{H}_{t-1} \in \mathbb{R}^{n \times h}\) (количество скрытых единиц \(=h\)). Тогда вентиль сброса \(\mathbf{R}_t \in \mathbb{R}^{n \times h}\) и вентиль обновления \(\mathbf{Z}_t \in \mathbb{R}^{n \times h}\) вычисляются следующим образом:
где \(\mathbf{W}_{\textrm{xr}}, \mathbf{W}_{\textrm{xz}} \in \mathbb{R}^{d \times h}\) и \(\mathbf{W}_{\textrm{hr}}, \mathbf{W}_{\textrm{hz}} \in \mathbb{R}^{h \times h}\) — параметры весов, а \(\mathbf{b}_\textrm{r}, \mathbf{b}_\textrm{z} \in \mathbb{R}^{1 \times h}\) — параметры смещения.
10.2.2. Кандидатное скрытое состояние
Далее мы объединяем вентиль сброса \(\mathbf{R}_t\) с обычным механизмом обновления из (9.4.5), что приводит к следующему кандидату скрытого состояния \(\tilde{\mathbf{H}}_t \in \mathbb{R}^{n \times h}\) на шаге времени \(t\):
где \(\mathbf{W}_{\textrm{xh}} \in \mathbb{R}^{d \times h}\) и \(\mathbf{W}_{\textrm{hh}} \in \mathbb{R}^{h \times h}\) — параметры весов, \(\mathbf{b}_\textrm{h} \in \mathbb{R}^{1 \times h}\) — смещение, а символ \(\odot\) обозначает поэлементное произведение Адамара. Здесь используется функция активации tanh.
Полученное значение является кандидатом, поскольку нам всё ещё необходимо учесть действие вентиля обновления. Сравнивая с (9.4.5), можно заметить, что влияние предыдущих состояний теперь может быть уменьшено за счёт поэлементного умножения \(\mathbf{R}_t\) и \(\mathbf{H}_{t-1}\) в (10.2.2). Если элементы вентиля сброса \(\mathbf{R}_t\) близки к 1, мы получаем обычную рекуррентную нейронную сеть (vanilla RNN), такую как в (9.4.5). Для всех элементов вентиля сброса \(\mathbf{R}_t\), близких к 0, кандидат скрытого состояния представляет собой результат многослойного перцептрона (MLP) с входом \(\mathbf{X}_t\). Таким образом, любое ранее существовавшее скрытое состояние сбрасывается до значений по умолчанию.
Fig. 10.2.2 иллюстрирует вычислительный поток после применения вентиля сброса.
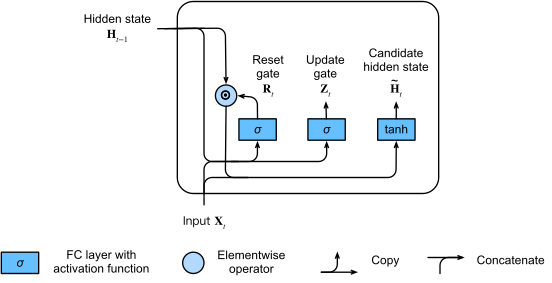
Fig. 10.2.2 Вычисление кандидата скрытого состояния в модели GRU.
10.2.3. Скрытое состояние
Наконец, нам необходимо учесть влияние вентиля обновления \(\mathbf{Z}_t\). Он определяет, в какой степени новое скрытое состояние \(\mathbf{H}_t \in \mathbb{R}^{n \times h}\) совпадает со старым состоянием \(\mathbf{H}_{t-1}\) по сравнению с тем, насколько оно похоже на новый кандидат состояния \(\tilde{\mathbf{H}}_t\). Для этой цели можно использовать вентиль обновления \(\mathbf{Z}_t\), просто вычисляя поэлементные выпуклые комбинации \(\mathbf{H}_{t-1}\) и \(\tilde{\mathbf{H}}_t\). Это приводит к окончательному уравнению обновления для GRU:
Когда вентиль обновления \(\mathbf{Z}_t\) близок к 1, мы просто сохраняем предыдущее состояние. В этом случае информация из \(\mathbf{X}_t\) игнорируется, что фактически пропускает временной шаг \(t\) в цепи зависимостей. Напротив, когда вентиль обновления \(\mathbf{Z}_t\) близок к 0, новое латентное состояние \(\mathbf{H}_t\) приближается к кандидату латентного состояния \(\tilde{\mathbf{H}}_t\). Fig. 10.2.3 показывает вычислительный поток после того, как начинает действовать вентиль обновления.
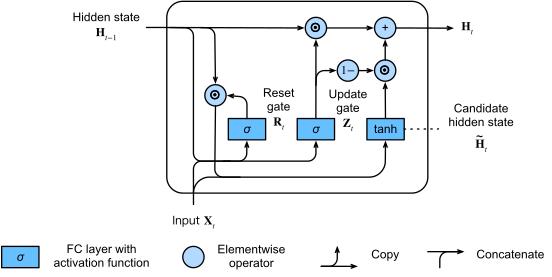
Fig. 10.2.3 Вычисление скрытого состояния в модели GRU.
Итак, GRU обладают следующими двумя отличительными особенностями:
Врата сброса помогают улавливать краткосрочные зависимости в последовательностях.
Врата обновления помогают захватывать долгосрочные зависимости в последовательностях.
10.2.4. Реализация с нуля
Чтобы лучше понять модель GRU, давайте реализуем её с нуля.
10.2.4.1. Инициализация параметров модели
Первый шаг — инициализация параметров модели. Веса выбираются из
гауссовского распределения со стандартным отклонением sigma, а
смещение устанавливается равным 0. Гиперпараметр num_hiddens
определяет количество скрытых единиц. Инициализируются все веса и
смещения, связанные с вентилем обновления, вентилем сброса и кандидатом
скрытого состояния.
class GRUScratch(d2l.Module):
    def __init__(self, num_inputs, num_hiddens, sigma=0.01):
        super().__init__()
        self.save_hyperparameters()

        init_weight = lambda *shape: nn.Parameter(torch.randn(*shape) * sigma)
        triple = lambda: (init_weight(num_inputs, num_hiddens),
                          init_weight(num_hiddens, num_hiddens),
                          nn.Parameter(torch.zeros(num_hiddens)))
        self.W_xz, self.W_hz, self.b_z = triple()  # Update gate
        self.W_xr, self.W_hr, self.b_r = triple()  # Reset gate
        self.W_xh, self.W_hh, self.b_h = triple()  # Candidate hidden state
10.2.4.2. Определение модели
Теперь мы готовы определить прямое распространение в GRU. Его структура аналогична структуре базовой ячейки RNN, за исключением того, что уравнения обновления более сложны.
@d2l.add_to_class(GRUScratch)
def forward(self, inputs, H=None):
    if H is None:
        # Initial state with shape: (batch_size, num_hiddens)
        H = torch.zeros((inputs.shape[1], self.num_hiddens),
                      device=inputs.device)
    outputs = []
    for X in inputs:
        Z = torch.sigmoid(torch.matmul(X, self.W_xz) +
                        torch.matmul(H, self.W_hz) + self.b_z)
        R = torch.sigmoid(torch.matmul(X, self.W_xr) +
                        torch.matmul(H, self.W_hr) + self.b_r)
        H_tilde = torch.tanh(torch.matmul(X, self.W_xh) +
                           torch.matmul(R * H, self.W_hh) + self.b_h)
        H = Z * H + (1 - Z) * H_tilde
        outputs.append(H)
    return outputs, H
10.2.4.3. Обучение
Обучение языковой модели на наборе данных The Time Machine происходит точно так же, как в Section 9.5.
data = d2l.TimeMachine(batch_size=1024, num_steps=32)
gru = GRUScratch(num_inputs=len(data.vocab), num_hiddens=32)
model = d2l.RNNLMScratch(gru, vocab_size=len(data.vocab), lr=4)
trainer = d2l.Trainer(max_epochs=50, gradient_clip_val=1, num_gpus=1)
trainer.fit(model, data)
10.2.5. Краткая реализация
В высокоуровневых API мы можем напрямую создать модель GRU. Это инкапсулирует все детали конфигурации, которые мы выше указывали явно.
class GRU(d2l.RNN):
    def __init__(self, num_inputs, num_hiddens):
        d2l.Module.__init__(self)
        self.save_hyperparameters()
        self.rnn = nn.GRU(num_inputs, num_hiddens)
Код значительно быстрее работает при обучении, поскольку использует скомпилированные операторы, а не Python.
gru = GRU(num_inputs=len(data.vocab), num_hiddens=32)
model = d2l.RNNLM(gru, vocab_size=len(data.vocab), lr=4)
trainer.fit(model, data)
После обучения мы выводим перплексивность на обучающей выборке и предсказанную последовательность, следующую за указанным префиксом.
model.predict('it has', 20, data.vocab, d2l.try_gpu())
10.2.6. Резюме
По сравнению с LSTM, GRU обеспечивают сопоставимое качество, но требуют меньших вычислительных затрат. Как правило, по сравнению с простыми RNN, сети с вентилями, такие как LSTM и GRU, лучше улавливают зависимости в последовательностях с большими временными интервалами. GRU содержат простые RNN в качестве предельного случая, когда вентиль сброса включен. Они также могут пропускать подпоследовательности, включая вентиль обновления.
10.2.7. Упражнения
Предположим, что мы хотим использовать только входные данные на временном шаге \(t'\) для предсказания выхода на временном шаге \(t > t'\). Каковы наилучшие значения для врат сброса и врат обновления на каждом временном шаге?
Настройте гиперпараметры и проанализируйте их влияние на время выполнения, перплексивность и выходную последовательность.
Сравните время выполнения, перплексивность и выходные строки для реализаций
rnn.RNNиrnn.GRUмежду собой.Что произойдет, если реализовать только часть GRU, например, только вентиль сброса или только вентиль обновления?