
11.5. Многоголовое внимание
На практике, имея один и тот же набор запросов, ключей и значений, мы можем захотеть, чтобы наша модель объединяла знания из различных режимов работы одного механизма внимания, например, захватывая зависимости различных диапазонов (например, краткосрочные и долгосрочные) внутри последовательности. Таким образом, может быть полезно позволить механизму внимания совместно использовать различные подпространства представлений запросов, ключей и значений.
Для этого вместо выполнения одного агрегирования по вниманию запросы, ключи и значения преобразуются с помощью \(h\) независимо обучаемых линейных проекций. Затем эти \(h\) спроецированные запросы, ключи и значения подаются на агрегирование по вниманию параллельно. В результате \(h\) выходы агрегирования по вниманию конкатенируются и преобразуются с помощью ещё одной обучаемой линейной проекции для получения итогового результата. Такая конструкция называется многослойным вниманием (multi-head attention), где каждый из \(h\) выходов агрегирования по вниманию является головой (head) (Vaswani et al., 2017). Многослойное внимание с использованием полносвязных слоёв для выполнения обучаемых линейных преобразований описано в Fig. 11.5.1.
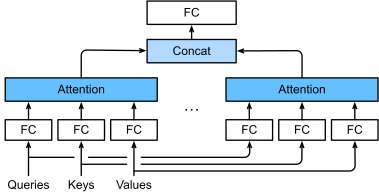
Fig. 11.5.1 Многоголовое внимание, в котором несколько механизмов внимания объединяются, а затем линейно преобразуются.
import math
import torch
from torch import nn
from d2l import torch as d2l
11.5.1. Модель
Прежде чем перейти к реализации механизма многоголовного внимания, формализуем эту модель математически. Для заданных запроса \(\mathbf{q} \in \mathbb{R}^{d_q}\), ключа \(\mathbf{k} \in \mathbb{R}^{d_k}\) и значения \(\mathbf{v} \in \mathbb{R}^{d_v}\) каждый механизм внимания \(\mathbf{h}_i\) (\(i = 1, \ldots, h\)) вычисляется следующим образом:
где \(\mathbf W_i^{(q)}\in\mathbb R^{p_q\times d_q}\), \(\mathbf W_i^{(k)}\in\mathbb R^{p_k\times d_k}\) и \(\mathbf W_i^{(v)}\in\mathbb R^{p_v\times d_v}\) — обучаемые параметры, а \(f\) — агрегирование по вниманию, например, аддитивное внимание и взвешенное скалярное произведение из Section 11.3. Выход многоголовного внимания представляет собой ещё одну линейную трансформацию, выполненную с помощью обучаемых параметров \(\mathbf W_o\in\mathbb R^{p_o\times h p_v}\) над конкатенацией \(h\) голов:
Исходя из этой архитектуры, каждый заголовок может обращать внимание на разные части входных данных. Можно выразить более сложные функции, чем простое взвешенное среднее.
11.5.2. Реализация
В нашей реализации мы используем масштабированное скалярное
произведение для каждого заголовка механизма многоголовного внимания.
Чтобы избежать значительного роста вычислительных затрат и затрат на
параметризацию, мы устанавливаем \(p_q = p_k = p_v = p_o / h\).
Обратите внимание, что \(h\) заголовков могут быть вычислены
параллельно, если мы установим количество выходов линейных
преобразований для запроса, ключа и значения равным
\(p_q h = p_k h = p_v h = p_o\). В следующей реализации \(p_o\)
указывается через аргумент num_hiddens.
class MultiHeadAttention(d2l.Module):  #@save
    """Multi-head attention."""
    def __init__(self, num_hiddens, num_heads, dropout, bias=False, **kwargs):
        super().__init__()
        self.num_heads = num_heads
        self.attention = d2l.DotProductAttention(dropout)
        self.W_q = nn.LazyLinear(num_hiddens, bias=bias)
        self.W_k = nn.LazyLinear(num_hiddens, bias=bias)
        self.W_v = nn.LazyLinear(num_hiddens, bias=bias)
        self.W_o = nn.LazyLinear(num_hiddens, bias=bias)

    def forward(self, queries, keys, values, valid_lens):
        # Shape of queries, keys, or values:
        # (batch_size, no. of queries or key-value pairs, num_hiddens)
        # Shape of valid_lens: (batch_size,) or (batch_size, no. of queries)
        # After transposing, shape of output queries, keys, or values:
        # (batch_size * num_heads, no. of queries or key-value pairs,
        # num_hiddens / num_heads)
        queries = self.transpose_qkv(self.W_q(queries))
        keys = self.transpose_qkv(self.W_k(keys))
        values = self.transpose_qkv(self.W_v(values))

        if valid_lens is not None:
            # On axis 0, copy the first item (scalar or vector) for num_heads
            # times, then copy the next item, and so on
            valid_lens = torch.repeat_interleave(
                valid_lens, repeats=self.num_heads, dim=0)

        # Shape of output: (batch_size * num_heads, no. of queries,
        # num_hiddens / num_heads)
        output = self.attention(queries, keys, values, valid_lens)
        # Shape of output_concat: (batch_size, no. of queries, num_hiddens)
        output_concat = self.transpose_output(output)
        return self.W_o(output_concat)
Чтобы обеспечить параллельное вычисление нескольких голов,
вышеуказанный класс MultiHeadAttention использует два метода
транспонирования, определённые ниже. В частности, метод
transpose_output обращает действие метода transpose_qkv.
@d2l.add_to_class(MultiHeadAttention)  #@save
def transpose_qkv(self, X):
    """Transposition for parallel computation of multiple attention heads."""
    # Shape of input X: (batch_size, no. of queries or key-value pairs,
    # num_hiddens). Shape of output X: (batch_size, no. of queries or
    # key-value pairs, num_heads, num_hiddens / num_heads)
    X = X.reshape(X.shape[0], X.shape[1], self.num_heads, -1)
    # Shape of output X: (batch_size, num_heads, no. of queries or key-value
    # pairs, num_hiddens / num_heads)
    X = X.permute(0, 2, 1, 3)
    # Shape of output: (batch_size * num_heads, no. of queries or key-value
    # pairs, num_hiddens / num_heads)
    return X.reshape(-1, X.shape[2], X.shape[3])

@d2l.add_to_class(MultiHeadAttention)  #@save
def transpose_output(self, X):
    """Reverse the operation of transpose_qkv."""
    X = X.reshape(-1, self.num_heads, X.shape[1], X.shape[2])
    X = X.permute(0, 2, 1, 3)
    return X.reshape(X.shape[0], X.shape[1], -1)
Давайте проверим наш реализованный MultiHeadAttention класс на
простом примере, где ключи и значения совпадают. В результате форма
вывода механизма многоголовного внимания имеет вид (batch_size,
num_queries, num_hiddens).
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_heads, 0.5)
batch_size, num_queries, num_kvpairs = 2, 4, 6
valid_lens = torch.tensor([3, 2])
X = torch.ones((batch_size, num_queries, num_hiddens))
Y = torch.ones((batch_size, num_kvpairs, num_hiddens))
d2l.check_shape(attention(X, Y, Y, valid_lens),
                (batch_size, num_queries, num_hiddens))
11.5.3. Итог
Многоголовое внимание объединяет результаты агрегирования по вниманию, используя различные подпространства представлений запросов, ключей и значений. Для параллельного вычисления нескольких голов многоголовного внимания требуется соответствующая манипуляция с тензорами.
11.5.4. Упражнения
Визуализируйте веса внимания нескольких голов в этом эксперименте.
Предположим, у нас есть обученная модель на основе многоголовых механизмов внимания, и мы хотим отсечь менее важные механизмы внимания, чтобы повысить скорость предсказания. Как спроектировать эксперименты для оценки важности механизма внимания?