
9. Рекуррентные нейронные сети
До сих пор мы сосредотачивались преимущественно на данных фиксированной длины. При введении линейной и логистической регрессии в Section 3 и Section 4, а также многослойных перцептронов в Section 5, мы без труда предполагали, что каждый вектор признаков \(\mathbf{x}_i\) состоит из фиксированного числа компонент \(x_1, \dots, x_d\), где каждый числовой признак \(x_j\) соответствует определённому атрибуту. Такие наборы данных иногда называют табличными, поскольку их можно представить в виде таблиц, где каждый пример \(i\) занимает отдельную строку, а каждый атрибут — отдельный столбец. Важно, что для табличных данных мы редко предполагаем какую-либо особую структуру столбцов.
Далее, в Section 7, мы перешли к данным изображений, где входные данные состоят из значений пикселей в каждой координате изображения. Такие данные плохо подходили под определение типичного табличного набора данных. Там нам пришлось использовать свёрточные нейронные сети (CNN), чтобы учесть иерархическую структуру и инвариантность. Однако наши данные всё ещё имели фиксированную длину. Каждое изображение из набора данных Fashion-MNIST представлено в виде сетки размером \(28 \times 28\). Более того, наша цель заключалась в разработке модели, которая рассматривала бы одно изображение и выдавала бы одно предсказание. Но что делать, если мы сталкиваемся с последовательностью изображений, как в видео, или если задача состоит в том, чтобы сгенерировать предсказание с последовательной структурой, как в случае с генерацией подписей к изображениям?
Многие задачи обучения требуют работы с последовательными данными. Генерация подписей к изображениям, синтез речи и генерация музыки требуют, чтобы модели выдавали выходные данные в виде последовательностей. В других областях, таких как прогнозирование временных рядов, анализ видео и извлечение музыкальной информации, модель должна обучаться на входных данных, представляющих собой последовательности. Эти требования часто возникают одновременно: такие задачи, как перевод текстовых фрагментов с одного естественного языка на другой, ведение диалога или управление роботом, требуют, чтобы модели одновременно принимали и генерировали данные, структурированные как последовательности.
Рекуррентные нейронные сети (RNN) — это модели глубокого обучения, которые описывают динамику последовательностей с помощью рекуррентных связей, которые можно рассматривать как циклы в сети узлов. Поначалу это может показаться неочевидным. Ведь именноFeedforward-характер нейронных сетей делает порядок вычислений однозначным. Однако рекуррентные связи определены таким образом, который гарантирует отсутствие подобной неоднозначности. Рекуррентные нейронные сети разворачиваются во времени (или по шагам последовательности), при этом на каждом шаге применяются одни и те же параметры. В то время как стандартные связи применяются синхронно для передачи активаций каждого слоя следующему слою в один и тот же момент времени, рекуррентные связи являются динамическими и передают информацию между соседними временными шагами. Как показывает развернутый вид на Fig. 9.1, RNN можно рассматривать как feedforward-нейронные сети, в которых параметры каждого слоя (как обычные, так и рекуррентные) разделяются между временными шагами.
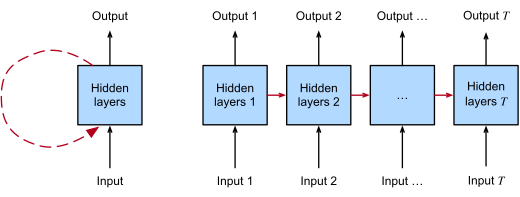
Fig. 9.1 Слева рекуррентные связи изображены в виде циклических ребер. Справа показано развертывание RNN по временным шагам. При этом рекуррентные ребра соединяют соседние временные шаги, а обычные связи вычисляются синхронно.
Как и нейронные сети в целом, рекуррентные нейронные сети (RNN) имеют долгую историю, охватывающую различные научные дисциплины. Они возникли как модели мозга, популяризированные когнитивистами, а впоследствии были приняты в качестве практических инструментов моделирования сообществом машинного обучения. Как и в случае с глубоким обучением в целом, в этой книге мы придерживаемся точки зрения машинного обучения, рассматривая RNN как практические инструменты, которые стали популярны в 2010-х годах благодаря прорывным результатам в таких разнообразных задачах, как распознавание рукописного текста (Graves et al., 2008), машинный перевод (Sutskever et al., 2014) и распознавание медицинских диагнозов (Lipton et al., 2016). Читателям, интересующимся более подробной справочной информацией, рекомендуем обратиться к общедоступному подробному обзору (Lipton et al., 2015). Также отметим, что последовательность не является уникальной характеристикой RNN. Например, свёрточные нейронные сети (CNN), которые мы уже рассматривали, можно адаптировать для обработки данных переменной длины, например, изображений разного разрешения. Более того, в последнее время RNN уступили значительную долю рынка моделям на основе трансформеров, которые будут рассмотрены в Section 11. Тем не менее, RNN стали доминирующими моделями для обработки сложной последовательной структуры в глубоком обучении и остаются ключевыми моделями для моделирования последовательностей и по сей день. История RNN и история моделирования последовательностей неразрывно связаны, и эта глава посвящена не только основам RNN, но и базовым принципам решения задач моделирования последовательностей.
Одно ключевое наблюдение проложило путь к революции в моделировании последовательностей. Хотя входные данные и целевые значения для многих фундаментальных задач машинного обучения трудно представить в виде векторов фиксированной длины, их часто можно представить в виде последовательностей переменной длины, состоящих из векторов фиксированной длины. Например, документы можно представить как последовательности слов; медицинские записи часто можно представить как последовательности событий (консультации, лекарства, процедуры, лабораторные тесты, диагнозы); видео можно представить как последовательности кадров переменной длины.
Хотя модели последовательностей применяются во множестве областей, фундаментальные исследования в этой области в основном продвигались благодаря успехам в решении ключевых задач обработки естественного языка. Поэтому в этой главе мы сосредоточим изложение и примеры на текстовых данных. Если вы разберетесь с этими примерами, то применение моделей к другим типам данных будет относительно простым. В следующих разделах мы введем базовую нотацию для последовательностей и некоторые меры оценки качества выходных данных моделей со структурой последовательности. Затем мы обсудим основные понятия языковой модели и используем это обсуждение, чтобы обосновать наши первые модели рекуррентных нейронных сетей (RNN). Наконец, мы опишем метод вычисления градиентов при обратном распространении ошибки через RNN и исследуем некоторые проблемы, с которыми часто сталкиваются при обучении таких сетей, что мотивирует использование современных архитектур RNN, которые будут рассмотрены в Section 10.
- 9.1. Работа с последовательностями
- 9.2. Преобразование исходного текста в данные последовательности
- 9.3. Языковые модели
- 9.4. Рекуррентные нейронные сети
- 9.5. Реализация рекуррентной нейронной сети с нуля
- 9.6. Краткая реализация рекуррентных нейронных сетей
- 9.7. Обратное распространение ошибки через время