
6.1. Слои и модули
Когда мы впервые знакомились с нейронными сетями, мы рассматривали линейные модели с одним выходом. В этом случае вся модель состоит всего из одного нейрона. Обратите внимание, что один нейрон (i) принимает набор входов; (ii) генерирует соответствующий скалярный выход; и (iii) имеет набор параметров, которые можно обновлять для оптимизации некоторой целевой функции. Затем, когда мы начали рассматривать сети с несколькими выходами, мы использовали векторизованные вычисления для описания целого слоя нейронов. Подобно отдельным нейронам, слои (i) принимают набор входов, (ii) генерируют соответствующие выходы и (iii) описываются набором настраиваемых параметров. При изучении софтмакс-регрессии один слой сам по себе являлся моделью. Однако даже после введения многослойных перцептронов (MLP) мы по-прежнему можем рассматривать модель как сохраняющую эту базовую структуру.
Интересно, что для многослойных перцептронов (MLP) и вся модель в целом, и её отдельные слои обладают этой структурой. Вся модель принимает на вход исходные данные (признаки), формирует выходные значения (предсказания) и содержит параметры (совокупность параметров всех составляющих её слоёв). Аналогично, каждый отдельный слой получает на вход данные (предоставленные предыдущим слоем), формирует выходные значения (которые становятся входными данными для следующего слоя) и содержит набор настраиваемых параметров, обновляемых в соответствии с сигналом, распространяющимся назад от последующего слоя.
Хотя может показаться, что нейроны, слои и модели предоставляют нам достаточный уровень абстракции для решения наших задач, на практике оказывается удобным оперировать компонентами, которые больше отдельного слоя, но меньше всей модели в целом. Например, архитектура ResNet-152, широко популярная в компьютерном зрении, состоит из сотен слоёв. Эти слои образуют повторяющиеся паттерны групп слоёв. Реализация такой сети слой за слоем может оказаться утомительной. Эта проблема не является гипотетической — подобные шаблоны проектирования широко распространены на практике. Упомянутая выше архитектура ResNet стала победителем соревнований ImageNet и COCO по компьютерному зрению в задачах распознавания и обнаружения объектов в 2015 году (He et al., 2016) и до сих пор остается одним из основных выборов для многих задач компьютерного зрения. Подобные архитектуры, в которых слои организованы в различные повторяющиеся паттерны, теперь повсеместно используются и в других областях, включая обработку естественного языка и обработку речи.
Для реализации таких сложных нейронных сетей мы вводим понятие модуля нейронной сети. Модуль может описывать отдельный слой, компонент, состоящий из нескольких слоёв, или всю модель целиком! Одно из преимуществ абстракции модуля заключается в том, что их можно комбинировать для создания более крупных структур, часто рекурсивно. Это проиллюстрировано на рисунке Fig. 6.1.1. Определяя код для генерации модулей произвольной сложности по требованию, мы можем писать удивительно компактный код и при этом реализовывать сложные нейронные сети.
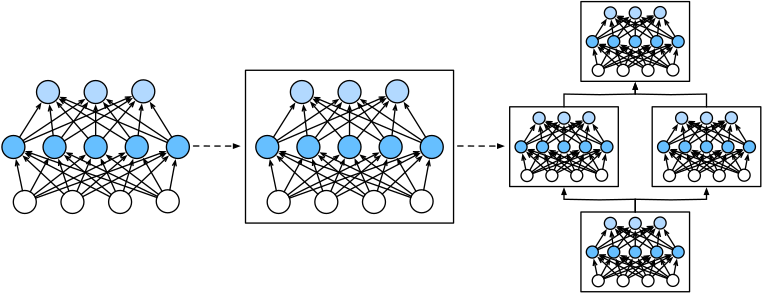
Fig. 6.1.1 Несколько слоёв объединяются в модули, формируя повторяющиеся структуры более крупных моделей.
С точки зрения программирования модуль представляется в виде класса. Любой его подкласс должен определять метод прямого распространения, преобразующий входные данные в выходные, и хранить все необходимые параметры. Обратите внимание, что некоторые модули вообще не требуют параметров. Наконец, модуль должен обладать методом обратного распространения ошибки для вычисления градиентов. К счастью, благодаря некоторой внутренней магии, предоставляемой автоматическим дифференцированием (описанным в Section 2.5) при определении собственного модуля, нам нужно заботиться только о параметрах и методе прямого распространения.
import torch
from torch import nn
from torch.nn import functional as F
Для начала мы вернемся к коду, который использовали для реализации многослойных перцептронов (Section 5.1). Приведённый ниже код создает сеть с одним скрытым полносвязным слоем из 256 нейронов и функцией активации ReLU, за которым следует выходной полносвязный слой из десяти нейронов (без функции активации).
net = nn.Sequential(nn.LazyLinear(256), nn.ReLU(), nn.LazyLinear(10))

X = torch.rand(2, 20)
net(X).shape
В этом примере мы построили модель, создав экземпляр nn.Sequential,
передав слои в порядке их выполнения в качестве аргументов. Проще
говоря, nn.Sequential определяет специальный вид Module, класса,
который представляет модуль в PyTorch. Он поддерживает упорядоченный
список входящих в него Module. Обратите внимание, что каждый из двух
полносвязных слоёв является объектом класса Linear, который сам
является подклассом Module. Метод прямого распространения
(forward) также remarkably прост: он соединяет каждый модуль в
списке, передавая выход каждого в качестве входа для следующего.
Обратите внимание, что до сих пор мы вызывали наши модели с помощью
конструкции net(X) для получения их выходов. На самом деле это
просто сокращение для net.__call__(X).
6.1.1. Пользовательский модуль
Возможно, самый простой способ развить интуитивное понимание работы модуля — реализовать его самостоятельно. Прежде чем мы это сделаем, кратко перечислим базовую функциональность, которую должен обеспечивать каждый модуль:
Получать входные данные в качестве аргументов метода прямого распространения.
Сформируйте выходной сигнал, заставив метод прямого распространения вернуть значение. Обратите внимание, что форма выходного сигнала может отличаться от формы входного. Например, первый полносвязный слой в нашей модели выше принимает входные данные произвольной размерности, но возвращает выходные данные размерности 256.
Вычислите градиент выхода по входу, который можно получить с помощью его метода обратного распространения ошибки. Обычно это происходит автоматически.
Сохраняйте и предоставляйте доступ к параметрам, необходимым для выполнения вычислений прямого распространения.
Инициализируйте параметры модели по мере необходимости.
В приведённом ниже фрагменте мы с нуля реализуем модуль, соответствующий
многослойному перцептрону (MLP) с одним скрытым слоем, содержащим 256
скрытых единиц, и выходным слоем размерности 10. Обратите внимание, что
класс MLP наследуется от класса, представляющего модуль. Мы будем
активно использовать методы родительского класса, предоставив только
собственный конструктор (метод __init__ в Python) и метод прямого
распространения.
class MLP(nn.Module):
    def __init__(self):
        # Call the constructor of the parent class nn.Module to perform
        # the necessary initialization
        super().__init__()
        self.hidden = nn.LazyLinear(256)
        self.out = nn.LazyLinear(10)

    # Define the forward propagation of the model, that is, how to return the
    # required model output based on the input X
    def forward(self, X):
        return self.out(F.relu(self.hidden(X)))
Сначала сосредоточимся на методе прямого распространения. Обратите
внимание, что он принимает X в качестве входа, вычисляет скрытое
представление с применением функции активации и выдает логиты. В данной
реализации MLP оба слоя являются переменными объекта. Чтобы понять,
почему это разумно, представьте, что мы создали два объекта MLP,
net1 и net2, и обучили их на разных данных. Естественным образом
мы ожидаем, что они будут представлять две разные обученные модели.
Мы инстанцируем слои MLP в конструкторе и впоследствии вызываем эти
слои при каждом вызове метода прямого распространения. Обратите
внимание на несколько ключевых деталей. Во-первых, наш пользовательский
__init__ метод вызывает метод родительского класса __init__
через super().__init__(), что избавляет нас от необходимости заново
писать шаблонный код, применимый к большинству модулей. Затем мы создаём
два полносвязных слоя, назначая их self.hidden и self.out.
Обратите внимание, что если мы не реализуем новый слой, нам не нужно
беспокоиться о методе обратного распространения ошибки или
инициализации параметров. Система сгенерирует эти методы
автоматически. Давайте попробуем это сделать.
net = MLP()
net(X).shape
Ключевое достоинство абстракции модуля заключается в его
универсальности. Мы можем создавать подклассы модулей для построения
слоёв (например, класса полносвязного слоя), целых моделей (например,
класса MLP выше) или различных компонентов промежуточной сложности.
Мы будем использовать эту универсальность на протяжении следующих глав,
например, при рассмотрении свёрточных нейронных сетей.
6.1.2. Модуль Sequential
Теперь мы можем подробнее рассмотреть, как работает класс
Sequential. Напомним, что Sequential был разработан для
последовательного соединения других модулей. Чтобы создать наш
собственный упрощённый вариант MySequential, нам достаточно
определить два ключевых метода:
Метод для последовательного добавления модулей в список.
Метод прямого распространения для передачи входных данных через цепочку модулей в том же порядке, в котором они были добавлены.
Следующий MySequential класс обеспечивает ту же функциональность,
что и класс по умолчанию Sequential.
class MySequential(nn.Module):
    def __init__(self, *args):
        super().__init__()
        for idx, module in enumerate(args):
            self.add_module(str(idx), module)

    def forward(self, X):
        for module in self.children():
            X = module(X)
        return X
В методе __init__ мы добавляем каждый модуль, вызывая метод
add_modules. Эти модули можно будет получить доступ через метод
children в дальнейшем. Таким образом, система знает о добавленных
модулях и корректно инициализирует параметры каждого из них.
Когда вызывается метод прямого распространения нашего MySequential,
каждый добавленный модуль выполняется в том порядке, в котором они были
добавлены. Теперь мы можем переписать реализацию многослойного
перцептрона (MLP), используя наш класс MySequential.
net = MySequential(nn.LazyLinear(256), nn.ReLU(), nn.LazyLinear(10))
net(X).shape
Обратите внимание, что использование MySequential здесь полностью
идентично коду, который мы ранее написали для класса Sequential (как
описано в Section 5.1).
6.1.3. Выполнение кода в методе прямого распространения
Класс Sequential упрощает построение моделей, позволяя собирать
новые архитектуры без необходимости определять собственный класс. Однако
не все архитектуры представляют собой простые последовательные цепочки.
Когда требуется большая гибкость, нам нужно будет определять собственные
блоки. Например, мы можем захотеть выполнять управляющие конструкции
Python внутри метода прямого распространения. Кроме того, мы можем
выполнять произвольные математические операции, не ограничиваясь только
заранее определёнными слоями нейронной сети.
Вы могли заметить, что до сих пор все операции в наших сетях действовали
с активациями сети и её параметрами. Однако иногда нам может
потребоваться включить слагаемые, которые не являются результатом
предыдущих слоёв и не являются обновляемыми параметрами. Мы называем их
постоянными параметрами. Например, предположим, что нам нужен слой,
вычисляющий функцию
\(f(\mathbf{x},\mathbf{w}) = c \cdot \mathbf{w}^\top \mathbf{x}\),
где \(\mathbf{x}\) — это вход, \(\mathbf{w}\) — наш параметр, а
\(c\) — некоторая заданная константа, которая не обновляется в
процессе оптимизации. Тогда мы реализуем класс FixedHiddenMLP
следующим образом.
class FixedHiddenMLP(nn.Module):
    def __init__(self):
        super().__init__()
        # Random weight parameters that will not compute gradients and
        # therefore keep constant during training
        self.rand_weight = torch.rand((20, 20))
        self.linear = nn.LazyLinear(20)

    def forward(self, X):
        X = self.linear(X)
        X = F.relu(X @ self.rand_weight + 1)
        # Reuse the fully connected layer. This is equivalent to sharing
        # parameters with two fully connected layers
        X = self.linear(X)
        # Control flow
        while X.abs().sum() > 1:
            X /= 2
        return X.sum()
В этой модели мы реализуем скрытый слой, веса (self.rand_weight)
которого инициализируются случайным образом при создании экземпляра и
далее остаются неизменными. Этот вес не является параметром модели,
поэтому он никогда не обновляется в процессе обратного распространения
ошибки. Затем сеть пропускает выход этого «фиксированного» слоя через
полносвязный слой.
Обратите внимание, что перед возвратом результата наша модель выполнила
необычное действие. Мы запустили цикл while, проверяя условие, при
котором норма \(\ell_1\) превышает \(1\), и делили наш выходной
вектор на \(2\) до тех пор, пока условие не выполнялось. В конце мы
вернули сумму элементов в X. Насколько нам известно, ни одна
стандартная нейронная сеть не выполняет такую операцию. Заметим, что эта
конкретная операция может не иметь практической ценности для каких-либо
реальных задач. Наша цель — лишь продемонстрировать, как интегрировать
произвольный код в вычислительный процесс вашей нейронной сети.
net = FixedHiddenMLP()
net(X)
Мы можем комбинировать различные способы объединения модулей. В следующем примере мы рассмотрим некоторые креативные варианты вложенности модулей.
class NestMLP(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(nn.LazyLinear(64), nn.ReLU(),
                                 nn.LazyLinear(32), nn.ReLU())
        self.linear = nn.LazyLinear(16)

    def forward(self, X):
        return self.linear(self.net(X))

chimera = nn.Sequential(NestMLP(), nn.LazyLinear(20), FixedHiddenMLP())
chimera(X)
6.1.4. Резюме
Отдельные слои могут быть модулями. Несколько слоёв могут входить в состав одного модуля. Несколько модулей могут входить в состав одного модуля.
Модуль может содержать код. Модули берут на себя множество задач по
организации работы, включая инициализацию параметров и обратное
распространение ошибки. Последовательные соединения слоёв и модулей
обрабатываются с помощью модуля Sequential.
6.1.5. Упражнения
Какие проблемы возникнут, если вы измените
MySequential, чтобы хранить модули в списке Python?Реализуйте модуль, который принимает два модуля в качестве аргументов, скажем
net1иnet2, и возвращает конкатенированный вывод обеих сетей при прямом распространении. Это также называется параллельным модулем.Предположим, вы хотите объединить несколько экземпляров одной и той же сети. Реализуйте фабричную функцию, которая создает несколько экземпляров одного и того же модуля, и постройте на их основе более крупную сеть.