
16.5. Вывод в естественном языке: использование внимания
В разделе Section 16.4 мы познакомились с задачей естественного языкового вывода и набором данных SNLI. Учитывая, что многие модели основаны на сложных и глубоких архитектурах, в работе Parikh et al. (2016) было предложено решать задачу естественного языкового вывода с помощью механизмов внимания, назвав эту модель «разлагаемой моделью внимания». Это позволило создать архитектуру без рекуррентных или свёрточных слоёв, которая на момент публикации показала лучшие результаты на наборе данных SNLI при значительно меньшем количестве параметров. В этом разделе мы опишем и реализуем этот метод, основанный на внимании (с использованием многослойных перцептронов), для решения задачи естественного языкового вывода, как показано на рисунке Fig. 16.5.1.
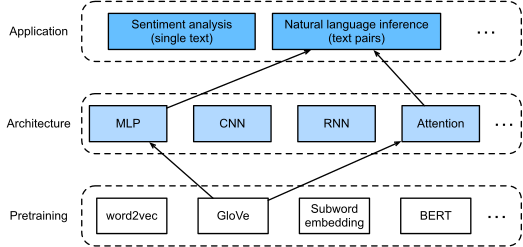
Fig. 16.5.1 В этом разделе предобученные векторы GloVe подаются на архитектуру, основанную на механизмах внимания и многослойных перцептронах (MLP), для решения задачи естественного языкового вывода.
16.5.1. Модель
Проще, чем сохранять порядок токенов в посылках и гипотезах, мы можем просто сопоставить каждый токен в одной текстовой последовательности с каждым токеном в другой и наоборот, а затем сравнить и агрегировать такую информацию, чтобы предсказать логические отношения между посылками и гипотезами. Подобно выравниванию токенов между исходным и целевым предложениями в машинном переводе, выравнивание токенов между посылками и гипотезами может быть аккуратно выполнено с помощью механизмов внимания.
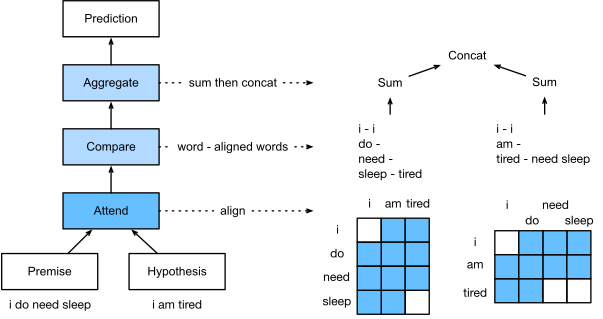
Fig. 16.5.2 Вывод на естественном языке с использованием механизмов внимания.
Fig. 16.5.2 иллюстрирует метод вывода на основе естественного языка с использованием механизмов внимания. В целом он состоит из трёх совместно обучаемых этапов: внимания, сравнения и агрегации. Далее мы рассмотрим их пошагово.
import torch
from torch import nn
from torch.nn import functional as F
from d2l import torch as d2l
16.5.1.1. Внимание
Первый шаг — выровнять каждый токен одной текстовой последовательности с каждым токеном другой. Предположим, что посылка (premise) — это «i do need sleep», а гипотеза (hypothesis) — «i am tired». Из-за семантического сходства мы можем захотеть выровнять «i» в гипотезе с «i» в посылке, а «tired» в гипотезе с «sleep» в посылке. Аналогично, мы можем захотеть выровнять «i» в посылке с «i» в гипотезе, а «need» и «sleep» в посылке с «tired» в гипотезе. Обратите внимание, что такое выравнивание является мягким (soft) и использует взвешенное среднее, где, в идеале, большие веса присваиваются токенам, которые должны быть выровнены. Для удобства демонстрации Fig. 16.5.2 показывает такое выравнивание в жёстком (hard) виде.
Теперь мы опишем мягкое выравнивание с использованием механизмов внимания более подробно. Обозначим через \(\mathbf{A} = (\mathbf{a}_1, \ldots, \mathbf{a}_m)\) и \(\mathbf{B} = (\mathbf{b}_1, \ldots, \mathbf{b}_n)\) посылку и гипотезу, количество токенов в которых равно \(m\) и \(n\) соответственно, где \(\mathbf{a}_i, \mathbf{b}_j \in \mathbb{R}^{d}\) (\(i = 1, \ldots, m, j = 1, \ldots, n\)) — это \(d\)-мерный вектор слова. Для мягкого выравнивания мы вычисляем веса внимания \(e_{ij} \in \mathbb{R}\) как
где функция \(f\) — это многослойный перцептрон, определённый в
следующей функции mlp. Размерность выхода \(f\) задаётся
аргументом num_hiddens функции mlp.
def mlp(num_inputs, num_hiddens, flatten):
    net = []
    net.append(nn.Dropout(0.2))
    net.append(nn.Linear(num_inputs, num_hiddens))
    net.append(nn.ReLU())
    if flatten:
        net.append(nn.Flatten(start_dim=1))
    net.append(nn.Dropout(0.2))
    net.append(nn.Linear(num_hiddens, num_hiddens))
    net.append(nn.ReLU())
    if flatten:
        net.append(nn.Flatten(start_dim=1))
    return nn.Sequential(*net)
Стоит отметить, что в (16.5.1) \(f\) принимает на вход \(\mathbf{a}_i\) и \(\mathbf{b}_j\) раздельно, а не в виде пары. Этот приём декомпозиции приводит к仅需 \(m + n\) применениям (линейная сложность) \(f\), вместо \(mn\) применений (квадратичная сложность).
Нормализуя веса внимания в (16.5.1), мы вычисляем взвешенное среднее всех векторов токенов в гипотезе, чтобы получить представление гипотезы, которое мягко согласуется с токеном под индексом \(i\) в посылке:
Аналогичным образом мы вычисляем мягкое выравнивание токенов предпосылки для каждого токена, соответствующего индексу \(j\) в гипотезе:
Ниже мы определяем класс Attend для вычисления мягкого выравнивания
гипотез (beta) с входными посылками A и мягкого выравнивания
посылок (alpha) с входными гипотезами B.
class Attend(nn.Module):
    def __init__(self, num_inputs, num_hiddens, **kwargs):
        super(Attend, self).__init__(**kwargs)
        self.f = mlp(num_inputs, num_hiddens, flatten=False)

    def forward(self, A, B):
        # Shape of `A`/`B`: (`batch_size`, no. of tokens in sequence A/B,
        # `embed_size`)
        # Shape of `f_A`/`f_B`: (`batch_size`, no. of tokens in sequence A/B,
        # `num_hiddens`)
        f_A = self.f(A)
        f_B = self.f(B)
        # Shape of `e`: (`batch_size`, no. of tokens in sequence A,
        # no. of tokens in sequence B)
        e = torch.bmm(f_A, f_B.permute(0, 2, 1))
        # Shape of `beta`: (`batch_size`, no. of tokens in sequence A,
        # `embed_size`), where sequence B is softly aligned with each token
        # (axis 1 of `beta`) in sequence A
        beta = torch.bmm(F.softmax(e, dim=-1), B)
        # Shape of `alpha`: (`batch_size`, no. of tokens in sequence B,
        # `embed_size`), where sequence A is softly aligned with each token
        # (axis 1 of `alpha`) in sequence B
        alpha = torch.bmm(F.softmax(e.permute(0, 2, 1), dim=-1), A)
        return beta, alpha
16.5.1.2. Сравнение
На следующем шаге мы сравниваем токен в одной последовательности с другой последовательностью, которая мягко выровнена с этим токеном. Обратите внимание, что при мягком выравнивании все токены из одной последовательности, хотя и с разными весами внимания, будут сравниваться с токеном в другой последовательности. Для наглядности Fig. 16.5.2 жёстко сопоставляет токены с выровненными токенами. Например, предположим, что шаг внимания определяет, что слова «need» и «sleep» в посылке оба выровнены со словом «tired» в гипотезе; тогда пара «tired–need sleep» будет сравниваться.
На этапе сравнения мы подаём на вход функции \(g\) (многослойному перцептрону) конкатенацию (оператор \([\cdot, \cdot]\)) токенов из одной последовательности и выровненных с ними токенов из другой последовательности:
В (16.5.4), \(\mathbf{v}_{A,i}\) представляет собой
сравнение токена \(i\) в посылке со всеми токенами гипотезы, которые
мягко выровнены с токеном \(i\); тогда как \(\mathbf{v}_{B,j}\)
— это сравнение токена \(j\) в гипотезе со всеми токенами посылки,
которые мягко выровнены с токеном \(j\). Приведённый ниже
Compare класс определяет такой шаг сравнения.
class Compare(nn.Module):
    def __init__(self, num_inputs, num_hiddens, **kwargs):
        super(Compare, self).__init__(**kwargs)
        self.g = mlp(num_inputs, num_hiddens, flatten=False)

    def forward(self, A, B, beta, alpha):
        V_A = self.g(torch.cat([A, beta], dim=2))
        V_B = self.g(torch.cat([B, alpha], dim=2))
        return V_A, V_B
16.5.1.3. Агрегация
Имея два набора векторов сравнения \(\mathbf{v}_{A,i}\) (\(i = 1, \ldots, m\)) и \(\mathbf{v}_{B,j}\) (\(j = 1, \ldots, n\)), на последнем этапе мы агрегируем эту информацию, чтобы установить логическую связь. Сначала просуммируем оба набора:
Далее мы подаём на вход функции \(h\) (многослойному перцептрону) конкатенацию обоих результатов суммаризации, чтобы получить результат классификации логической связи:
Этап агрегирования определяется в следующем классе Aggregate.
class Aggregate(nn.Module):
    def __init__(self, num_inputs, num_hiddens, num_outputs, **kwargs):
        super(Aggregate, self).__init__(**kwargs)
        self.h = mlp(num_inputs, num_hiddens, flatten=True)
        self.linear = nn.Linear(num_hiddens, num_outputs)

    def forward(self, V_A, V_B):
        # Sum up both sets of comparison vectors
        V_A = V_A.sum(dim=1)
        V_B = V_B.sum(dim=1)
        # Feed the concatenation of both summarization results into an MLP
        Y_hat = self.linear(self.h(torch.cat([V_A, V_B], dim=1)))
        return Y_hat
16.5.1.4. Объединяя всё вместе
Объединяя шаги внимания, сравнения и агрегации, мы определяем модель декомпозируемого внимания для совместного обучения этих трёх компонентов.
class DecomposableAttention(nn.Module):
    def __init__(self, vocab, embed_size, num_hiddens, num_inputs_attend=100,
                 num_inputs_compare=200, num_inputs_agg=400, **kwargs):
        super(DecomposableAttention, self).__init__(**kwargs)
        self.embedding = nn.Embedding(len(vocab), embed_size)
        self.attend = Attend(num_inputs_attend, num_hiddens)
        self.compare = Compare(num_inputs_compare, num_hiddens)
        # There are 3 possible outputs: entailment, contradiction, and neutral
        self.aggregate = Aggregate(num_inputs_agg, num_hiddens, num_outputs=3)

    def forward(self, X):
        premises, hypotheses = X
        A = self.embedding(premises)
        B = self.embedding(hypotheses)
        beta, alpha = self.attend(A, B)
        V_A, V_B = self.compare(A, B, beta, alpha)
        Y_hat = self.aggregate(V_A, V_B)
        return Y_hat
16.5.2. Обучение и оценка модели
Теперь мы обучим и оценим заданную модель декомпозируемого внимания на наборе данных SNLI. Начнём с загрузки набора данных.
16.5.2.1. Чтение набора данных
Мы загружаем и читаем набор данных SNLI с помощью функции, определённой в Section 16.4. Размер батча и длина последовательности устанавливаются равными \(256\) и \(50\) соответственно.
batch_size, num_steps = 256, 50
train_iter, test_iter, vocab = d2l.load_data_snli(batch_size, num_steps)
16.5.2.2. Создание модели
Мы используем предварительно обученный 100-мерный эмбеддинг GloVe для представления входных токенов. Таким образом, мы заранее задаем размерность векторов \(\mathbf{a}_i\) и \(\mathbf{b}_j\) в (16.5.1) равной 100. Размерность выхода функций \(f\) в (16.5.1) и \(g\) в (16.5.4) установлена равной 200. Затем создаем объект модели, инициализируем его параметры и загружаем эмбеддинг GloVe для инициализации векторов входных токенов.
embed_size, num_hiddens, devices = 100, 200, d2l.try_all_gpus()
net = DecomposableAttention(vocab, embed_size, num_hiddens)
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds);
16.5.2.3. Обучение и оценка модели
В отличие от функции split_batch в Section 13.5,
которая принимает одиночные входные данные, такие как текстовые
последовательности (или изображения), мы определяем функцию
split_batch_multi_inputs для обработки множественных входных данных,
таких как посылки и гипотезы, в мини-пакетах.
Теперь мы можем обучить и оценить модель на наборе данных SNLI.
lr, num_epochs = 0.001, 4
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
16.5.2.4. Использование модели
Наконец, определим функцию предсказания, которая выводит логическую связь между парой посылки и гипотезы.
#@save
def predict_snli(net, vocab, premise, hypothesis):
    """Predict the logical relationship between the premise and hypothesis."""
    net.eval()
    premise = torch.tensor(vocab[premise], device=d2l.try_gpu())
    hypothesis = torch.tensor(vocab[hypothesis], device=d2l.try_gpu())
    label = torch.argmax(net([premise.reshape((1, -1)),
                           hypothesis.reshape((1, -1))]), dim=1)
    return 'entailment' if label == 0 else 'contradiction' if label == 1 \
            else 'neutral'
Мы можем использовать обученную модель для получения результата логического вывода для пары предложений, являющихся примером.
predict_snli(net, vocab, ['he', 'is', 'good', '.'], ['he', 'is', 'bad', '.'])
16.5.3. Резюме
Модель внимания с декомпозицией состоит из трёх шагов для предсказания логических отношений между посылками и гипотезами: внимание, сравнение и агрегация.
Благодаря механизмам внимания мы можем сопоставлять каждый токен одной текстовой последовательности каждому токену другой и наоборот. Такое сопоставление является мягким и реализуется с помощью взвешенного среднего, где в идеале большие веса присваиваются токенам, которые должны быть сопоставлены.
Приём декомпозиции обеспечивает более предпочтительную линейную сложность по сравнению с квадратичной при вычислении весов внимания.
Мы можем использовать предварительно обученные векторные представления слов в качестве входного представления для задач обработки естественного языка, таких как естественный языковой вывод.
16.5.4. Упражнения
Обучите модель с другими комбинациями гиперпараметров. Удается ли получить более высокую точность на тестовой выборке?
Каковы основные недостатки модели декомпозируемого внимания для задачи вывода на естественном языке?
Предположим, что мы хотим получить уровень семантического сходства (например, непрерывное значение от 0 до 1) для любой пары предложений. Как следует собрать и разметить набор данных? Можете ли вы спроектировать модель с механизмами внимания?