
11.6. Самовнимание и позиционное кодирование
В глубоком обучении мы часто используем свёрточные нейронные сети (CNN) или рекуррентные нейронные сети (RNN) для кодирования последовательностей. Теперь, имея в виду механизмы внимания, представьте, что мы подаем последовательность токенов в механизм внимания таким образом, чтобы на каждом шаге каждый токен имел свой собственный запрос, ключи и значения. Здесь, при вычислении представления токена на следующем слое, токен может обращать внимание (через свой вектор запроса) на любой другой токен (сопоставление происходит на основе их векторов ключей). Используя полный набор показателей совместимости запрос-ключ, мы можем вычислить для каждого токена его представление, построив соответствующую взвешенную сумму по другим токенам. Поскольку каждый токен обращает внимание на каждый другой токен (в отличие от случая, когда шаги декодировщика обращают внимание на шаги кодировщика), такие архитектуры обычно описываются как модели самовнимания (Lin et al., 2017, Vaswani et al., 2017), а в других источниках — как модель внутреннего внимания (Cheng et al., 2016, Parikh et al., 2016, Paulus et al., 2017). В этом разделе мы обсудим кодирование последовательностей с использованием самовнимания, включая использование дополнительной информации для определения порядка элементов в последовательности.
import math
import torch
from torch import nn
from d2l import torch as d2l
11.6.1. Самовнимание
Рассмотрим последовательность входных токенов \(\mathbf{x}_1, \ldots, \mathbf{x}_n\), где любой \(\mathbf{x}_i \in \mathbb{R}^d\) (\(1 \leq i \leq n\)). Её механизм самов внимания формирует последовательность той же длины \(\mathbf{y}_1, \ldots, \mathbf{y}_n\), где
согласно определению агрегирования по вниманию в (11.1.1). Используя многоголовое внимание, следующий фрагмент кода вычисляет самовнимание для тензора с формой (размер батча, количество временных шагов или длина последовательности в токенах, \(d\)). Выходной тензор имеет ту же форму.
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_heads, 0.5)
batch_size, num_queries, valid_lens = 2, 4, torch.tensor([3, 2])
X = torch.ones((batch_size, num_queries, num_hiddens))
d2l.check_shape(attention(X, X, X, valid_lens),
                (batch_size, num_queries, num_hiddens))
11.6.2. Сравнение CNN, RNN и самовнимания
Рассмотрим архитектуры, отображающие последовательность \(n\) токенов в другую последовательность той же длины, где каждый входной или выходной токен представлен вектором размерности \(d\). В частности, мы рассмотрим свёрточные нейронные сети (CNN), рекуррентные нейронные сети (RNN) и самовнимание. Мы сравним их вычислительную сложность, наличие последовательных операций и максимальную длину путей. Обратите внимание, что последовательные операции препятствуют параллельным вычислениям, а более короткий путь между любыми позициями в последовательности облегчает обучение зависимости на больших расстояниях внутри последовательности (Hochreiter et al., 2001).
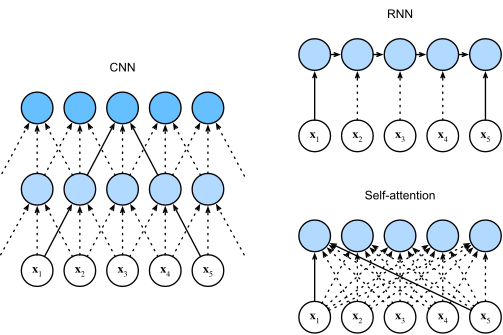
Fig. 11.6.1 Сравнение архитектур CNN (токены дополнения опущены), RNN и самовнимания.
Let’s regard any text sequence as a “one-dimensional image”. Similarly, one-dimensional CNNs can process local features such as \(n\)-grams in text. Given a sequence of length \(n\), consider a convolutional layer whose kernel size is \(k\), and whose numbers of input and output channels are both \(d\). The computational complexity of the convolutional layer is \(\mathcal{O}(knd^2)\). As Fig. 11.6.1 shows, CNNs are hierarchical, so there are \(\mathcal{O}(1)\) sequential operations and the maximum path length is \(\mathcal{O}(n/k)\). For example, \(\mathbf{x}_1\) and \(\mathbf{x}_5\) are within the receptive field of a two-layer CNN with kernel size 3 in Fig. 11.6.1.
При обновлении скрытого состояния RNN умножение матрицы весов \(d \times d\) на скрытое состояние размерности \(d\) имеет вычислительную сложность \(\mathcal{O}(d^2)\). Поскольку длина последовательности равна \(n\), вычислительная сложность рекуррентного слоя составляет \(\mathcal{O}(nd^2)\). Согласно Fig. 11.6.1, существует \(\mathcal{O}(n)\) последовательных операций, которые невозможно распараллелить, а максимальная длина пути также равна \(\mathcal{O}(n)\).
В механизме самов внимания запросы, ключи и значения представляют собой \(n \times d\) матрицы. Рассмотрим масштабированное внимание на основе скалярного произведения в (11.3.6), где \(n \times d\) матрица умножается на \(d \times n\) матрицу, а затем выходная \(n \times n\) матрица умножается на \(n \times d\) матрицу. В результате самовнимание имеет вычислительную сложность \(\mathcal{O}(n^2d)\). Как видно из Fig. 11.6.1, каждый токен напрямую связан с любым другим токеном через механизм самов внимания. Следовательно, вычисления могут выполняться параллельно без \(\mathcal{O}(1)\) последовательных операций, а максимальная длина пути также равна \(\mathcal{O}(1)\).
В целом, как свёрточные нейронные сети, так и самовнимание позволяют выполнять параллельные вычисления, при этом самовнимание обладает наименьшей максимальной длиной пути. Однако квадратичная вычислительная сложность относительно длины последовательности делает самовнимание неприемлемо медленным для очень длинных последовательностей.
11.6.3. Позиционное кодирование
В отличие от рекуррентных нейронных сетей, которые последовательно обрабатывают токены последовательности один за другим, самовнимание отказывается от последовательных операций в пользу параллельных вычислений. Обратите внимание, что само по себе самовнимание не сохраняет порядок последовательности. Что делать, если действительно важно, чтобы модель знала, в каком порядке поступила входная последовательность?
Доминирующий подход к сохранению информации о порядке следования токенов заключается в представлении этой информации модели в виде дополнительного входа, связанного с каждым токеном. Такие входы называются позиционными кодировками, и они могут быть либо обучаемыми, либо фиксированными априори. Ниже мы опишем простую схему для фиксированных позиционных кодировок, основанную на синусоидальных и косинусоидальных функциях (Vaswani et al., 2017).
Предположим, что входное представление \(\mathbf{X} \in \mathbb{R}^{n \times d}\) содержит эмбеддинги размерности \(d\) для \(n\) токенов последовательности. Позиционное кодирование выдает матрицу \(\mathbf{X} + \mathbf{P}\) с помощью матрицы позиционных эмбеддингов \(\mathbf{P} \in \mathbb{R}^{n \times d}\) той же формы, элемент которой в строке \(i^\textrm{th}\) и столбце \((2j)^\textrm{th}\) или столбце \((2j + 1)^\textrm{th}\) равен
На первый взгляд, такой дизайн на основе тригонометрических функций
выглядит странно. Прежде чем мы дадим объяснение этому решению, давайте
сначала реализуем его в следующем PositionalEncoding классе.
class PositionalEncoding(nn.Module):  #@save
    """Positional encoding."""
    def __init__(self, num_hiddens, dropout, max_len=1000):
        super().__init__()
        self.dropout = nn.Dropout(dropout)
        # Create a long enough P
        self.P = torch.zeros((1, max_len, num_hiddens))
        X = torch.arange(max_len, dtype=torch.float32).reshape(
            -1, 1) / torch.pow(10000, torch.arange(
            0, num_hiddens, 2, dtype=torch.float32) / num_hiddens)
        self.P[:, :, 0::2] = torch.sin(X)
        self.P[:, :, 1::2] = torch.cos(X)

    def forward(self, X):
        X = X + self.P[:, :X.shape[1], :].to(X.device)
        return self.dropout(X)
В матрице эмбеддингов позиций \(\mathbf{P}\) строки соответствуют позициям внутри последовательности, а столбцы представляют различные измерения позиционного кодирования. В приведённом ниже примере видно, что столбцы \(6^{\textrm{th}}\) и \(7^{\textrm{th}}\) матрицы эмбеддингов позиций имеют более высокую частоту, чем столбцы \(8^{\textrm{th}}\) и \(9^{\textrm{th}}\). Смещение между столбцами \(6^{\textrm{th}}\) и \(7^{\textrm{th}}\) (так же как и между \(8^{\textrm{th}}\) и \(9^{\textrm{th}}\)) обусловлено чередованием синусоидальных и косинусоидальных функций.
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
X = pos_encoding(torch.zeros((1, num_steps, encoding_dim)))
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(torch.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
         figsize=(6, 2.5), legend=["Col %d" % d for d in torch.arange(6, 10)])
11.6.3.1. Абсолютная позиционная информация
Чтобы понять, как монотонно убывающая частота вдоль размерности кодирования связана с абсолютной позиционной информацией, выведем двоичные представления \(0, 1, \ldots, 7\). Как мы видим, младший бит, второй по значимости бит и третий по значимости бит меняются при каждом числе, через каждые два числа и через каждые четыре числа соответственно.
for i in range(8):
    print(f'{i} in binary is {i:>03b}')
В двоичных представлениях старшие биты имеют меньшую частоту, чем младшие. Аналогично, как показано на тепловой карте ниже, позиционное кодирование уменьшает частоты вдоль размерности кодирования с помощью тригонометрических функций. Поскольку выходные данные представляют собой числа с плавающей запятой, такие непрерывные представления более экономичны по объёму памяти, чем двоичные.
P = P[0, :, :].unsqueeze(0).unsqueeze(0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
                  ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
11.6.3.2. Относительная позиционная информация
Помимо захвата абсолютной позиционной информации, приведённое выше позиционное кодирование также позволяет модели легко обучаться обращению внимания на основе относительных позиций. Это связано с тем, что для любого фиксированного смещения \(\delta\) позиционное кодирование в позиции \(i + \delta\) может быть представлено как линейное преобразование кодирования в позиции \(i\).
Эту проекцию можно объяснить математически. Обозначая \(\omega_j = 1/10000^{2j/d}\), любую пару \((p_{i, 2j}, p_{i, 2j+1})\) в (11.6.2) можно линейно спроецировать в \((p_{i+\delta, 2j}, p_{i+\delta, 2j+1})\) для любого фиксированного смещения \(\delta\):
где проекционная матрица \(2\times 2\) не зависит от какого-либо индекса позиции \(i\).
11.6.4. Итоги
В механизме самовнимание запросы, ключи и значения берутся из одного и того же источника. Как свёрточные нейронные сети, так и самовнимание позволяют осуществлять параллельные вычисления, при этом самовнимание обладает наименьшей максимальной длиной пути. Однако квадратичная вычислительная сложность по длине последовательности делает самовнимание слишком медленным для очень длинных последовательностей. Чтобы использовать информацию о порядке элементов в последовательности, мы можем внедрить абсолютную или относительную позиционную информацию, добавив позиционное кодирование к входным представлениям.
11.6.5. Упражнения
Предположим, что мы проектируем глубокую архитектуру для представления последовательности путем наложения слоёв самовнимания с позиционным кодированием. Какие могут возникнуть проблемы?
Можете ли вы разработать обучаемый метод позиционного кодирования?
Можно ли назначать различные обучаемые эмбеддинги в зависимости от смещения между запросами и ключами, которые сравниваются в механизме самовнимания? Подсказка: обратитесь к относительным позиционным эмбеддингам (Huang et al., 2018, Shaw et al., 2018).