
13.4. Аппаратное обеспечение
Создание систем с высокой производительностью требует хорошего понимания алгоритмов и моделей, позволяющего учесть статистические аспекты задачи. В то же время не менее важно обладать хотя бы минимальными знаниями об аппаратном обеспечении. Настоящий раздел не заменяет полноценного курса по аппаратному обеспечению и проектированию систем. Вместо этого он может служить отправной точкой для понимания того, почему одни алгоритмы эффективнее других, и как достичь хорошей пропускной способности. Грамотный дизайн может легко дать прирост на порядок, что, в свою очередь, может стать решающим фактором: например, обучение сети займет неделю, а не три месяца, что позволит уложиться в сроки. Мы начнем с обзора компьютеров. Затем мы детально рассмотрим процессоры (CPU) и графические процессоры (GPU). Наконец, мы вернемся к общему обзору и рассмотрим, как несколько компьютеров соединяются в серверных центрах или в облаке.
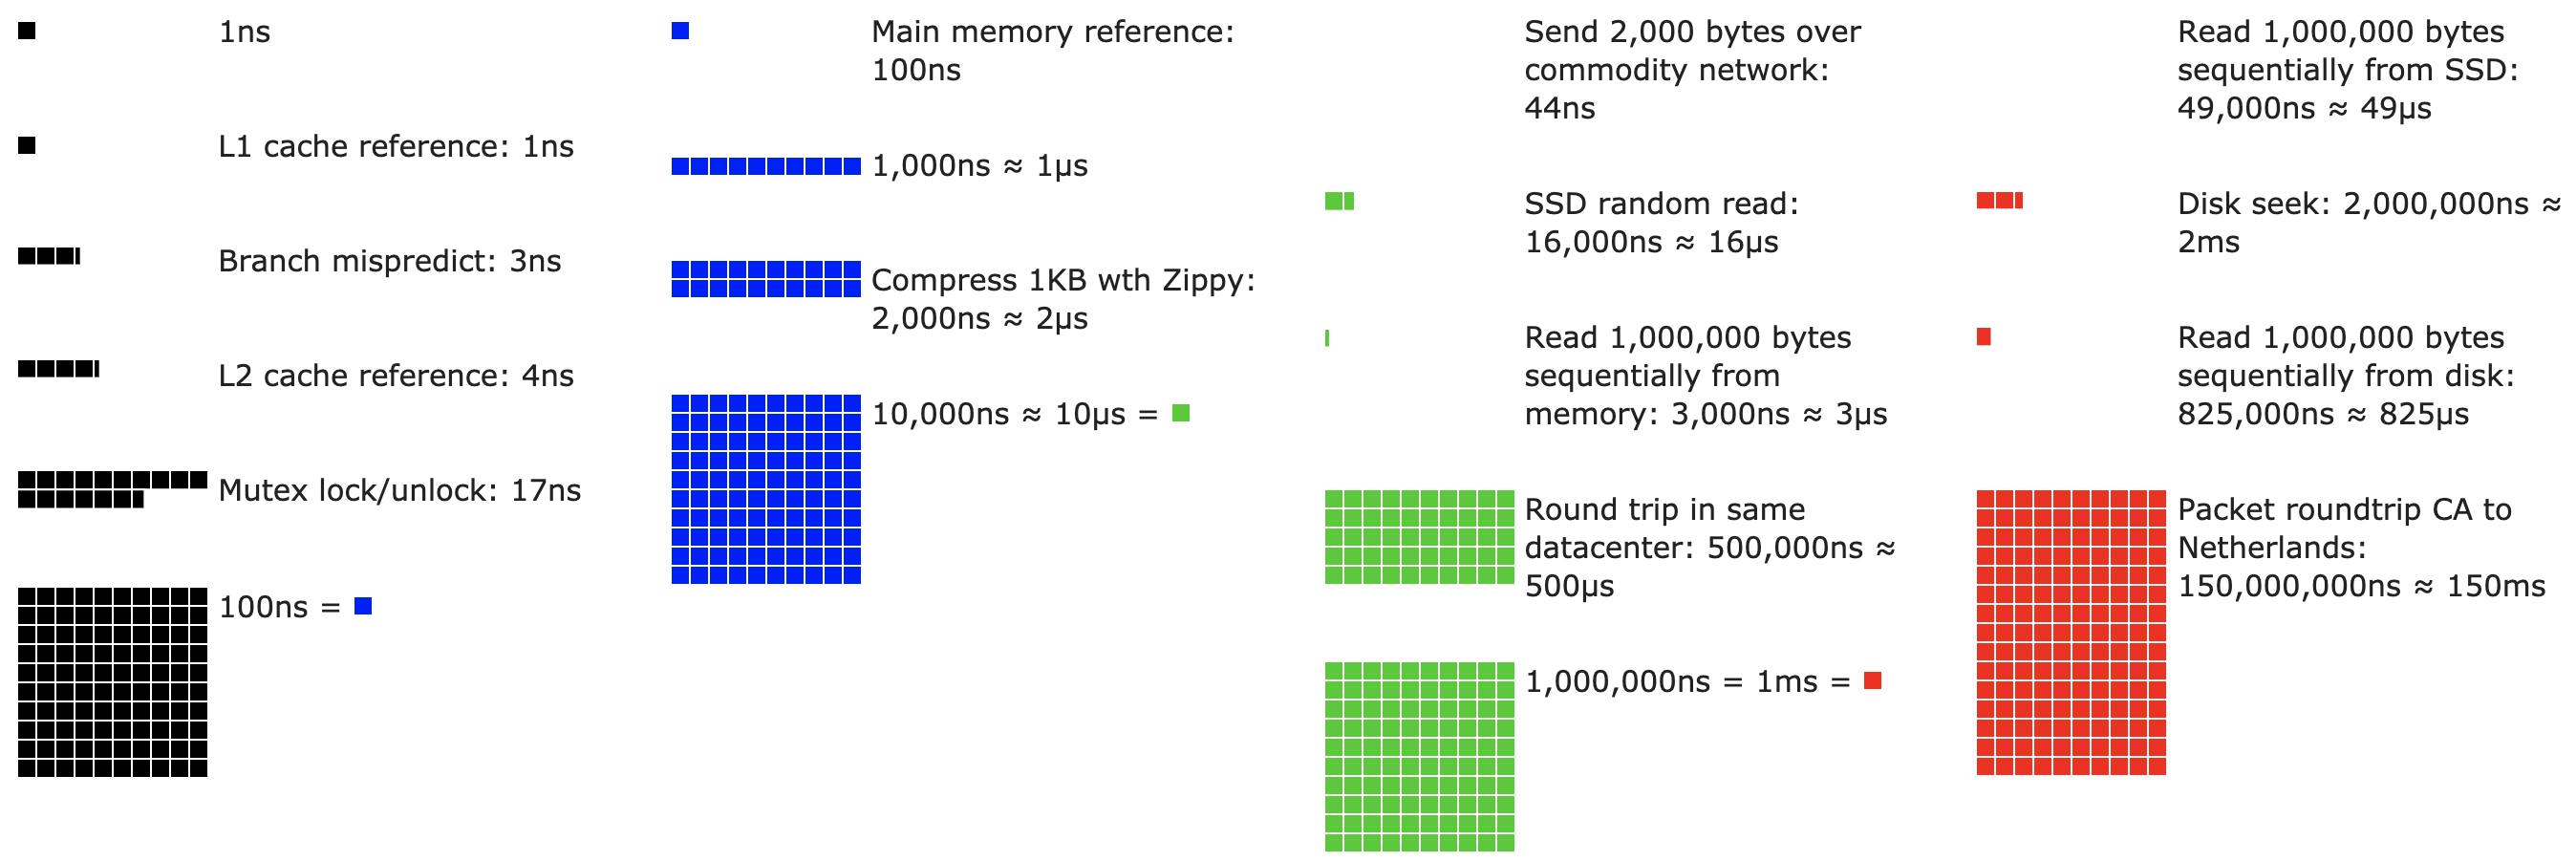
Fig. 13.4.1 Числа задержек, которые должен знать каждый программист.
Нетерпеливые читатели могут ограничиться материалом Fig. 13.4.1. Он основан на интерактивном посте Колена Скотта [https://people.eecs.berkeley.edu/%7Ercs/research/interactive_latency.html], который дает хорошее представление о прогрессе за последнее десятилетие. Исходные данные были представлены в докладе Джефа Дина [https://static.googleusercontent.com/media/research.google.com/en//people/jeff/Stanford-DL-Nov-2010.pdf], прочитанном в Стэнфорде в 2010 году. Ниже мы объясним логику, лежащую в основе этих данных, и то, как они могут помочь нам при разработке алгоритмов. Данное обсуждение носит очень общий и краткий характер. Оно явно не заменяет полноценный курс, а предназначено лишь для того, чтобы предоставить специалисту по статистическому моделированию достаточно информации для принятия обоснованных проектных решений. Для получения подробного обзора архитектуры компьютеров мы отсылаем читателя к работе (Hennessy and Patterson, 2011) или к недавнему курсу по данной теме, например, лекциям Арте Асаноуича.
13.4.1. Компьютеры
Большинство исследователей и практиков в области глубокого обучения имеют доступ к компьютеру с достаточным объёмом памяти, вычислительными мощностями и хотя бы одним ускорителем, таким как GPU, или несколькими такими устройствами. Компьютер состоит из следующих ключевых компонентов:
Процессор (также называемый ЦП), способный выполнять предоставляемые ему программы (а также обеспечивать работу операционной системы и множества других задач), обычно состоит из 8 и более ядер.
Память (ОЗУ) для хранения и извлечения результатов вычислений, таких как векторы весов и активации, а также обучающих данных.
Сетевое подключение Ethernet (иногда несколько) со скоростями от 1 Гбит/с до 100 Гбит/с. На высокопроизводительных серверах могут использоваться более продвинутые технологии межсоединений.
Шина расширения с высокой пропускной способностью (PCIe) для подключения системы к одному или нескольким графическим процессорам (GPU). В серверах может быть установлено до 8 ускорителей, часто соединённых по сложной топологии, тогда как в настольных системах обычно используется 1 или 2 ускорителя, в зависимости от бюджета пользователя и мощности блока питания.
Накопители постоянной памяти, такие как магнитные жёсткие диски или твердотельные накопители, во многих случаях подключаются через шину PCIe. Они обеспечивают эффективную передачу данных для обучения в систему и хранение промежуточных контрольных точек по мере необходимости.
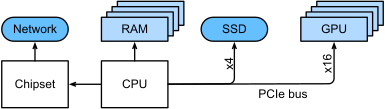
Fig. 13.4.2 Связность компонентов компьютера.
Как показано в Fig. 13.4.2, большинство компонентов (сеть, графический процессор и хранилище) подключены к центральному процессору через шину PCIe. Она состоит из нескольких линий, напрямую подключенных к центральному процессору. Например, в AMD Threadripper 3 имеется 64 линии PCIe 4.0, каждая из которых способна передавать данные со скоростью 16 Гбит/с в обоих направлениях. Память напрямую подключена к центральному процессору, обеспечивая общую пропускную способность до 100 ГБ/с.
Когда мы выполняем код на компьютере, нам необходимо пересылать данные в процессоры (ЦП или ГП), выполнять вычисления, а затем перемещать результаты из процессора обратно в оперативную память и долговременное хранилище. Следовательно, для обеспечения высокой производительности необходимо, чтобы этот процесс работал бесперебойно, и ни один из компонентов не становился существенным узким местом. Например, если мы не можем достаточно быстро загружать данные, процессору нечем будет заниматься. Аналогично, если мы не можем достаточно быстро передавать матрицы на ЦП (или ГП), его вычислительные элементы будут простаивать. Наконец, если мы хотим синхронизировать работу нескольких компьютеров через сеть, сеть не должна замедлять вычисления. Один из вариантов решения этой задачи — чередовать операции связи и вычислений. Давайте рассмотрим различные компоненты более подробно.
13.4.2. Память
В самом простом случае память используется для хранения данных, к которым необходим быстрый доступ. В настоящее время оперативная память процессоров (CPU) обычно представляет собой модули стандарта DDR4, обеспечивающие пропускную способность 20–25 ГБ/с на каждый объект. Каждый объект имеет шину шириной 64 бита. Как правило, используются пары объектов памяти для организации нескольких каналов. Процессоры имеют от 2 до 4 каналов памяти, то есть их пиковая пропускная способность памяти составляет от 40 ГБ/с до 100 ГБ/с. Часто на каждый канал приходится два банка. Например, в процессоре AMD Zen 3 Threadripper предусмотрено 8 слотов.
Хотя эти цифры впечатляют, они рассказывают лишь часть истории. Когда мы хотим прочитать часть данных из памяти, нам сначала нужно указать модулю памяти, где находится эта информация. То есть мы должны сначала отправить адрес в оперативную память. После этого мы можем выбрать чтение либо одной 64-битной записи, либо длинной последовательности записей. Последнее называется пакетным чтением. Если говорить кратко, отправка адреса в память и настройка передачи занимают примерно 100 нс (точные значения зависят от конкретных временных параметров используемых чипов памяти), тогда как каждая последующая передача занимает всего 0,2 нс. Иными словами, первое чтение в 500 раз дороже последующих! Обратите внимание, что мы можем выполнять до 10 000 000 случайных чтений в секунду. Это означает, что следует по возможности избегать случайного доступа к памяти и вместо этого использовать пакетные чтения (и записи).
Вопрос усложняется, если учесть наличие нескольких банков. Каждый банк может осуществлять чтение из памяти практически независимо. Это означает два момента. Во-первых, эффективное количество случайных чтений может быть в 4 раза выше при условии их равномерного распределения по памяти. Во-вторых, случайные чтения по-прежнему неэффективны, поскольку пакетные чтения (burst reads) также в 4 раза быстрее. В-третьих, из-за выравнивания памяти по 64-битным границам целесообразно выравнивать любые структуры данных по тем же границам. Компиляторы делают это практически автоматически, если установлены соответствующие флаги. Любознательным читателям рекомендуется ознакомиться с лекцией о DRAM, например, лекцией Зешана Чисшти.
Память GPU предъявляет ещё более высокие требования к пропускной способности, поскольку в ней содержится гораздо больше вычислительных элементов, чем в процессорах. В целом существует два подхода к решению этой задачи. Первый заключается в значительном увеличении ширины шины памяти. Например, видеокарта NVIDIA RTX 2080 Ti имеет шину шириной 352 бита. Это позволяет передавать значительно больше данных одновременно. Второй подход заключается в использовании специализированной памяти высокой производительности. Устройства потребительского класса, такие как серии NVIDIA RTX и Titan, как правило, используют чипы GDDR6 с совокупной пропускной способностью более 500 ГБ/с. Альтернативой является использование модулей HBM (High Bandwidth Memory). Они используют совершенно другой интерфейс и подключаются непосредственно к GPU на выделенном кремниевом кристалле. Это делает их очень дорогими, поэтому их применение обычно ограничивается высокопроизводительными серверными чипами, такими как серия ускорителей NVIDIA Volta V100. Ничего удивительного в том, что память GPU в целом намного меньше, чем память CPU, из-за более высокой стоимости первой. Для наших целей их характеристики производительности в целом схожи, просто они значительно быстрее. Мы можем смело игнорировать эти детали в рамках этой книги. Они имеют значение только при оптимизации ядер GPU для достижения высокой пропускной способности.
13.4.3. Хранилище
Мы видели, что некоторые из ключевых характеристик оперативной памяти — это пропускная способность и задержка. То же самое верно и для устройств хранения данных, только различия могут быть ещё более выраженными.
13.4.3.1. Жёсткие диски
Жёсткие диски (HDD) используются уже более полувека. Если говорить кратко, они содержат несколько вращающихся пластин с головками, которые могут позиционироваться для чтения или записи на любой заданной дорожке. Диски высокого класса могут хранить до 16 ТБ данных на 9 пластинах. Одним из ключевых преимуществ HDD является их относительно низкая стоимость. Одним из многих недостатков являются их типичные катастрофические режимы отказов и относительно высокая задержка чтения.
Чтобы понять это, рассмотрим тот факт, что жёсткие диски вращаются со скоростью около 7200 об/мин (оборотов в минуту). Если бы они вращались значительно быстрее, они бы разрушились из-за центробежной силы, действующей на пластины. Это создает серьезные проблемы при доступе к определённому сектору диска: нам приходится ждать, пока пластина повернется в нужное положение (мы можем перемещать головки, но не можем ускорить сами диски). Следовательно, может потребоваться более 8 мс, прежде чем запрошенные данные станут доступны. Обычно это выражают тем, что жёсткие диски могут выполнять примерно 100 операций ввода-вывода в секунду (IOPS). Это значение практически не менялось на протяжении последних двух десятилетий. Хуже того, так же сложно увеличить пропускную способность (она составляет порядка 100–200 МБ/с). В конце концов, каждая головка считывает дорожку битов, поэтому скорость передачи данных увеличивается пропорционально квадратному корню из плотности информации. В результате жёсткие диски постепенно вытесняются в область архивного хранения и использования для хранения очень больших наборов данных низкого качества.
13.4.3.2. Накопители на твердотельных накопителях
Твердотельные накопители (SSD) используют флэш-память для постоянного хранения информации. Это обеспечивает значительно более быстрый доступ к хранимым данным. Современные SSD могут работать со скоростью от 100 000 до 500 000 операций ввода-вывода в секунду (IOPS), то есть до трёх порядков быстрее, чем жёсткие диски (HDD). Кроме того, их пропускная способность может достигать 1–3 ГБ/с, что на порядок выше, чем у HDD. Эти улучшения кажутся почти слишком хорошими, чтобы быть правдой. Однако они имеют следующие ограничения, обусловленные архитектурой SSD.
SSD хранят информацию блоками (256 КБ и более). Запись в них возможна только целиком, что занимает значительное время. В результате побитовые случайные записи на SSD демонстрируют крайне низкую производительность. Аналогичным образом, общая запись данных требует много времени, поскольку блок необходимо сначала прочитать, стереть, а затем перезаписать новыми данными. К настоящему времени контроллеры и прошивка SSD разработали алгоритмы, позволяющие смягчить эту проблему. Тем не менее, операции записи могут выполняться значительно медленнее, особенно для SSD с технологией QLC (quad level cell). Ключом к повышению производительности является поддержание очереди операций, предпочтение операциям чтения и запись большими блоками, если это возможно.
Ячейки памяти в SSD изнашиваются довольно быстро (часто уже после нескольких тысяч операций записи). Алгоритмы выравнивания износа позволяют распределить деградацию по множеству ячеек. Тем не менее не рекомендуется использовать SSD для файлов подкачки или для хранения больших объёмов журнальных файлов.
Наконец, значительный рост пропускной способности вынудил разработчиков компьютеров подключать SSD напрямую к шине PCIe. Диски, способные работать с такой скоростью, называются NVMe (Non-Volatile Memory Express), и они могут использовать до 4 линий PCIe. Это обеспечивает пропускную способность до 8 ГБ/с на PCIe 4.0.
13.4.3.3. Облачное хранилище
Облачное хранилище обеспечивает настраиваемый уровень производительности. Это означает, что выделение хранилища виртуальным машинам является динамическим как по объёму, так и по скорости, в соответствии с выбором пользователей. Мы рекомендуем пользователям увеличивать количество выделенных операций ввода-вывода в секунду (IOPS), когда задержка становится слишком высокой, например, во время обучения с множеством небольших записей.
13.4.4. ЦП
Центральные процессоры (CPUs) являются основой любого компьютера. Они состоят из нескольких ключевых компонентов: процессорных ядер, способных выполнять машинный код, шины, соединяющей их (конкретная топология значительно различается в зависимости от модели процессора, поколения и производителя), а также кэшей, обеспечивающих более высокую пропускную способность и меньшую задержку при доступе к памяти по сравнению с чтением из основной памяти. Наконец, почти все современные процессоры содержат векторные блоки обработки для ускорения высокопроизводительных операций линейной алгебры и свёрток, поскольку такие операции широко используются при обработке медиаданных и в машинном обучении.
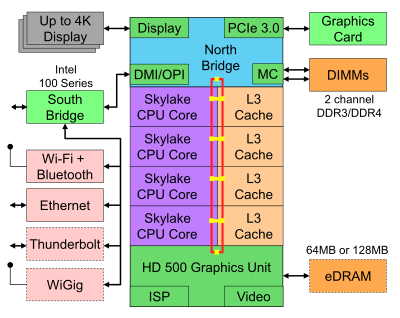
Fig. 13.4.3 Потребительский четырёхъядерный процессор Intel Skylake.
Fig. 13.4.3 изображает потребительский четырёхъядерный процессор Intel Skylake. Он содержит интегрированное графическое ядро, кэш-память и кольцевую шину, соединяющую четыре ядра. Периферийные устройства, такие как Ethernet, Wi-Fi, Bluetooth, контроллер SSD и USB, либо входят в состав чипсета, либо подключены напрямую к процессору (PCIe).
13.4.4.1. Микроархитектура
Каждое ядро процессора состоит из довольно сложного набора компонентов. Хотя детали различаются в зависимости от поколения и производителя, базовая функциональность в целом стандартизирована. Блок загрузки инструкций (front-end) загружает инструкции и пытается предсказать, какой путь будет выбран (например, для управления потоком выполнения). Затем инструкции декодируются из машинного кода в микроинструкции. Машинный код часто не является самым низкоуровневым кодом, который выполняет процессор. Вместо этого сложные инструкции могут декодироваться в набор более низкоуровневых операций. Затем эти операции обрабатываются самим ядром выполнения. Часто такое ядро способно выполнять множество операций одновременно. Например, ядро ARM Cortex A77 из Fig. 13.4.4 способно выполнять до 8 операций одновременно.
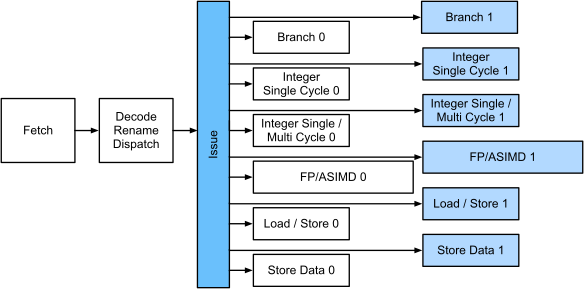
Fig. 13.4.4 Микроархитектура ARM Cortex A77.
Это означает, что эффективные программы могут выполнять более одной инструкции за такт, при условии что эти инструкции могут выполняться независимо. Не все блоки процессора одинаковы. Некоторые специализируются на целочисленных инструкциях, тогда как другие оптимизированы для вычислений с плавающей запятой. Для увеличения пропускной способности процессор может также одновременно выполнять несколько ветвей кода в инструкциях условного перехода, а затем отбрасывать результаты тех ветвей, которые не были выполнены. Именно поэтому важны блоки предсказания переходов (на этапе фронтенда), чтобы отслеживались только наиболее перспективные пути выполнения.
13.4.4.2. Векторизация
Глубокое обучение крайне требовательно к вычислительным ресурсам. Поэтому, чтобы сделать процессоры (CPU) пригодными для машинного обучения, необходимо выполнять множество операций за один такт. Это достигается с помощью векторных блоков. Они имеют разные названия: на ARM они называются NEON, а на x86 (в последних поколениях) — AVX2. Общим для них является то, что они способны выполнять операции SIMD (одна инструкция — несколько данных). Fig. 13.4.5 показывает, как можно сложить 8 коротких целых чисел за один такт на ARM.
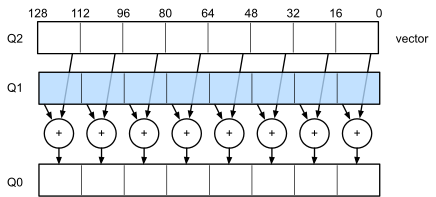
Fig. 13.4.5 128-битная векторизация NEON.
В зависимости от архитектурных решений такие регистры могут достигать длины 512 бит, что позволяет объединять до 64 пар чисел. Например, мы можем умножать два числа и прибавлять результат к третьему; эта операция также известна как слитое умножение-сложение. Intel использует OpenVino для достижения приёмлемой пропускной способности при глубоком обучении на серверных процессорах. Однако стоит отметить, что эта цифра совершенно не идет ни в какое сравнение с тем, что способны обеспечить графические процессоры. Например, в NVIDIA RTX 2080 Ti имеется 4352 ядра CUDA, каждое из которых способно выполнять такую операцию в любой момент времени.
13.4.4.3. Кэш
Рассмотрим следующую ситуацию: у нас есть процессор с четырьмя ядрами, как показано на рисунке Fig. 13.4.3, работающий на частоте 2 ГГц. Предположим также, что количество инструкций за такт (IPC) равно 1 и что ядра поддерживают AVX2 с шириной 256 бит. Допустим далее, что по крайней мере один из регистров, используемых для операций AVX2, должен быть загружен из памяти. Это означает, что процессор потребляет \(4 \times 256 \textrm{ bit} = 128 \textrm{ bytes}\) данных за такт. Если мы не сможем передавать \(2 \times 10^9 \times 128 = 256 \times 10^9\) байт процессору в секунду, вычислительные элементы будут страдать от голода. К сожалению, интерфейс памяти такого чипа поддерживает передачу данных на уровне 20–40 ГБ/с, то есть на порядок меньше. Решение заключается в том, чтобы по возможности избегать загрузки новых данных из памяти и кэшировать их локально на процессоре. Здесь и пригодятся кэши. Обычно используются следующие названия или концепции:
Регистры строго говоря не являются частью кэша. Они служат для подготовки инструкций. Тем не менее регистры процессора — это ячейки памяти, к которым ЦП может обращаться на тактовой частоте без задержек. В процессорах имеется десятки регистров. Эффективное использование регистров зависит от компилятора (или программиста). Например, в языке программирования C есть ключевое слово
register.Кэш-память L1 — это первый рубеж защиты от высоких требований к пропускной способности памяти. Кэш-память L1 имеет небольшой объём (обычно 32–64 КБ) и часто разделяется на кэш данных и кэш инструкций. Если данные находятся в кэше L1, доступ к ним осуществляется очень быстро. В случае их отсутствия поиск продолжается в следующей ступени иерархии кэш-памяти.
Кэш-память L2 — это следующий уровень. В зависимости от архитектуры и размера процессора она может быть эксклюзивной. Кэш-память L2 может быть доступна только одному ядру или разделяться между несколькими ядрами. Кэш-память L2 больше по объёму (обычно 256–512 КБ на ядро) и медленнее, чем L1. Кроме того, для доступа к данным в L2 необходимо сначала убедиться, что этих данных нет в L1, что добавляет небольшую дополнительную задержку.
Кэш третьего уровня (L3) разделяется между несколькими ядрами и может быть довольно большим. Серверные процессоры AMD Epyc 3-й серии имеют внушительный объём кэша в 256 МБ, распределённый по нескольким чиплетам. Более типичные значения находятся в диапазоне 4–8 МБ.
Предсказание того, какие элементы памяти понадобятся далее, является одним из ключевых параметров оптимизации при проектировании чипов. Например, рекомендуется обращаться к памяти в прямом порядке, поскольку большинство алгоритмов кэширования стремятся выполнять опережающее чтение, а не в обратном направлении. Аналогичным образом, локализация паттернов доступа к памяти — это эффективный способ повышения производительности.
Добавление кэшей — это палка о двух концах. С одной стороны, они гарантируют, что ядра процессора не останутся без данных. С другой стороны, они увеличивают площадь кристалла, занимая место, которое иначе можно было бы использовать для повышения вычислительной мощности. Кроме того, промахи кэша могут быть дорогостоящими. Рассмотрим худший сценарий — ложное разделение, показанное на рисунке Fig. 13.4.6. Ячейка памяти кэшируется на процессоре 0, когда поток на процессоре 1 запрашивает эти данные. Чтобы получить доступ к ним, процессору 0 необходимо приостановить текущую работу, записать информацию обратно в основную память и позволить процессору 1 считать её оттуда. Во время этой операции оба процессора простаивают. Вполне вероятно, что такой код будет выполняться медленнее на нескольких процессорах по сравнению с эффективной реализацией для одного процессора. Это ещё одна причина, по которой существуют практические ограничения на размер кэша (помимо физических ограничений).
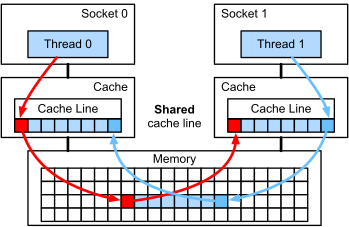
Fig. 13.4.6 Ложное разделение (изображение предоставлено Intel).
13.4.5. Графические процессоры и другие ускорители
Утверждать, что глубокое обучение не стало бы успешным без графических процессоров (GPU), было бы преувеличением. В то же время вполне обосновано считать, что доходы производителей GPU значительно выросли благодаря глубокому обучению. Это взаимное развитие аппаратного обеспечения и алгоритмов привело к тому, что глубокое обучение стало предпочтительной парадигмой статистического моделирования, независимо от того, нравится это или нет. Поэтому стоит разобраться в конкретных преимуществах, которые предоставляют GPU и другие ускорители, такие как TPU (Jouppi et al., 2017).
Обратите внимание на важное практическое различие: ускорители оптимизируются либо для обучения, либо для вывода. Для вывода требуется вычислять только прямое распространение в сети. При этом не нужно хранить промежуточные данные для обратного распространения ошибки. Кроме того, вычисления могут не требовать высокой точности (обычно достаточно FP16 или INT8). С другой стороны, во время обучения необходимо сохранять все промежуточные результаты для вычисления градиентов. Кроме того, накопление градиентов требует более высокой точности, чтобы избежать численного переполнения или недополнения. Это означает, что минимальным требованием является FP16 (или смешанная точность с FP32). Всё это обуславливает необходимость в более быстрой и объёмной памяти (HBM2 против GDDR6) и большей вычислительной мощности. Например, видеокарты NVIDIA T4 на архитектуре Turing оптимизированы для вывода, тогда как для обучения предпочтительнее использовать видеокарты V100.
Вспомним векторизацию, проиллюстрированную на рис. Fig. 13.4.5. Добавление векторных блоков в ядро процессора позволило значительно увеличить пропускную способность. Например, в примере на рис. Fig. 13.4.5 мы смогли выполнить 16 операций одновременно. Во-первых, что если бы мы добавили операции, оптимизированные не только для работы с векторами, но и для работы с матрицами? Эта стратегия привела к появлению тензорных ядер (о них речь пойдет вскоре). Во-вторых, что если бы мы добавили гораздо больше ядер? Вкратце, эти две стратегии описывают основные решения при проектировании графических процессоров. На рис. Fig. 13.4.7 приведен обзор базового блока обработки. Он содержит 16 целочисленных и 16 блоков с плавающей запятой. Кроме того, два тензорных ядра ускоряют узкий подмножество дополнительных операций, важных для глубокого обучения. Каждый потоковый мультипроцессор состоит из четырёх таких блоков.
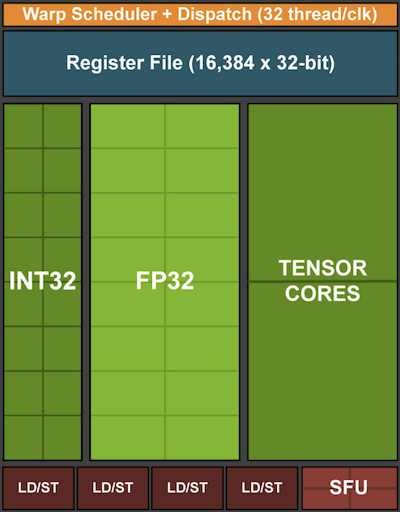
Fig. 13.4.7 Блок обработки NVIDIA Turing (изображение предоставлено NVIDIA).
Далее 12 потоковых мультипроцессоров объединяются в графические вычислительные кластеры, из которых состоят высокоуровневые процессоры TU102. Обилие каналов памяти и кэш-память второго уровня дополняют эту архитектуру. Fig. 13.4.8 содержит соответствующие детали. Одна из причин проектирования такого устройства заключается в том, что отдельные блоки можно добавлять или удалять по мере необходимости, что позволяет создавать более компактные чипы и решать проблемы с выходом годных изделий (неисправные модули могут не активироваться). К счастью, программирование таких устройств скрыто от рядового исследователя в области глубокого обучения за многослойным кодом CUDA и фреймворка. В частности, на графическом процессоре может одновременно выполняться более одной программы, при условии наличия доступных ресурсов. Тем не менее, полезно знать ограничения устройств, чтобы избегать выбора моделей, которые не помещаются в память устройства.
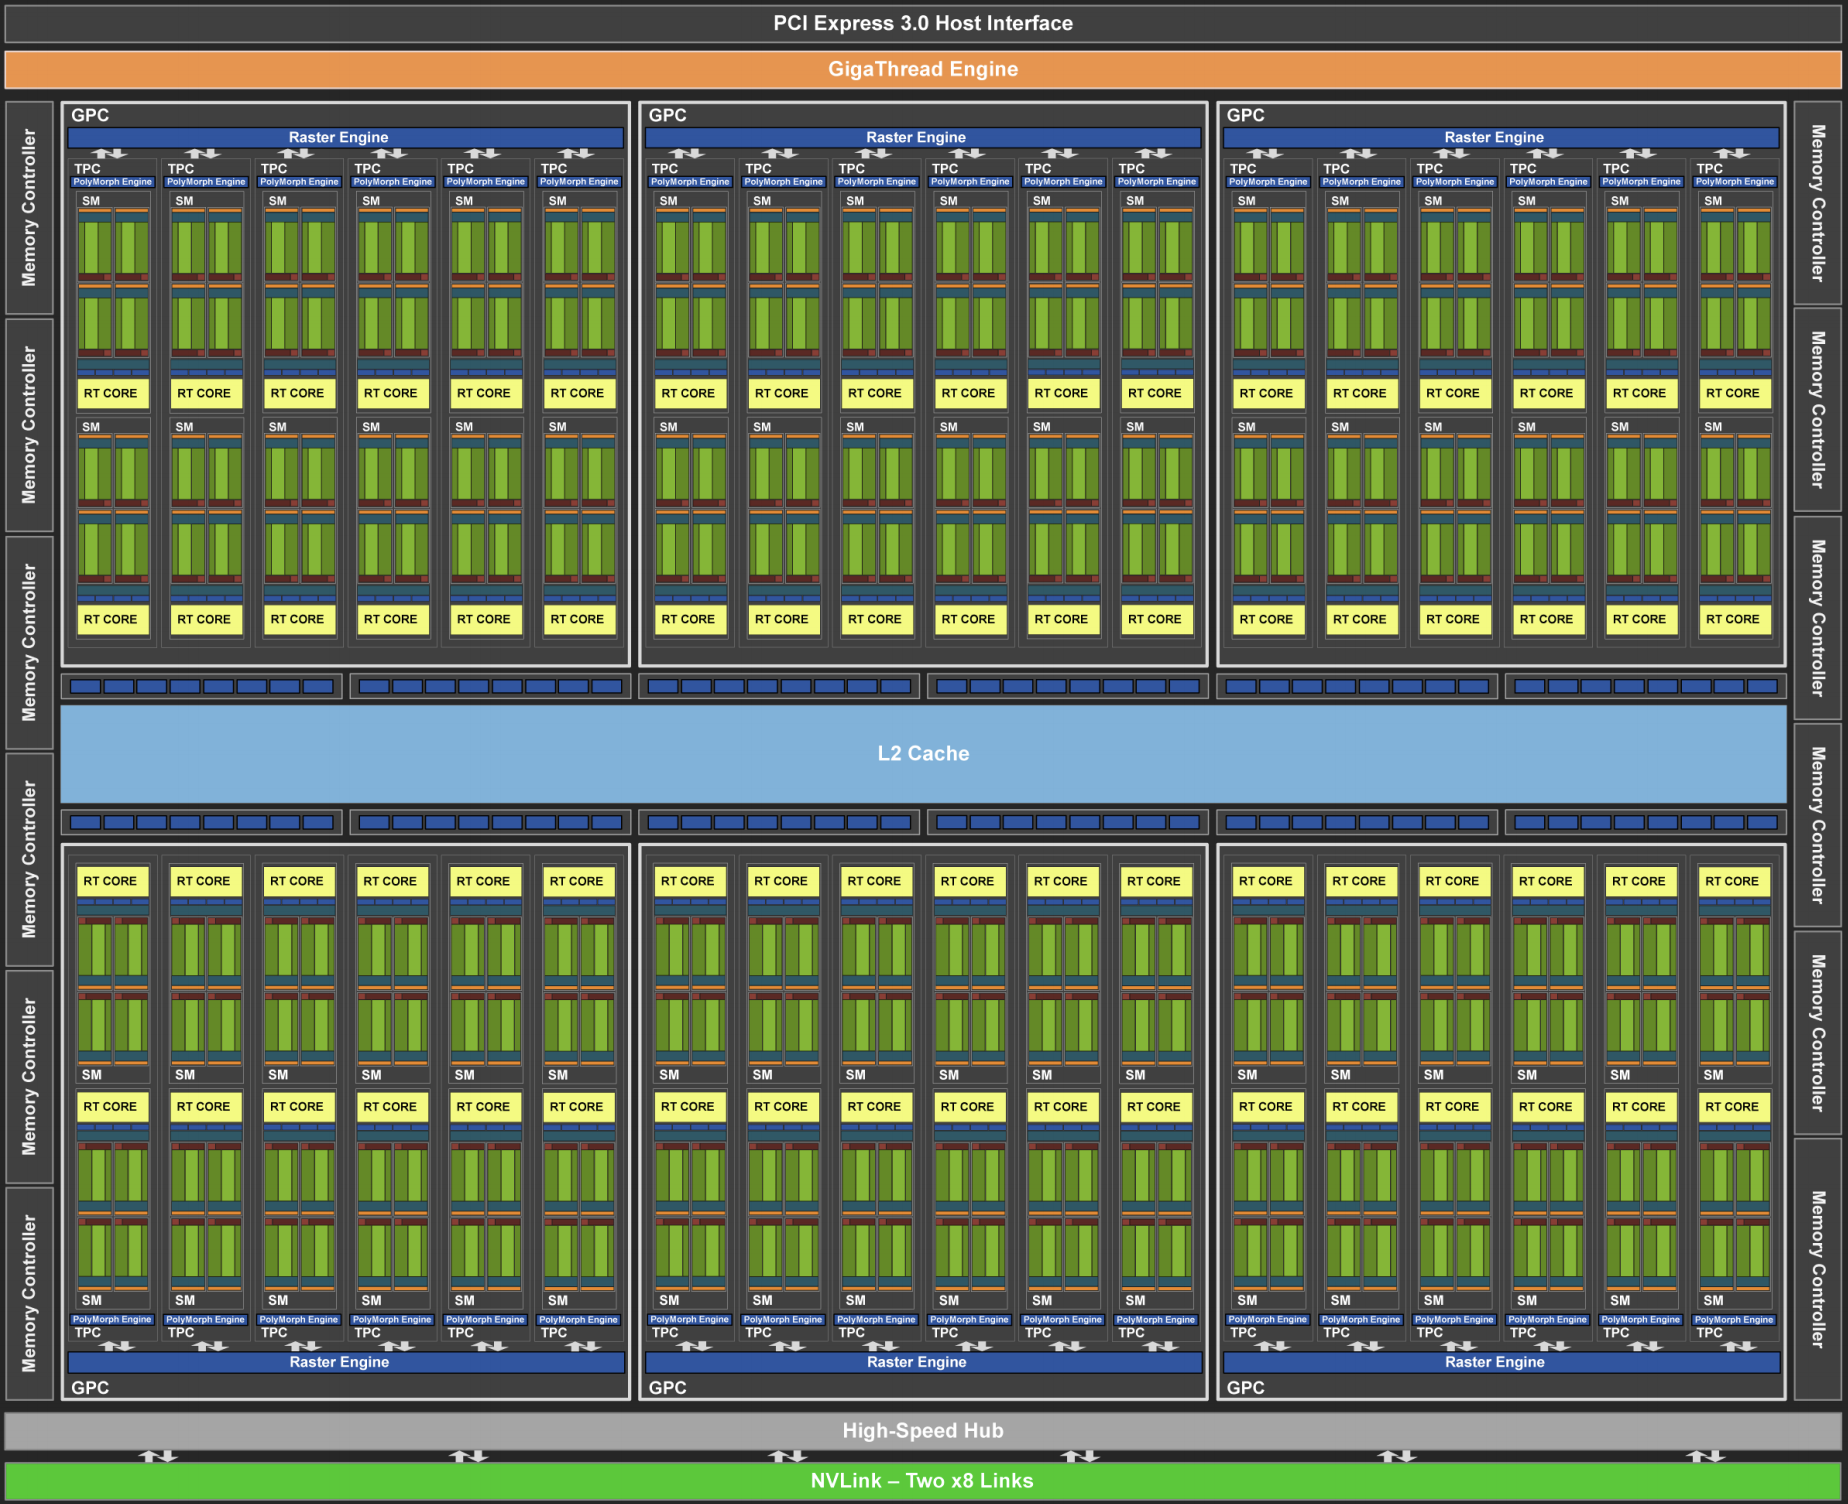
Fig. 13.4.8 Архитектура NVIDIA Turing (изображение предоставлено NVIDIA)
Последним аспектом, который стоит рассмотреть подробнее, являются тензорные ядра. Они представляют собой пример недавней тенденции добавлять более оптимизированные схемы, специально эффективные для глубокого обучения. Например, в TPU была добавлена систолическая матрица (Kung, 1988) для быстрого матричного умножения. Там архитектура была ориентирована на поддержку очень малого количества (одной для первого поколения TPU) крупных операций. Тензорные ядра находятся на другом конце спектра. Они оптимизированы для небольших операций, включающих от \(4 \times 4\) до \(16 \times 16\) матриц, в зависимости от их численной точности. Fig. 13.4.9 дает обзор этих оптимизаций.
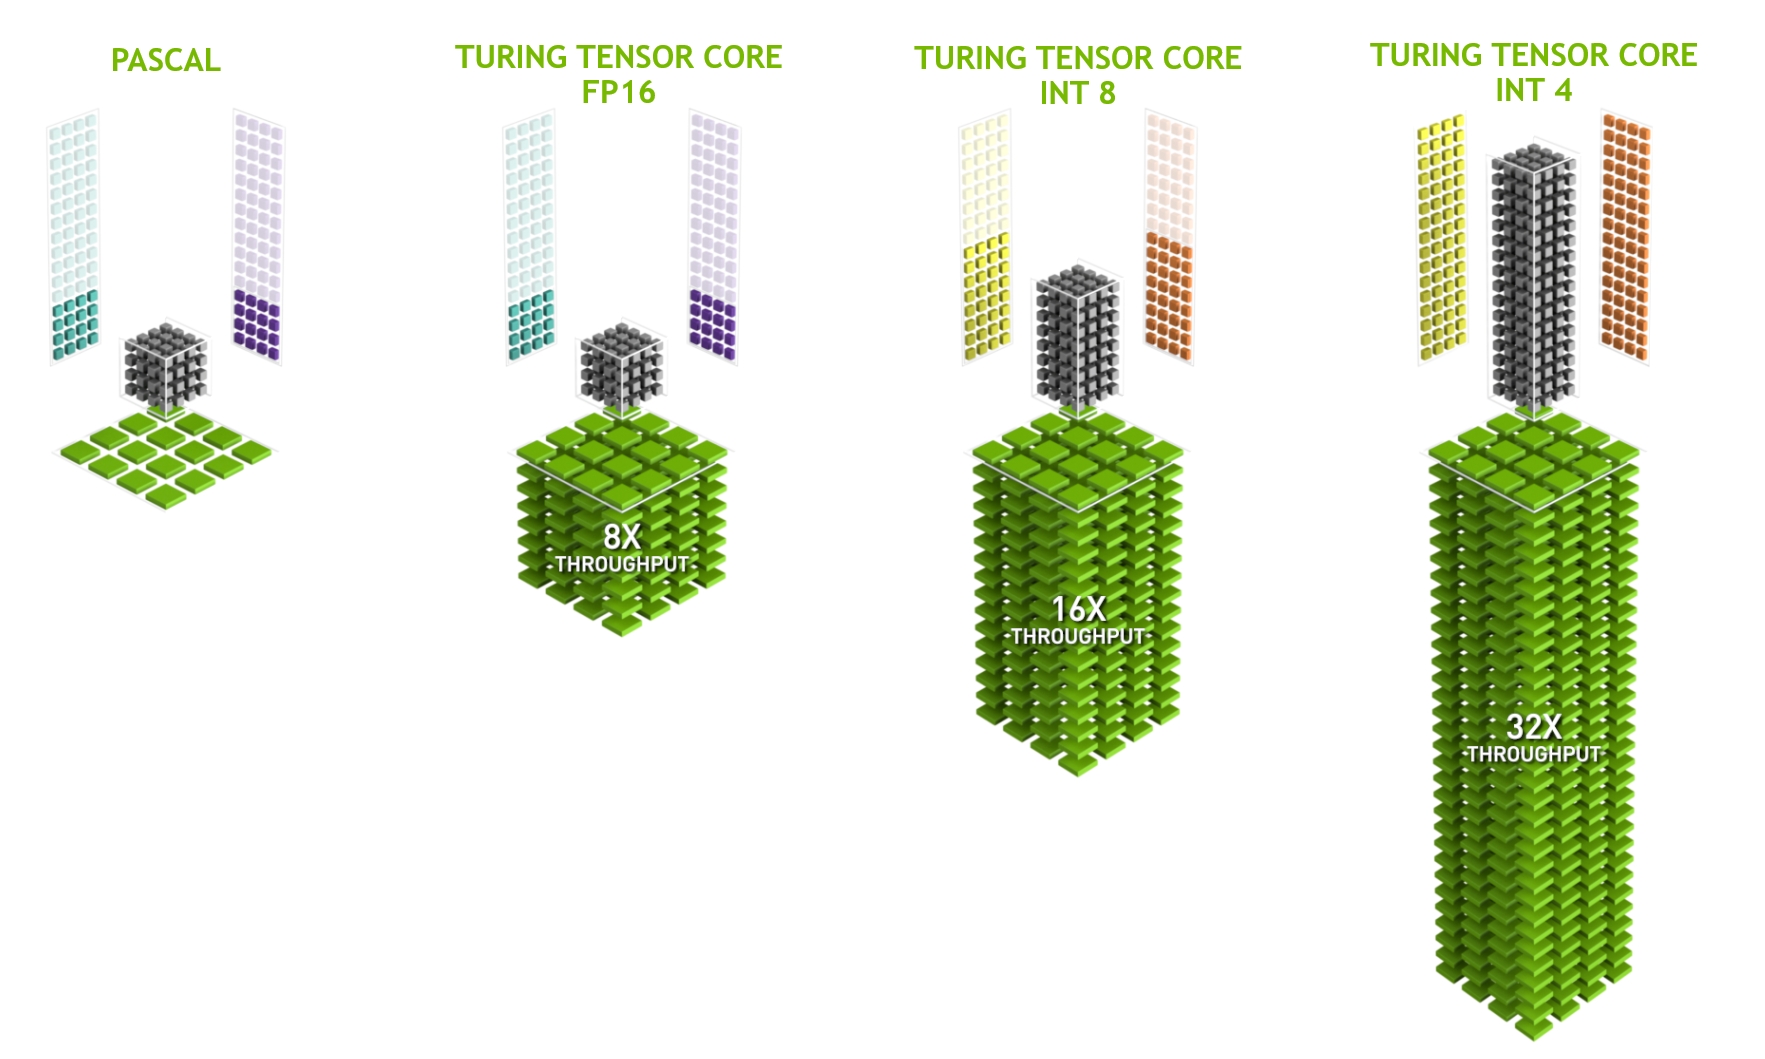
Fig. 13.4.9 Тензорные ядра NVIDIA в архитектуре Turing (изображение предоставлено NVIDIA).
Очевидно, оптимизируя вычисления, мы вынуждены идти на определённые компромиссы. Один из них заключается в том, что графические процессоры (GPU) не очень хорошо справляются с обработкой прерываний и разреженных данных. Несмотря на заметные исключения, такие как Gunrock (Wang et al., 2016), шаблоны доступа к разреженным матрицам и векторам плохо сочетаются с высокопропускными пакетными операциями чтения, в которых GPU преуспевают. Совмещение обеих целей является областью активных исследований. См., например, DGL — библиотеку, оптимизированную для глубокого обучения на графах.
13.4.6. Сети и шины
Когда одного устройства недостаточно для оптимизации, необходимо передавать данные туда и обратно для синхронизации вычислений. В этом случае на помощь приходят сети и шины. При проектировании учитываются несколько параметров: пропускная способность, стоимость, дальность связи и гибкость. С одной стороны, есть Wi-Fi: он обеспечивает хороший радиус действия, очень прост в использовании (ведь не требуется проводное подключение), дешев, но предлагает сравнительно посредственную пропускную способность и задержку. Ни один исследователь в области машинного обучения, находящийся в здравом уме, не стал бы использовать его для построения кластера серверов. В дальнейшем мы сосредоточимся на соединениях, подходящих для глубокого обучения.
PCIe — это выделенная шина для высокоскоростных точечных соединений (до 32 ГБ/с на линию в PCIe 4.0 в слоте с 16 линиями). Задержка составляет несколько микросекунд (5 мкс). Линии PCIe — ценный ресурс. У процессоров их количество ограничено: у AMD EPYC 3 доступно 128 линий, у Intel Xeon — до 48 линий на чип; у настольных процессоров эти цифры составляют 20 (Ryzen 9) и 16 (Core i9) соответственно. Поскольку видеокарты обычно имеют 16 линий, это ограничивает количество видеокарт, которые могут подключиться к процессору на полной пропускной способности. В конце концов, им приходится делить линии с другими устройствами с высокой пропускной способностью, такими как системы хранения данных и Ethernet. Как и при доступе к оперативной памяти, предпочтительны крупные пакеты данных из-за снижения накладных расходов.
Ethernet — наиболее распространённый способ соединения компьютеров. Хотя он значительно медленнее PCIe, его установка обходится дёшево и отличается надёжностью, а также позволяет передавать данные на гораздо большие расстояния. Типичная пропускная способность для серверов начального уровня составляет 1 Гбит/с. Устройства более высокого класса (например, объекты C5 в облаке) обеспечивают пропускную способность от 10 до 100 Гбит/с. Как и во всех предыдущих случаях, передача данных сопровождается значительными накладными расходами. Обратите внимание, что мы почти никогда не используем «голый» Ethernet напрямую, а применяем протокол, работающий поверх физического соединения (например, UDP или TCP/IP). Это добавляет дополнительные накладные расходы. Как и PCIe, Ethernet предназначен для соединения двух устройств, например, компьютера и коммутатора.
Коммутаторы позволяют подключать множество устройств таким образом, чтобы любая их пара могла одновременно устанавливать соединение точка-точка (как правило, на полную пропускную способность). Например, коммутаторы Ethernet могут соединять 40 серверов с высокой пропускной способностью коммутации. Обратите внимание, что коммутаторы не являются уникальными для традиционных компьютерных сетей. Даже линии PCIe могут быть переключены. Это происходит, например, для подключения большого количества графических процессоров к центральному процессору, как это реализовано в объектах P2.
NVLink — это альтернатива PCIe для высокоскоростных межсоединений. Он обеспечивает скорость передачи данных до 300 Гбит/с на одно соединение. Серверные GPU (Volta V100) имеют шесть таких соединений, тогда как потребительские GPU (RTX 2080 Ti) — только одно, работающее на сниженной скорости 100 Гбит/с. Мы рекомендуем использовать NCCL для обеспечения высокой скорости передачи данных между GPU.
13.4.7. Ещё числа задержек
Сводка в Table 13.4.1 и Table 13.4.2 взята из работы Элиота Эшлмана, который поддерживает обновлённую версию этих чисел в виде GitHub gist.
Действие |
Время |
Примечания |
|---|---|---|
Обращение/попадание в кэш L1 |
1,5 нс |
4 цикла |
Сложение/умножение/FMA с плавающей запятой |
1,5 нс |
4 цикла |
Обращение/попадание в кэш L2 |
5 нс |
12 ~ 17 циклов |
Ошибка предсказания ветвления |
6 нс |
15 ~ 20 циклов |
Обращение к кэш-памяти L3 (необщий кэш) |
16 нс |
42 такта |
Попадание в кэш L3 (общий с другим ядром) |
25 нс |
65 циклов |
Блокировка/разблокировка мьютекса |
25 нс |
|
Обращение к кэшу L3 (модифицировано в другом ядре) |
29 нс |
75 циклов |
Обращение к кэшу L3 (на удалённом сокете процессора) |
40 нс |
100 ~ 300 циклов (40 ~ 116 нс) |
Переход по QPI к другому процессору (за один переход) |
40 нс |
|
Обращение к памяти объёмом 64 МБ (локальный ЦП) |
46 нс |
Тест TinyMemBench на процессоре Broadwell E5-2690v4 |
Обращение к памяти объёмом 64 МБ (удаленный ЦП) |
70 нс |
Тест TinyMemBench на процессоре Broadwell E5-2690v4 |
256 МБ обращение к памяти (локальный ЦП) |
75 нс |
Тест TinyMemBench на процессоре Broadwell E5-2690v4 |
Случайная запись Intel Optane |
94 нс |
Лаборатория энергонезависимых систем UCSD |
256 МБ обращение к памяти (удалённый ЦП) |
120 нс |
Тест TinyMemBench на процессоре Broadwell E5-2690v4 |
Случайное чтение Intel Optane |
305 нс |
Лаборатория энергонезависимых систем UCSD |
Отправить 4 КБ по высокоскоростной сети HPC (100 Гбит/с) |
1 мкс |
MVAPICH2 поверх Intel Omni-Path |
Сжать 1 КБ с помощью Google Snappy |
3 мкс |
|
Передача 4 КБ по Ethernet со скоростью 10 Гбит/с |
10 мкс |
|
Запись 4 КБ случайных данных на NVMe SSD |
30 мкс |
DC P3608 NVMe SSD (QOS 99% — 500 мкс) |
Передача 1 МБ на GPU через NVLink и обратно |
30 мкс |
~33 ГБ/с на NVIDIA NVLink с 40 ГБ |
Передача 1 МБ на/с GPU через PCI-E |
80 мкс |
~12 ГБ/с на шине PCIe 3.0 x16 |
Чтение 4 КБ случайным образом с NVMe SSD |
120 мкс |
DC P3608 NVMe SSD (QOS 99%) |
Чтение 1 МБ последовательно с NVMe SSD |
208 мкс |
~4,8 ГБ/с DC P3608 NVMe SSD |
Запись 4 КБ случайных данных на SATA SSD |
500 мкс |
DC S3510 SATA SSD (QOS 99.9%) |
Чтение 4 КБ случайных данных с SATA SSD |
500 мкс |
DC S3510 SATA SSD (QOS 99.9%) |
Время кругового пути в пределах одного дата-центра |
500 мкс |
Односторонний пинг занимает ~250 мкс |
Чтение 1 МБ последовательно с SATA SSD |
2 мс |
~550 МБ/с DC S3510 SATA SSD |
Чтение 1 МБ с диска последовательно |
5 мс |
~200 МБ/с серверный жёсткий диск |
Случайный доступ к диску (поиск + вращение) |
10 мс |
|
Отправка пакета CA->Нидерланды->CA |
150 мс |
Действие |
Время |
Примечания |
|---|---|---|
Доступ к разделяемой памяти GPU |
30 нс |
30–90 циклов (конфликты банков добавляют задержку) |
Доступ к глобальной памяти GPU |
200 нс |
200~800 тактов |
Запуск ядра CUDA на GPU |
10 мкс |
Процессор хоста (CPU) инструктирует графический процессор (GPU) запустить ядро |
Передача 1 МБ на GPU через NVLink и обратно |
30 мкс |
~33 ГБ/с на NVIDIA NVLink с 40 ГБ |
Передача 1 МБ на/с GPU через PCI-E |
80 мкс |
~12 ГБ/с на шине PCI-Express x16 |
13.4.8. Итоги
Устройства несут накладные расходы на выполнение операций. Поэтому важно стремиться к меньшему количеству крупных передач данных вместо множества мелких. Это относится к оперативной памяти, SSD-накопителям, сетям и графическим процессорам.
Векторизация — это ключ к производительности. Убедитесь, что вы учитываете специфические возможности вашего ускорителя. Например, некоторые процессоры Intel Xeon особенно хорошо справляются с операциями INT8, графические процессоры NVIDIA Volta отлично подходят для матрично-матричных операций FP16, а архитектура NVIDIA Turing выделяется эффективностью при выполнении операций FP16, INT8 и INT4.
Числовое переполнение из-за малых типов данных может стать проблемой во время обучения (и в меньшей степени — во время вывода).
Алиасинг может существенно снизить производительность. Например, выравнивание памяти на 64-битных процессорах должно выполняться относительно 64-битных границ. На графических процессорах рекомендуется сохранять выравнивание размеров свёртки, например, относительно тензорных ядер.
Подбирайте алгоритмы под аппаратное обеспечение (например, с учётом объёма используемой памяти и пропускной способности). Значительное ускорение (на несколько порядков) можно достичь, если параметры помещаются в кэш.
Мы рекомендуем сначала набросать на бумаге ожидаемую производительность нового алгоритма, прежде чем проверять экспериментальные результаты. Расхождения на порядок величины и более являются поводом для беспокойства.
Используйте профилировщики для отладки узких мест производительности.
Аппаратное обеспечение для обучения и вывода имеет разные оптимальные точки с точки зрения цены и производительности.
13.4.9. Упражнения
Напишите программу на C, чтобы проверить, есть ли разница в скорости доступа к памяти, выровненной или невыровненной относительно внешнего интерфейса памяти. Подсказка: будьте осторожны с эффектами кэширования.
Проверьте разницу в скорости доступа к памяти при последовательном чтении и чтении с заданным шагом.
Как можно измерить размеры кэша процессора?
Как бы вы организовали распределение данных по нескольким каналам памяти для обеспечения максимальной пропускной способности? Как бы вы изменили это распределение, если бы у вас было много мелких потоков?
Жёсткий диск корпоративного класса вращается со скоростью 10 000 об/мин. Каково абсолютно минимальное время, которое жёсткому диску необходимо потратить в наихудшем случае, прежде чем он сможет считать данные (можно предположить, что головки перемещаются практически мгновенно)? Почему жёсткие диски форм-фактора 2,5 дюйма становятся популярными для коммерческих серверов (по сравнению с дисками 3,5 и 5,25 дюйма)?
Предположим, что производитель жёстких дисков увеличивает плотность записи с 1 Тбит на квадратный дюйм до 5 Тбит на квадратный дюйм. Сколько информации можно записать на кольцо на жёстком диске размером 2,5 дюйма? Есть ли разница между внутренней и внешней дорожками?
Переход от 8-битных к 16-битным типам данных увеличивает площадь кремния примерно в четыре раза. Почему? Почему NVIDIA могла добавить операции INT4 в свои графические процессоры архитектуры Turing?
Во сколько раз быстрее читать данные по памяти в прямом порядке, чем в обратном? Зависит ли это число от конкретного компьютера и производителя процессора? Почему? Напишите код на C и проведите эксперимент.
Можете ли вы измерить размер кэша вашего диска? Каков он для типичного жёсткого диска? Нужен ли кэш для SSD?
Измерьте накладные расходы на передачу пакетов при отправке сообщений через Ethernet. Изучите различия между протоколами UDP и TCP/IP.
Прямой доступ к памяти позволяет устройствам, отличным от ЦП, напрямую записывать (и считывать) данные в (из) память. Почему это хорошая идея?
Рассмотрите показатели производительности графического процессора Turing T4. Почему производительность «лишь» удваивается при переходе от FP16 к INT8 и INT4?
Каково минимальное время, необходимое для прохождения пакета туда и обратно между Сан-Франциско и Амстердамом? Подсказка: можно считать, что расстояние составляет 10 000 км.